
Ep15 到 Ep17 把 Standalone cluster 裡的角色、task 與資料位置拆開觀察。到這裡,其實還缺少一個真正會影響 production job 的情境:一個 task 還在跑,承載它的 Executor 突然消失時,application 會立刻失敗嗎?Driver、Master 與剩下的 Executor 又各自做了什麼?
這次我用兩個 Worker 建立一個可控制的中斷:四個 task 正在執行時,手動停止其中一個 Worker。實驗資料很小,刻意讓 task 停留足夠久,目的是把「資源消失」到「同一份工作重跑完成」的路徑留在 Spark UI 裡。
Ep15:誰提供資源?
Master、Worker、Driver、Executor 分別在哪裡
        ↓
Ep16:task 如何被送到 Executor?
Driver 將 task 排到 Executor 的 task slots
        ↓
Ep17:task 處理的資料在哪裡?
input、shuffle、cache 分別落在哪裡
        ↓
Ep18:承載 task 的 Executor 消失時怎麼辦?
Driver 將未完成的 partition 以新的 attempt 重新排程
本集聚焦 application 執行期間失去一個 Worker/Executor 的情境。Master 高可用、Driver 遺失、dynamic allocation、cache block 遺失、external shuffle service 與記憶體 spill 都有各自的恢復模型,留在後續合適的主題處理。
先把四個名詞放在同一條事件路徑上。Worker 是提供 CPU 與 memory 的常駐 process;Executor 是某個 application 在 Worker 上取得資源後啟動的 process;task attempt 是「執行某個 partition 的一次嘗試」。
一個 running task 所在的 Worker 停止
        ↓
Master 偵測 Worker 離線,該 Worker 上的 Executor 隨之遺失
        ↓
Driver 收到 Executor lost,標記其尚未完成的 task attempts 為失敗
        ↓
Driver 保留同一個 partition 的工作需求,建立新的 task attempts
        ↓
存活或新取得的 Executor 執行這些 attempts
        ↓
每個 partition 都有一個成功結果後,stage 與 application 才能完成
這條路徑有兩組關係,和 Ep15 的角色地圖一致:
Master 沒有保存 task 的計算進度,也不會接手重跑 task。Driver 才是知道「partition 0 還沒有成功完成」的一方。Worker 停止時,裡面的 Executor process 一起終止;已經執行到一半的 task 也就沒有可延續的 process。
四種狀態分屬不同層級,先分清楚才能正確判讀 UI 與 log:
| 名詞 | 這次實驗中的意思 | 對 application 的直接影響 |
|---|---|---|
| Worker lost | 提供資源的 Worker daemon 與 Master 失去連線,Master 將它標為 DEAD。 |
該 Worker 上能提供給 application 的資源消失。 |
| Executor lost | application 位於該 Worker 的 Executor process 隨 Worker 停止而消失。 | Executor 上正在跑的 task attempts 無法繼續。 |
| task attempt failure | 某一次執行 partition 的嘗試沒有產生成功結果。本次 partition 0、2 的 attempt 0 因 ExecutorLostFailure 結束。 |
Driver 仍可為同一個 partition 建立新的 attempt。 |
| application failure | Driver 判定 stage 已無法得到所需的成功 partition 結果,因而讓整個 application 結束為 failed。 | Job 不再繼續;需要從失敗原因、資源與資料可重建性進一步排查。 |
這是一條由底向上的影響鏈:Worker lost 造成 Executor lost,Executor lost 讓正在執行的 task attempts 失敗。只要 Driver 仍能重試並補齊成功結果,application 會繼續保持 running;重試條件無法滿足時,才會走到 application failure。
Spark 恢復的是邏輯上的 partition 工作:失去一個 Executor 後,Driver 讓同一個 partition 在可用 Executor 上重新執行一個新的 attempt。
task、task attempt 與 partition:4 個 partitions 為什麼會產生 6 次執行?一個 stage 對每個 input partition 需要一個成功的 task 結果。本次 stage 有 4 個 partitions,因此一開始提交 4 個 task attempts。兩個 Workers 各有一個 2-core Executor,剛好同時容納四個 tasks:每個 Executor 執行兩個。
當 Executor 1 消失時,它承載的 partition 0、2 都還沒完成。Spark 將原先的 attempts 記為 0.0、2.0 失敗,並在剩下的 Executor 上建立 0.1、2.1:前面的數字是 partition ID,後面的數字是 attempt number。
partition 0:attempt 0 → Executor 1 遺失時失敗
             attempt 1 → Executor 0 成功

partition 1:attempt 0 → Executor 0 成功

partition 2:attempt 0 → Executor 1 遺失時失敗
             attempt 1 → Executor 0 成功

partition 3:attempt 0 → Executor 0 成功
這個 stage 總共發生 6 次 task attempts,卻仍只處理 4 個 logical partitions。stage 的完成條件是取得四個 partition 各一份成功結果;兩筆失敗的舊 attempts 則是這段執行歷程的一部分。後面看到 Driver UI 的 Tasks 表與 Event Timeline 時,會直接用這個對照讀出六筆紀錄。
這個差別也帶出一個實務提醒:task 的程式可能被執行超過一次。純轉換與 count() 這類沒有外部副作用的工作可以安全重跑。本次來源是可重新建立的 spark.range,重新執行只會再計算同一段資料。若 task 同時呼叫外部 API、寫入非交易式資料庫或送出訊息,重試可能使同一個邏輯工作產生重複副作用;此類輸出需要 idempotent 設計或可靠的 commit 機制。
這個實驗沿用兩個 Worker 的 Standalone cluster。每個 Worker 提供一個 2-core、1024 MiB 的 Executor;application 共取得 4 個 task slots。程式建立 4 個 spark.range partitions,並在每個 partition 的 mapPartitions 內暫停:初始 attempt 暫停 240 秒,retry attempt 只暫停 15 秒。
import time

from pyspark import TaskContext


def hold_partition(rows):
    context = TaskContext.get()
    hold_seconds = 240 if context.attemptNumber() == 0 else 15
    print(
        f"partition={context.partitionId()} "
        f"attempt={context.attemptNumber()}"
    )
    time.sleep(hold_seconds)
    yield from rows


row_count = (
    spark.range(0, 40_000, numPartitions=4)
    .rdd.mapPartitions(hold_partition)
    .count()
)
停留時間只服務觀察:它讓我可以在所有 task 還活著時截取 UI,再用受控方式停止 Worker 1。真正的計算很單純,四個 partitions 的正確總數是 40,000;這讓結果是否恢復成功容易判斷。
Master UI 顯示 2 個 Alive Workers,application 使用 4 cores 與 2 GiB memory。每個 Worker 的 2 cores 都被自己的 Executor 使用,對應四個同時 running 的 task attempts。
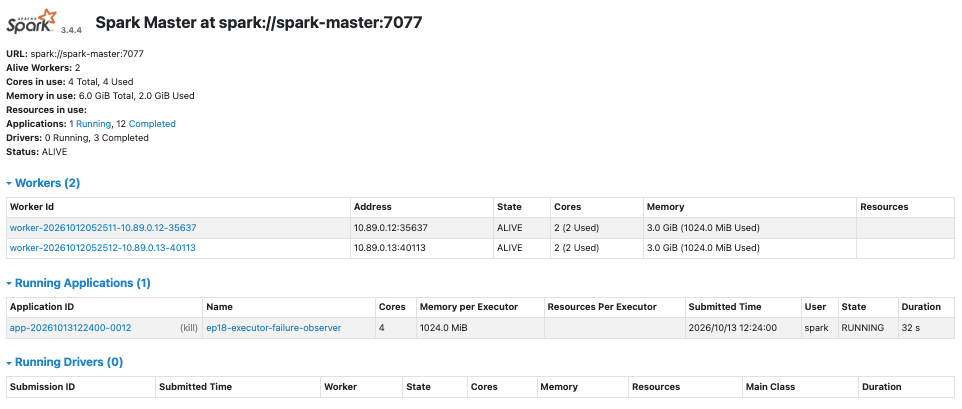
本次採 client mode,所以 Master UI 的 Running Drivers 是 0;Driver 仍在提交端 container 內運作,並由 http://localhost:4040 的 application UI 顯示。這個 0 表示 Master 沒有替它啟動 cluster-mode Driver,並不表示 application 缺少 Driver。
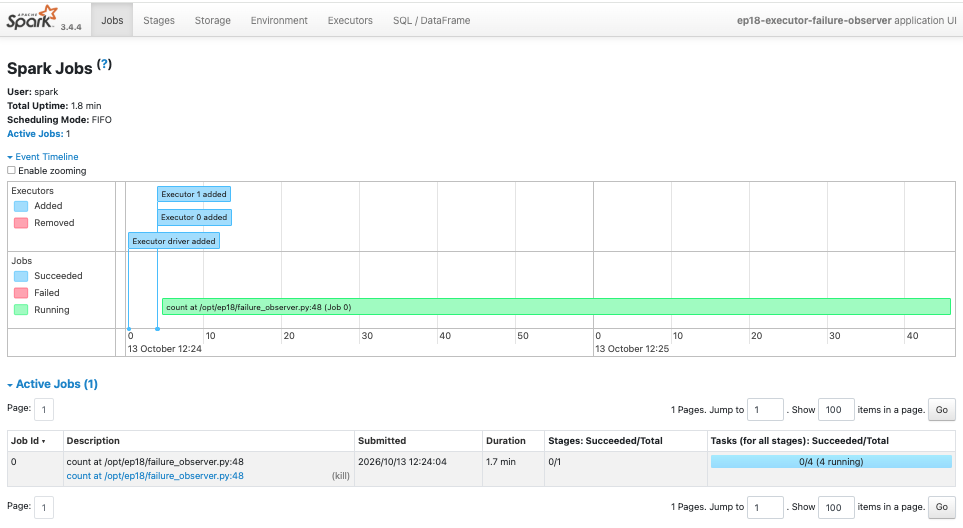
Driver UI 的 Jobs 頁則顯示一個 running Job,0/4 (4 running) 直接對應四個尚未完成的 partitions。
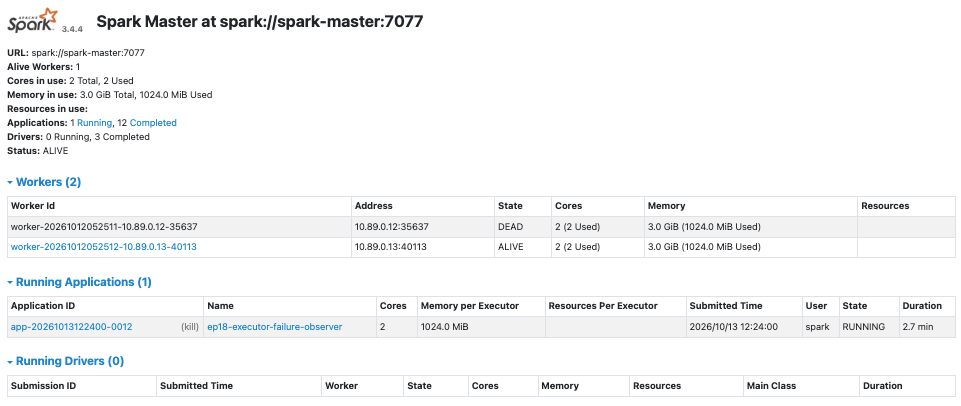
當我停止 Worker 1 後,Master UI 將它標為 DEAD。畫面仍列出兩個 Worker ID,是為了保留已離線 Worker 的紀錄;Alive Workers 已經從 2 變成 1,可用資源也只剩存活 Worker 的 2 cores 與 1024 MiB。
Driver log 同時留下了三件依序發生的事:
Executor .../1 removed: worker lost
task 2.0 ... failed because ... its executor exited
task 0.0 ... failed because ... its executor exited
這兩筆失敗的原因是 ExecutorLostFailure:task 本身沒有回傳錯誤,執行它的環境消失了。Spark 對此類失敗保留 task retry 的機會;log 也會說明它不計入 task 的一般失敗次數。application 此時仍是 RUNNING,因為 Driver 還活著,並且 cluster 裡仍有 Executor 能接手工作。
Worker 2 上的 Executor 0 先完成自己原本的 partition 1、3。兩個 core 空出來後,Driver 立刻將 partition 0、2 的新 attempts 排到這個 Executor。Event Timeline 與 Tasks 表完整保留了這個接棒過程。
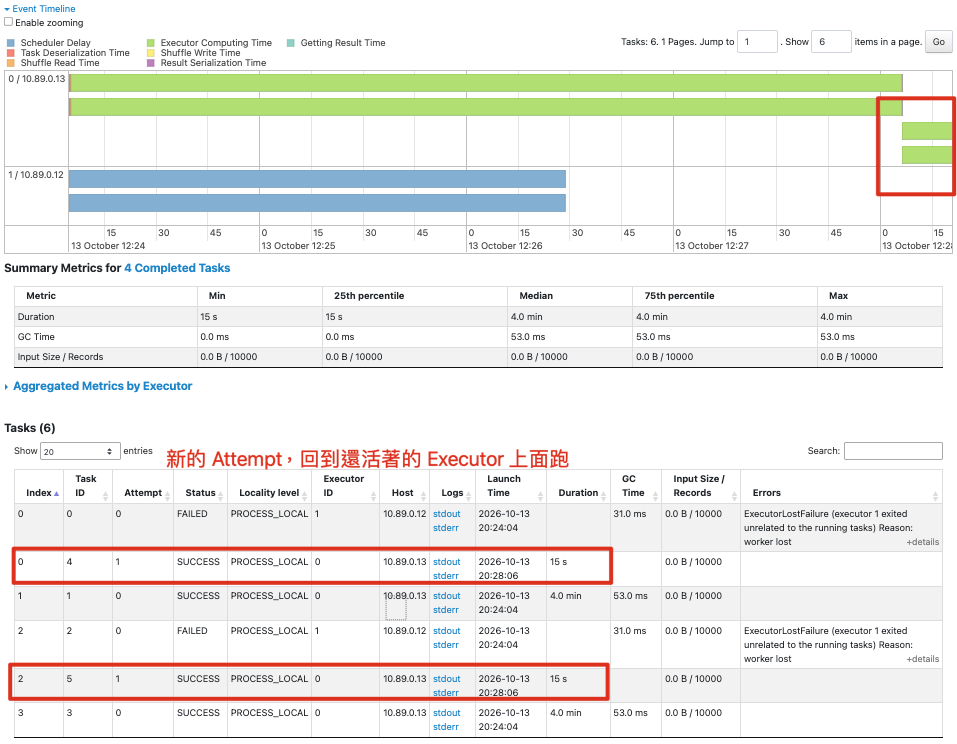
這張圖中的 6 筆紀錄,正好對應前面列出的 4 個 partitions 與 6 次 attempts,可分成三組:
| task attempts | Executor/host | 結果 | 代表意義 |
|---|---|---|---|
| partition 0、2 的 attempt 0 | Executor 1/Worker 1 | failed | Worker 停止時,執行中的 attempts 失去 Executor。 |
| partition 1、3 的 attempt 0 | Executor 0/Worker 2 | success | 存活 Executor 原先執行的工作照常完成。 |
| partition 0、2 的 attempt 1 | Executor 0/Worker 2 | success | Driver 以相同 partition、新 attempt 重派工作。 |
最後程式輸出 Recovered application completed: 40,000 rows。這份正確結果與 task table 一起證明 stage 沒有因兩個 attempts 失敗而放棄;它等待的是每個 partition 的成功結果。
task retry 有清楚的恢復邊界。這次能成功,有幾個前提:
spark.range 是可由 lineage 重新建立的來源,partition 0、2 可安全從頭執行。真正的 pipeline 若遺失了尚未持久化的 shuffle output,Driver 可能還需要重跑上游 stage 來補回資料;cache blocks、外部資料來源與輸出端的語意也會改變恢復成本和做法。本實驗只有一個沒有 shuffle 的 stage,因此畫面精準呈現的是「running task 的 retry」。它沒有宣稱所有資料遺失都只要重跑兩個 tasks;後續遇到 shuffle、cache、輸出寫入或 Driver 自身失效時,需要先辨認遺失的是哪個元件與哪份資料。
Executor 遺失不會自動等同 application 失敗。Driver 仍存活、仍有資源、且工作可重建時,Spark 能以新的 task attempts 補齊缺少的 partition 結果。
| 先看哪裡 | 要確認的訊號 | 這次看到的事實 |
|---|---|---|
| Master UI | Worker 是否變成 DEAD、可用 cores/memory 是否下降 |
2 個 Alive Workers 變成 1;application 從 4 cores 降為使用 2 cores。 |
| Driver UI 的 Executors tab/logs | 哪個 Executor 被移除、原因是什麼 | Executor 1 顯示 worker lost。 |
| Driver UI 的 Stage Tasks | 哪些 partition 的 attempts 失敗、是否已有新的 attempt | partition 0、2 由 attempt 0 失敗後變成 attempt 1。 |
| Event Timeline | retry 最後跑到哪個 host、何時完成 | 兩個 retry 都移到 Worker 2 的 Executor 0 並成功。 |
| Job 結果 | 每個 partition 是否最終成功、application 是否完成 | 4 個 partitions 都成功,count() 回傳 40,000。 |
這次實驗把「容錯」拆成可觀察的事件:Worker 消失時,Master 回報資源變化;Driver 依自己持有的 stage 與 task 狀態,找出還缺成功結果的 partitions;Executor 則實際重新計算那些 partitions。每個角色都只處理自己的責任,合起來才讓 application 有機會繼續跑完。
Standalone cluster 的四集到這裡形成一個完整的起點:我已經能把 application 的角色、task、資料位置與最基本的 task retry 放在同一張執行地圖上。下一段會把同一張地圖帶到 YARN 與 Kubernetes,看看 cluster manager 改變後,Driver 取得與管理資源的方式如何對應到這些熟悉的概念。
🚀 GitHub:
Ep18|Executor 消失時,Spark 怎麼繼續跑?
🚀 spark-learning-lab 系列文章與實作:
https://github.com/jeffery5bai/spark-learning-lab

 jeffery5bai

 iThome鐵人賽
 看影片追技術