
看到 Spark UI 的 GC time、Memory Spill 或 Disk Spill,很容易直接得到「Executor memory 不夠,所以加大 memory」的結論。不過這幾個數字描述的是不同層次的現象:GC 是 JVM 回收物件所花的時間;spill 是 Spark 將暫時放不下的中間資料寫到 local disk;真正的 OOM 則還需要 Executor lost、process exit code 與 logs 才能確認。
這一集建立一個受控的 sort-based shuffle。在不製造 key skew、也不讓 Executor OOM 的前提下,刻意縮小 Spark 可用的 execution memory,讓 map-side sorter 將中間資料 spill 到磁碟。重點是從 Stage metrics 判讀:資料在哪一側 spill、spill 的量級如何和 shuffle、GC 對照,以及哪些證據仍不足以下結論。
Ep22:Jobs → Stages → Tasks → Executors
先建立 Spark UI 的診斷順序
        ↓
Ep23:data skew
少數 task 因資料不均而拖住 Stage
        ↓
Ep24:join strategy
join 如何決定 shuffle 的資料移動
        ↓
Ep25:small files
scan task 為何可能多到讓排程成本浮現
        ↓
Ep26:memory 與 spill
中間資料放不下時,從 Stage metrics 判讀 Spark 的處理方式
本篇的 spill 是刻意製造的可觀察訊號,不是 production workload 的建議設定,更不是 OOM 重現流程。真實 job 出現記憶體問題時,仍要先確認資料量、partition、資料傾斜、cache、同時執行的工作與平台 memory limit。
spill 不一定是錯誤;Spark 特意用它避免中間資料一放不下就讓 task 失敗。但 spill 會改變 task 的成本:原本留在記憶體中的資料,需要寫到 local disk,後續還可能再讀取與合併。當這件事反覆發生,sort、aggregation 或 shuffle-heavy join 的 task duration 可能被 disk I/O 與額外處理拉長。
sort/aggregation/join 產生中間資料
        ↓
資料超過當下可用的 execution memory
        ↓
Spark spill 到 Executor local disk
        ↓
額外的 disk I/O、讀取與合併
        ↓
task duration 拉長,最後可能拖慢整個 Stage
因此,Memory Spill 的價值不是提供一個「heap 不夠」的單一答案,而是幫助定位排查方向:哪個 Stage 的哪批 tasks 正在承受中間資料壓力?它是所有 tasks 都有的共同成本,還是只集中在少數大 partition?再將它和 Shuffle Read/Write、GC Time、task duration 及 Executor logs 放在一起,才能決定下一步該檢查 query 是否產生過大的中間資料、partition 是否不均、cache 是否擠壓 execution memory,或平台是否真的需要更多 memory。
spill 是「資料開始需要借用磁碟」的訊號;它讓效能診斷從猜測 memory 設定,轉向定位哪個資料處理步驟正在付出額外成本。
本次資料有 2,400,000 個 key-value records,key 均勻分布;每個 value 帶有隨 record 改變的 128-byte binary payload。它讓中間資料有足夠體積,且不會被重複內容大幅壓縮。接著以 sortByKey(8) 建立一個明確的 shuffle 邊界:
2,400,000 個均勻 key-value records
        ↓ sortByKey(8)
8 個 map tasks:依 key 排序並寫出 shuffle blocks
        ↓ execution memory 不足以容納 sorter working set
map-side sorter spill 到 Executor 的 local disk
        ↓
8 個 reduce tasks:讀取對應 shuffle blocks
        ↓
每個 partition 回傳一個小 summary 給 Driver
實驗使用兩個 Standalone Executors,各有 2 cores、512 MiB heap,因此 application 最多有四個 task slots。下列設定用來讓 spill 路徑穩定出現:
spark.executor.memory=512m
spark.memory.fraction=0.1
spark.shuffle.sort.bypassMergeThreshold=0
spark.shuffle.compress=false
spark.shuffle.spill.compress=false
這組條件讓 Spark 比平常更容易把中間資料寫到磁碟。可以把 Executor 想成一張工作桌:shuffle 在整理、排序資料時,會先把中間資料放在桌面上;桌面放不下,才把其中一部分暫放到旁邊的 local disk。
spark.shuffle.sort.bypassMergeThreshold=0 要求這次 shuffle 走「先整理、排序資料,再寫出」的路徑,讓 sorter 成為可以觀察的對象。spark.memory.fraction=0.1 則刻意縮小 Spark 可用來暫放這些資料的工作桌。當排序資料超過這塊 execution memory,Spark 會先將部分資料寫到 Executor 的 local disk,於是 UI 才會留下 spill metrics。
實驗也關閉 shuffle 與 spill compression。原本 Spark 可能壓縮寫出的資料,讓磁碟上的 bytes 比實際處理的資料小;關掉壓縮後,UI 中的 Disk Spill 與 Shuffle Write 較容易互相對照。代價是資料更大、I/O 可能更慢。
這些都是為了教學觀察而設計的實驗開關。特別是 memory.fraction=0.1 和關閉 compression,不能直接當成 production 的通用調校方式;正式環境仍要依資料量、可用記憶體、磁碟與網路成本評估。
spill 表示 Spark 選擇把中間資料移到 local disk,保住 task 可以繼續執行;它不是 OOM 的同義詞。
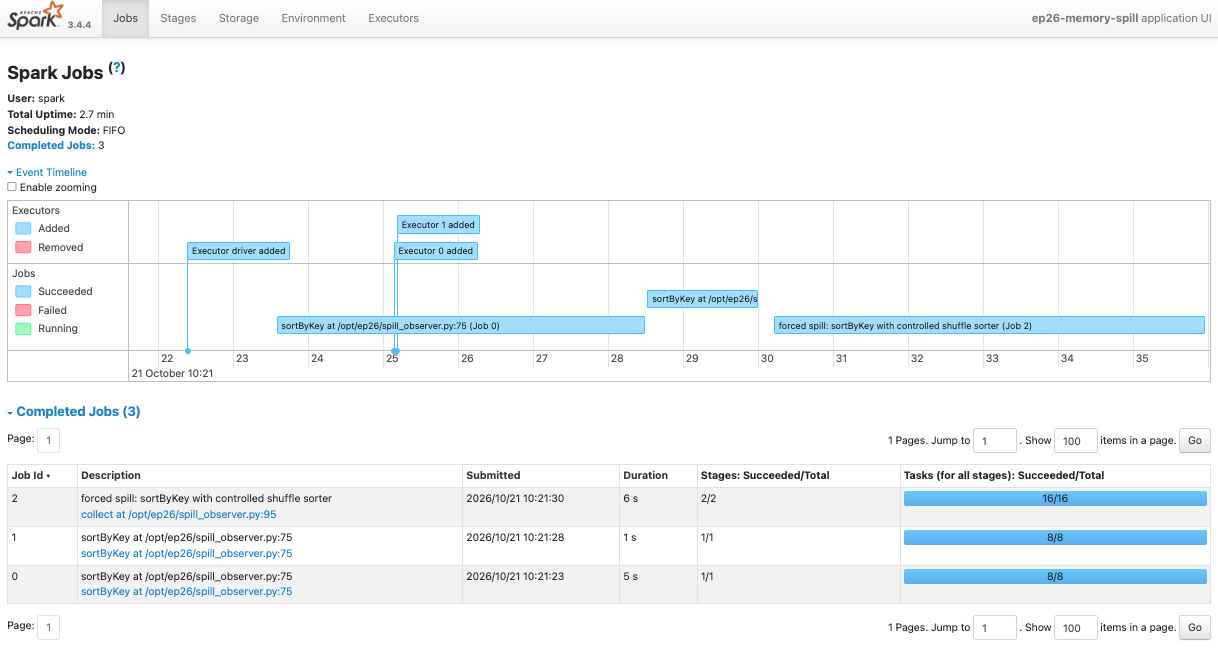
Jobs 頁有三個 completed Jobs。要查看的是描述為 forced spill: sortByKey with controlled shuffle sorter 的 Job 2:它有兩個 Stages、16 個 tasks,duration 為 6 秒。
Job details 將這次工作切為兩個 Stages。Stage 2 有八個 tasks、寫出 315.8 MiB Shuffle Write;Stage 3 也有八個 tasks、讀回相同的 315.8 MiB Shuffle Read。兩者的數字接得起來,先證明這是一條完整的 shuffle 資料路徑。
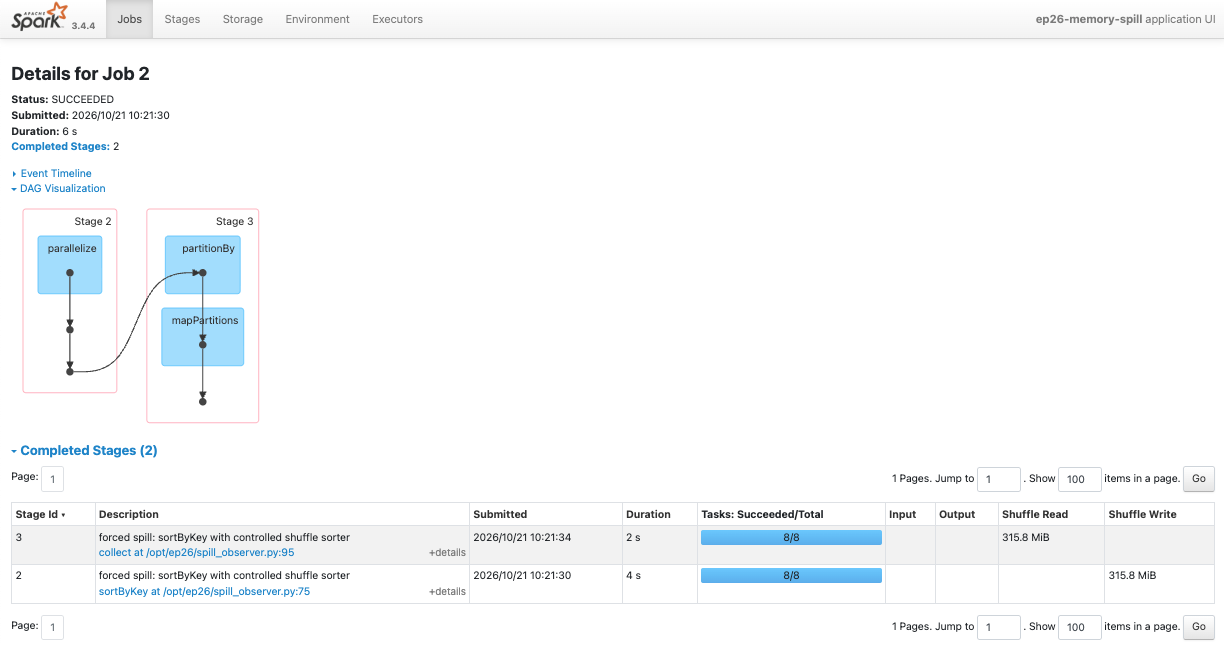
這張圖只說明資料跨 Stage 移動了多少,還沒有說明它是否造成 memory 壓力。spill 是 task metrics,必須繼續查看 Stage details,不能只用 Job duration 判定。
Stage 2 是 map-side shuffle writer。頁面頂端直接列出總量:Shuffle Write 315.8 MiB、Spill (Memory) 298.3 MiB、Spill (Disk) 315.8 MiB。這表示八個 map tasks 在整理、排序並輸出 shuffle blocks 的過程中,確實曾將中間資料移出記憶體並寫入 local disk。
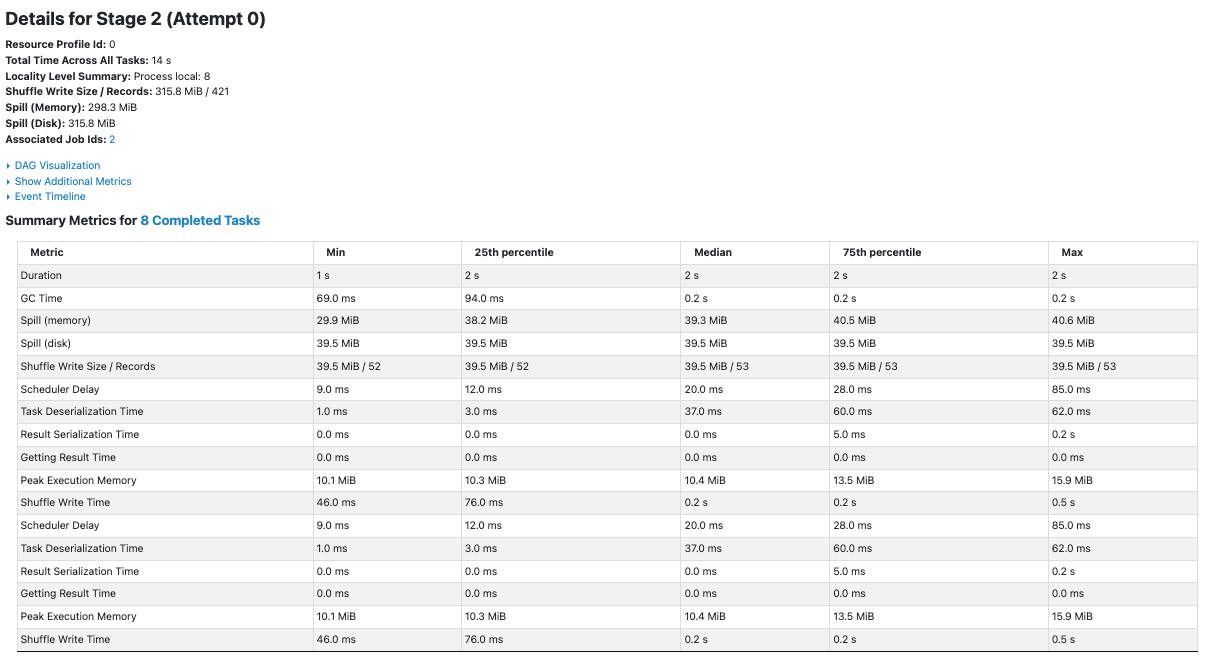
Summary Metrics 顯示各 task 的分布,而不只是一個總計:
| 指標 | 本次中位數 | 它說明什麼 |
|---|---|---|
| Spill (Memory) | 39.3 MiB |
每個 map task 約有這個量級的中間資料需要從記憶體管理路徑 spill。 |
| Spill (Disk) | 39.5 MiB |
spill 後落在 Executor local disk 的資料量。 |
| Shuffle Write Size | 39.5 MiB |
每個 map task 寫出的 shuffle 資料量,和 disk spill 的量級相近。 |
| GC Time | 0.2 s |
JVM 回收占 task 時間的一部分,但本身不足以解釋所有耗時。 |
| Duration | 2 s |
這是單一 task 的 wall-clock duration;要和資料量、GC 與 spill 一起閱讀。 |
Memory Spill 和 Disk Spill 不必期待永遠完全相同。它們分別記錄 Spark 從記憶體處理路徑溢出的量,以及實際寫入 disk 的量;序列化、資料結構與 spill 過程都可能讓數字不同。本次因為關閉了壓縮,兩者與 Shuffle Write 的量級特別接近,方便建立直覺,卻不是一般環境必然會有的比例。
另一個容易誤讀的欄位是 Peak Execution Memory。本次 task 的中位數是 10.4 MiB,遠小於 spill 統計。它不是「Executor 已使用多少 heap」的完整儀表,而是 Spark task execution-memory 管理中的 peak 值;不能拿它單獨與 512 MiB heap 相減,推算 application 還剩多少記憶體。
Stage 3 的八個 tasks 讀回 315.8 MiB Shuffle Read;task 中位數讀取約 41.3 MiB,GC Time 中位數為 64 ms。但這一頁沒有 Stage 2 的 Spill (Memory) 與 Spill (Disk) 指標:這次 reduce-side 的兩項 spill 都是 0 B。
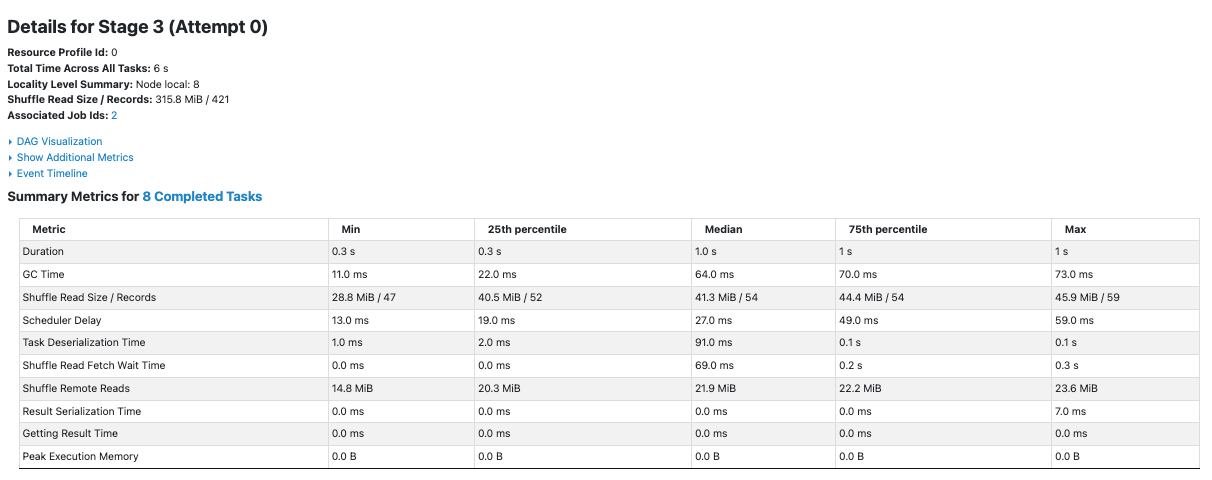
這個對照很有價值。前一個 Stage 的 sort-based writer 因受控 execution memory 壓力而 spill;下游 Stage 雖然讀了同樣量級的資料,這次卻不需要走相同的 spill 路徑。不能因為一個 Job 有大量 Shuffle Read,就直接推論所有 Stages 都有 memory pressure。
同樣地,這也不代表 reduce-side 永遠不會 spill。不同的 reducer 數、單一 partition 大小、排序、aggregation、join、資料傾斜與可用 memory,都可能改變結果。Spark UI 的正確用法是看每個 Stage/task 真正留下的 metrics,而不是把 map-side 的現象套到整個 application。
| 看到的證據 | 它表示的風險或方向 | 下一步應蒐集的證據 |
|---|---|---|
| Memory Spill、Disk Spill 大於 0 | Spark 的中間資料超過當下可用 execution memory,已增加 local-disk I/O 成本。 | 對照 task duration、Shuffle Read/Write 與 GC;再回到 DAG 找出造成中間資料的 sort、aggregation 或 join。 |
| GC Time 相對 task duration 很高 | JVM 記憶體管理可能占去顯著工作時間。 | 比對 task data size、spill、cache 與 Executor logs,確認壓力是來自資料、快取或其他 JVM 配置。 |
| 少數 task 的 spill、資料量與 duration 明顯較高 | 特定 partition 承受較多資料,可能形成 straggler。 | 檢查 partition records、join key 或 group key 分布;必要時回看 Ep23 的 skew 診斷。 |
Executor lost、container exit、OutOfMemoryError 或平台 OOM 訊號 |
process 或 container/pod 的 memory limit 可能被觸發,application 穩定性已受影響。 | 查看 Executor logs、exit code、memory overhead 與平台事件,確認是 JVM heap、非 heap/Python memory,還是 container limit。 |
當真實 application 出現 memory 症狀,先從慢 Job 的 Stage details 比對 task data size、spill、GC 與 duration 是否集中;接著回到 DAG 確認是 sort、aggregation、join 或 cache 產生了中間資料;最後查看 Executor logs 與 Standalone/YARN/Kubernetes 平台的終止原因。這條順序能避免只看見「memory」就先調大 heap,卻漏掉 skew 或不合理 partition 的根因。
先確認哪個 Stage、哪些 tasks 真的 spill,再決定要盤查資料形狀、partition、cache、Executor memory,還是平台層的 OOM 證據。
這次我真正學到,Memory Spill 不是「Spark 壞掉了」或「立刻把 Executor memory 調大」的指令。它首先告訴我:某個 task 的中間資料已經無法完全留在當下可用的 execution memory,開始需要借用 local disk。這是 Spark 保住 task 能繼續執行的機制,也是一筆可能拖慢 job 的額外 I/O 成本。
我也學到不能把一個 Job 當成單一記憶體狀態。本次 Stage 2 寫出 315.8 MiB shuffle,並留下 298.3 MiB Memory Spill 與 315.8 MiB Disk Spill;Stage 3 讀回相同資料量,卻沒有再次 spill。真正需要看的單位是 Stage 與 task:spill 是集中在寫 shuffle 的一側、集中在少數大 partition,還是所有 tasks 都同時承受壓力?
因此,實務上的下一步不是直接猜設定,而是先用 Spark UI 定位 spill、shuffle、GC 與 duration 的關係,再回到 DAG 和資料檢查造成中間資料的 sort、aggregation、join、cache 或資料分布。只有 Executor lost、OOM log 或平台終止訊號出現時,才能進一步將問題收斂到 process 或 container 的記憶體邊界。
🚀 GitHub:\
Ep26|Executor 記憶體吃緊時,Spark 怎麼把資料 spill 到磁碟?從 Stage metrics 看 memory、disk 與 GC
🚀 spark-learning-lab 系列文章與實作:\
https://github.com/jeffery5bai/spark-learning-lab
Apache Spark 3.4.4 — Tuning Guide:\
https://archive.apache.org/dist/spark/docs/3.4.4/tuning.html
Apache Spark 3.4.4 — Web UI:\
https://archive.apache.org/dist/spark/docs/3.4.4/web-ui.html
Apache Spark 3.4.4 — Configuration:\
https://archive.apache.org/dist/spark/docs/3.4.4/configuration.html

 jeffery5bai

 iThome鐵人賽
 看影片追技術