
一、前言
在前幾天的學習中,我們已經完成健康習慣追蹤系統的基本功能整合,也透過測試資料確認系統能夠正常新增、儲存及查詢健康紀錄。
然而,健康紀錄的價值不只是保存每天的數據,更重要的是透過長期累積的資料,觀察自己的生活習慣是否有所改變。
例如,喝水量是否逐漸增加?睡眠時間是否穩定?運動頻率是否有所提升?不同習慣之間是否可能存在關聯?
因此,今天將進一步使用 Pandas 分析測試資料,透過平均值、趨勢變化與相關性分析,從原始紀錄中整理出更有意義的資訊。
二、今日學習目標
認識健康資料分析的基本概念。
使用 Pandas 整理不同日期的健康紀錄。
分析喝水量、睡眠時間與運動時間的變化。
比較不同日期的數據差異。
學習使用相關係數觀察變數之間的關聯。
將分析結果轉換成容易理解的資訊。
三、認識健康資料分析
健康資料分析是透過整理與比較已經收集的資料,了解個人生活習慣的變化。
以本專案為例,目前系統主要收集以下資料:
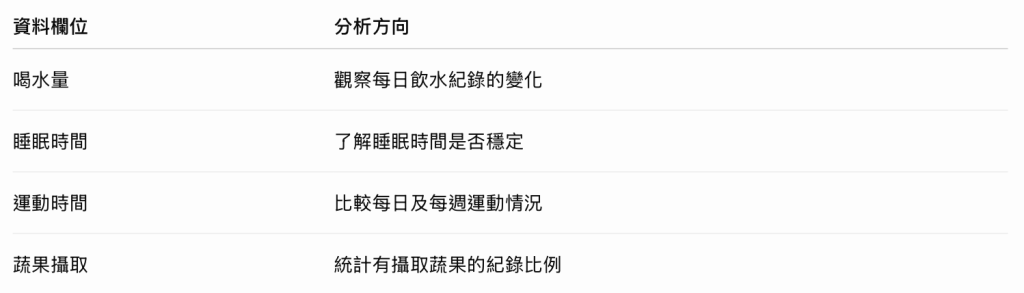
透過這些資料,可以從不同角度了解個人習慣,而不只是單純查看每天輸入的數值。
四、載入與整理健康測試資料
首先,使用 Pandas 讀取前一天建立的測試資料。
import pandas as pd
df = pd.read_csv("test_health_records.csv")
df["date"] = pd.to_datetime(
df["date"],
errors="coerce"
)
numeric_columns = [
"water_ml",
"sleep_hours",
"exercise_minutes"
]
for col in numeric_columns:
df[col] = pd.to_numeric(
df[col],
errors="coerce"
)
df = df.dropna(subset=["date"])
df = df.sort_values("date")
print(df)
這段程式會讀取 CSV,將日期轉換成日期格式,並將喝水量、睡眠時間及運動時間轉換成數值型態。
透過 sort_values(),可以按照日期由舊到新排列資料,方便後續觀察變化。
五、分析每日健康習慣變化
首先,觀察不同日期的喝水量。
water_data = df[
["date", "water_ml"]
].dropna()
print("平均喝水量:")
print(water_data["water_ml"].mean())
print("最高喝水量:")
print(water_data["water_ml"].max())
print("最低喝水量:")
print(water_data["water_ml"].min())
這裡使用三種常見的統計方式:
mean():計算平均值。
max():找出最大值。
min():找出最小值。
根據前一天建立的五筆測試資料:
平均喝水量為 1880 ml。
最高喝水量為 2200 ml。
最低喝水量為 1500 ml。
透過這些數值,可以快速了解測試期間的喝水量分布。
接著,觀察每日睡眠時間。
sleep_data = df[
["date", "sleep_hours"]
].dropna()
print("平均睡眠時間:")
print(sleep_data["sleep_hours"].mean())
print("最長睡眠時間:")
print(sleep_data["sleep_hours"].max())
print("最短睡眠時間:")
print(sleep_data["sleep_hours"].min())
根據測試資料,平均睡眠時間為 7 小時,最長為 8 小時,最短為 6 小時。
除了平均值之外,也可以比較每天的睡眠時間,觀察是否有明顯的波動。
最後,整理每日運動時間。
exercise_data = df[
["date", "exercise_minutes"]
].dropna()
print("總運動時間:")
print(exercise_data["exercise_minutes"].sum())
print("平均每日運動時間:")
print(exercise_data["exercise_minutes"].mean())
print("運動時間最多的一天:")
print(exercise_data.loc[
exercise_data["exercise_minutes"].idxmax()
])
其中:
sum():計算所有紀錄的運動時間總和。
mean():計算平均每日運動時間。
idxmax():找出運動時間最大值所在的資料位置。
依照五筆測試資料,總運動時間為 155 分鐘,平均每日運動時間為 31 分鐘。
六、觀察不同健康習慣的變化趨勢
除了計算平均值,也可以透過圖表觀察不同日期的變化。
import streamlit as st
st.subheader("喝水量變化")
water_chart = df.set_index("date")["water_ml"]
st.line_chart(water_chart)
st.subheader("睡眠時間變化")
sleep_chart = df.set_index("date")["sleep_hours"]
st.line_chart(sleep_chart)
st.subheader("運動時間變化")
exercise_chart = df.set_index("date")["exercise_minutes"]
st.bar_chart(exercise_chart)
這裡使用 Streamlit 的折線圖與長條圖呈現資料。
折線圖適合觀察喝水量與睡眠時間隨日期的變化;長條圖則可以比較不同日期的運動時間。
透過視覺化,使用者不需要逐筆閱讀數據,也能快速發現哪些日期的數值比較高或比較低。
七、觀察不同習慣之間的關聯
除了個別分析每一項健康習慣,也可以進一步觀察不同數據之間是否具有關聯。
例如,想了解睡眠時間與運動時間是否呈現某種共同變化,可以使用 Pandas 的 corr() 計算相關係數。
correlation = df[
[
"water_ml",
"sleep_hours",
"exercise_minutes"
]
].corr()
print("健康習慣相關係數:")
print(correlation)
相關係數的數值介於 -1 到 1: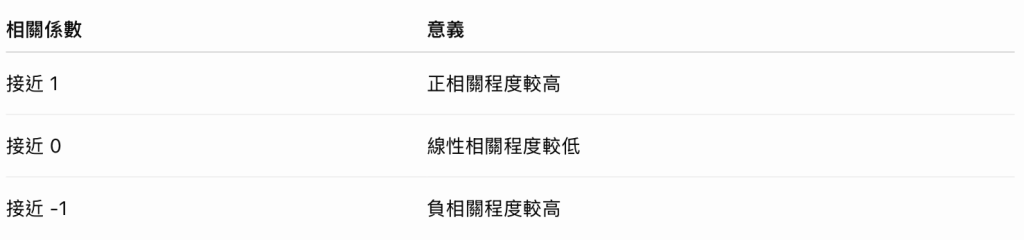
例如,如果睡眠時間與運動時間的相關係數接近 1,代表在這組資料中,兩者有較明顯的正向線性關聯。
不過,相關性不代表因果關係。即使兩項數據同時增加,也不能直接認定其中一項造成另一項改變。
另外,本次只有五筆測試資料,因此相關係數僅適合用來練習計算與理解概念,不能據此推論真實的健康習慣關係。
八、整理健康資料分析結果
完成上述分析後,可以將結果整理成一份簡單的統計表。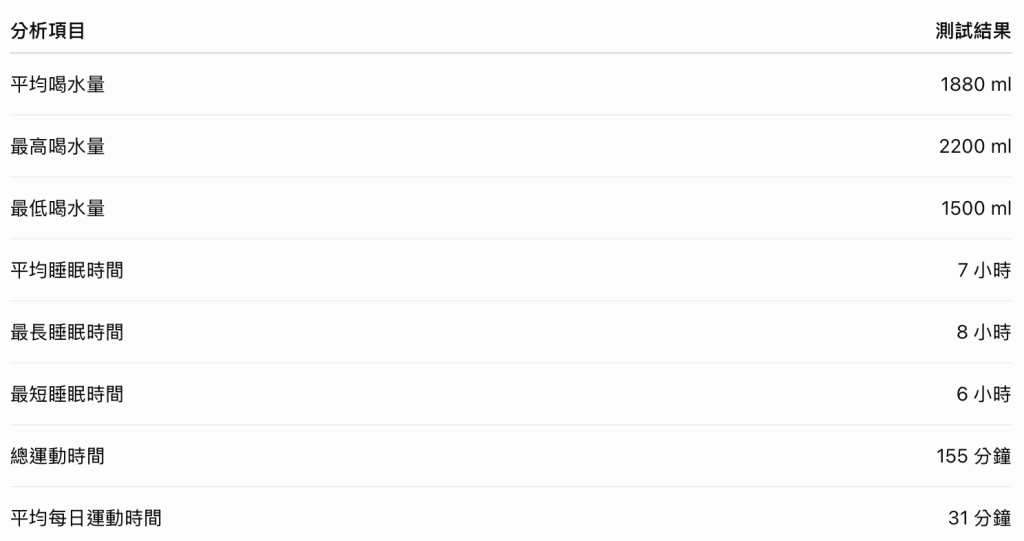
從這份測試資料可以發現,不同日期的喝水量、睡眠時間與運動時間都有所差異。
透過統計數據與圖表,可以更容易掌握資料的分布與變化,而不是只依賴單一天的紀錄判斷整體情況。
需要注意的是,這些數據是為了測試系統而建立的模擬資料,並不代表真實使用者的生活習慣。
九、今日成果與學習心得
今天的學習重點,是讓健康習慣追蹤系統從單純的資料紀錄工具,逐漸具備資料分析的能力。
過去的系統主要負責保存每天輸入的喝水量、睡眠時間與運動時間,而透過今天的分析,我們可以進一步計算平均值、比較不同日期的數據,並觀察各項習慣的變化趨勢。
此外,也學習到相關係數的基本概念,理解不同資料之間可能存在關聯,但不能只根據相關性就推論因果關係。
這次練習讓我了解到,資料分析不只是將數字整理成表格,更重要的是從資料中找出值得觀察的現象,並以容易理解的方式呈現給使用者。
十、下一步學習方向
明天將進入 Day 29,主要任務是整理專案成果與展示內容。
目前已經完成系統規劃、資料設計、功能開發、測試、介面改善與資料分析。接下來需要將這些開發過程整理成完整的專案成果,包含系統功能介紹、操作畫面、測試結果與開發心得,讓其他人也能清楚了解這三十天的學習成果。
今日總結:透過 Pandas 分析健康測試資料,計算喝水量、睡眠時間與運動時間的統計數值,並使用圖表及相關係數觀察不同健康習慣的變化,讓系統從資料紀錄進一步延伸至資料分析。

 corn0414

 iThome鐵人賽
 看影片追技術