
只要你曾在生產環境架設過 OpenTelemetry Collector,你的 config.yaml 裡百分之百寫過這幾行:
service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [batch] # 幾乎所有官方教學與 Helm Charts 的標準配置
      exporters: [otlp]
自 2019 年 OpenTelemetry 專案問世以來,batch processor 一直被視為 Collector 效能優化的核心基石——它負責把來自各處零散的 Traces、Metrics 與 Logs 打包成 Batch,藉此提升網路壓縮比並分攤 HTTP/gRPC 的 RTT 延遲。
然而,在 2026 年 11 月,OpenTelemetry 官方維護團隊(Bogdan Drutu、Dmitry Anoshin 與 Joshua MacDonald)正式發布了 Deprecating the Collector Batch Processor 的重大架構變更公告:
「我們正式宣告棄用
batchprocessor。批次處理能力已直接整合至各個 Exporter 的sending_queue(稱為 Exporter-level batching),並同步推出全新的queue_batchprocessor 作為替代方案。」
sending_queue 與底層 queuebatch 模組進入穩定狀態。batch processor 將正式從 Core Repository 與各發行版中徹底刪除。表面上看,這只是把配置區塊從 processors.batch 搬到 exporters.<name>.sending_queue.batch;但實際上,這是 Collector 核心團隊歷經數年重構、為了解決分散式追蹤與遙測傳輸中最棘手的 OOM、Backpressure 雪崩 與 Head-of-line blocking 所交出的最終答案。
batch processor 的三大致命架構缺陷要理解為什麼 OTel 社群不惜打破使用了六年的既有習慣,必須深入舊版 batchprocessor 的原始碼,看看它在現代高吞吐雲原生環境下撞上了哪些物理極限。
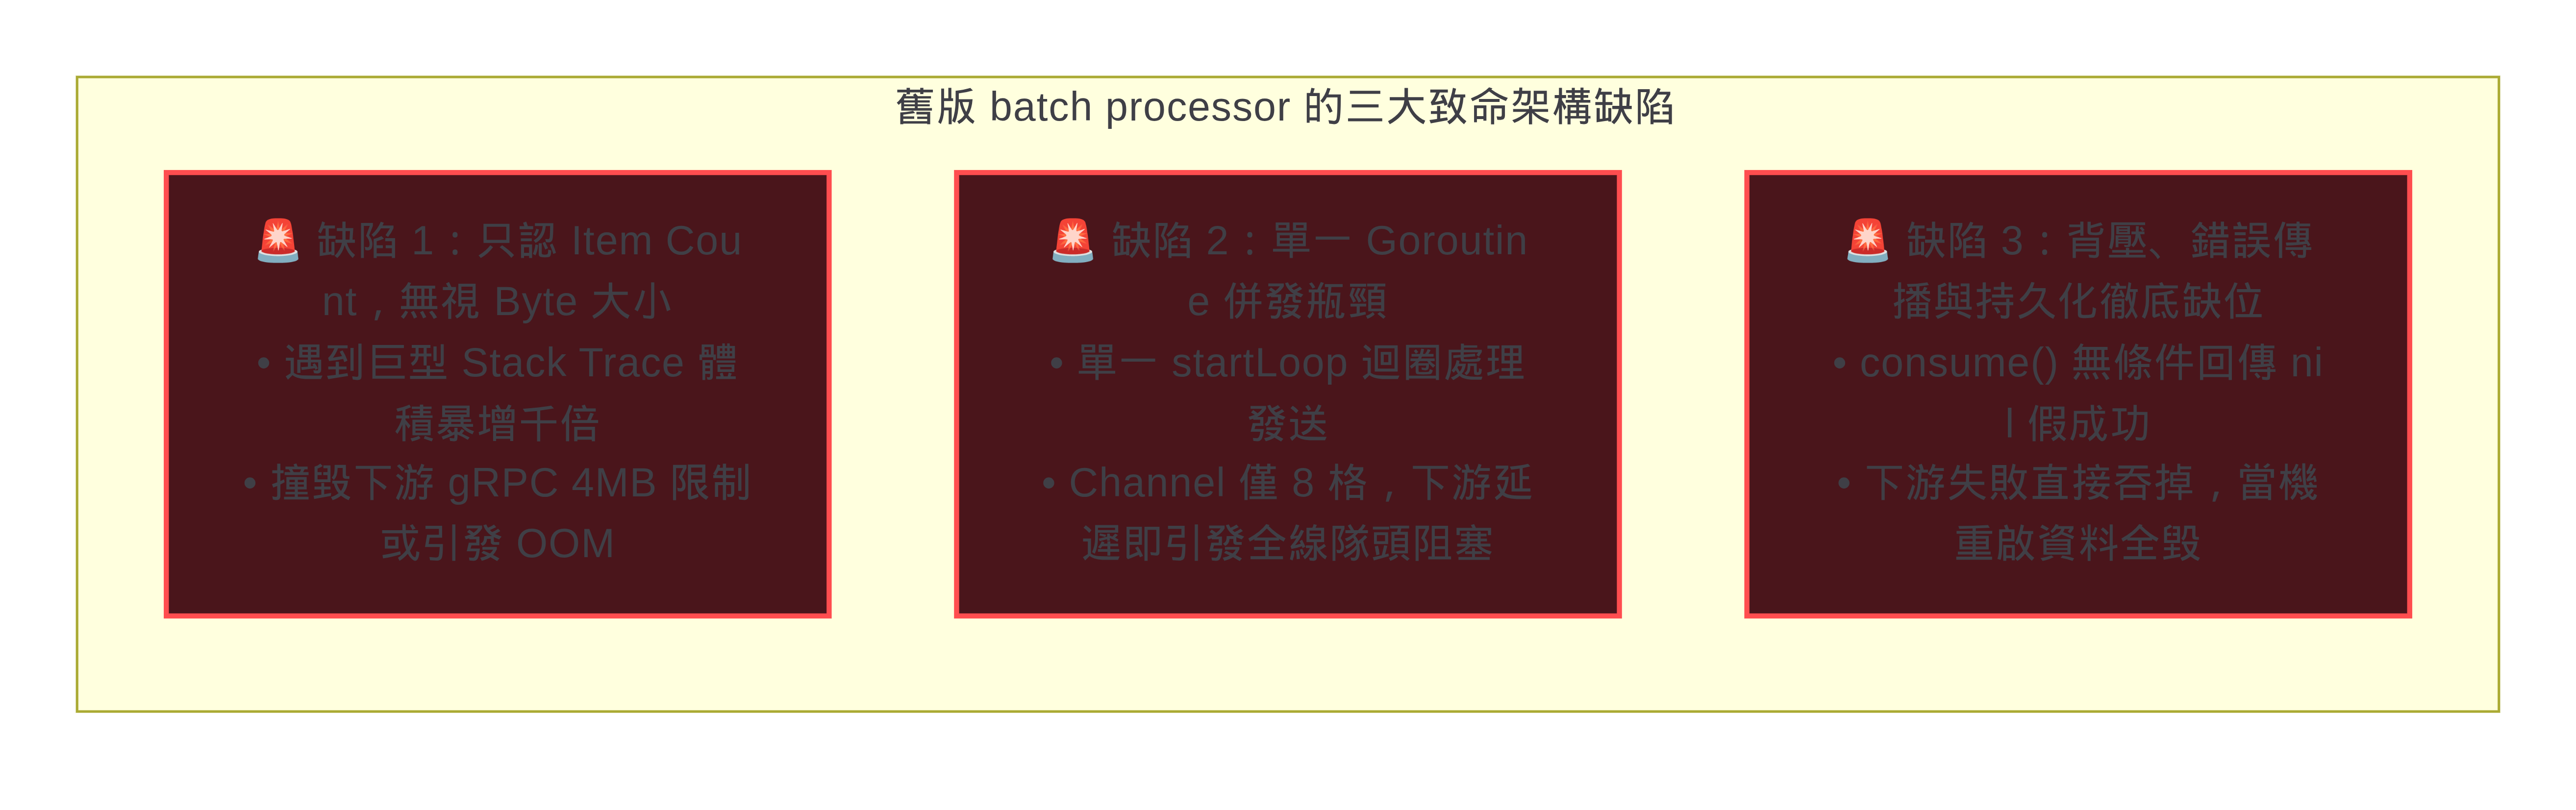
舊版 batch processor 的設定參數本質上完全基於 Item Count:
processors:
  batch:
    timeout: 200ms
    send_batch_size: 8192      # 湊滿 8192 個 items 就發送
    send_batch_max_size: 10000  # 最大切分上限
在 Collector 的內部表示中,一個「Item」代表一個 Span、一個 Metric Data Point 或一筆 Log Record。然而:
當 send_batch_size 設為 8,192 時:
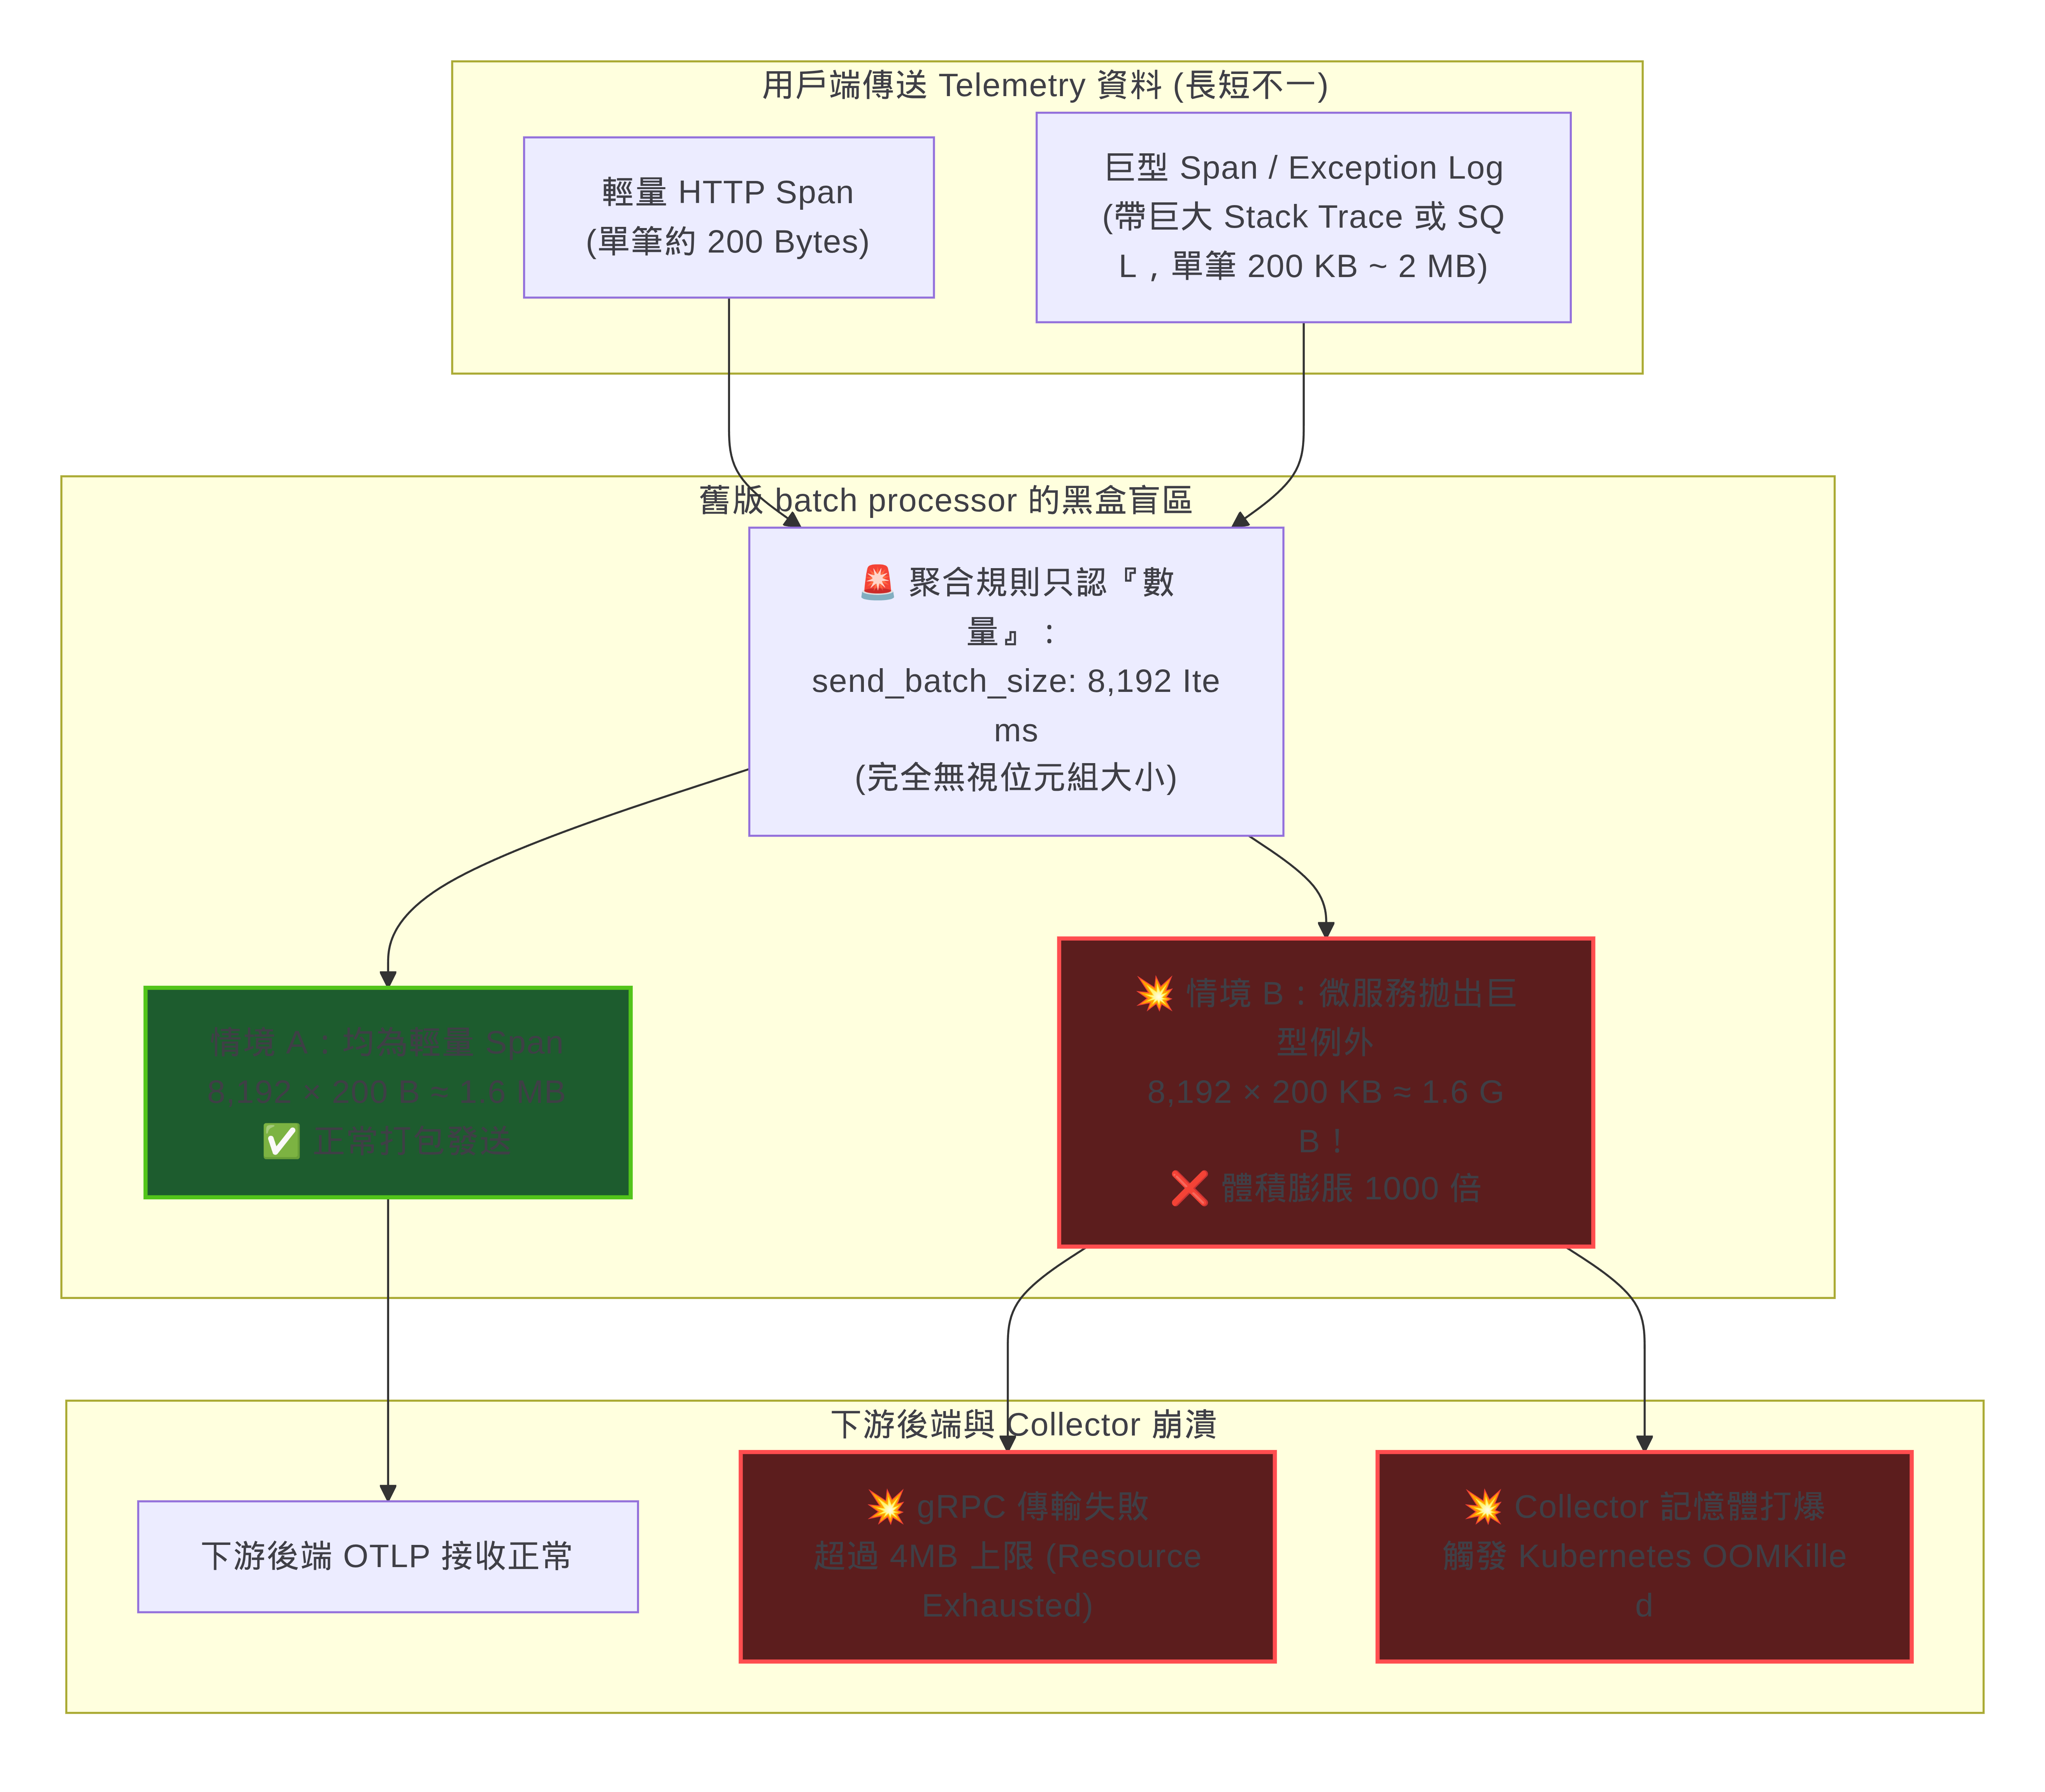
這會直接引爆兩大問題:
MaxRecvMsgSize(預設 4MB),一旦批次在序列化後超過 4MB,下游直接拒收並回報 ResourceExhausted。memory_limiter)無法阻止 batch processor 正在聚合的記憶體膨脹,導致容器被 Kubernetes OOMKilled。舊架構無法按照 Bytes 來聚合或切分批次,是促成重構的首要原因。
監控服務自己若因為自己沒做好記憶體管理,而導致 OOM 漏了資料。那就沒人會信這套監控服務是可靠的了。
我們翻開 processor/batchprocessor/batch_processor.go 的核心原始碼,檢視它的 Consume 處理機制:
// 舊版 batch_processor.go 中的核心接收邏輯
func (sb *singleShardBatcher[T]) consume(_ context.Context, data T) error {
	sb.single.newItem <- data  // 將請求推入一個內建的 Go Channel
	return nil                 // 立刻向 upstream 回報成功!
}
這個看似輕巧的實作背後隱藏著嚴重的並行盲點:
func (bp *batchProcessor[T]) newShard(...) *shard[T] {
	return &shard[T]{
		processor: bp,
		newItem:   make(chan T, runtime.NumCPU()), // 緩衝區極小(僅 CPU 核心數)
		batch:     bp.batchFunc(),
	}
}
// 舊版 shard.go 中的單一 Event Loop
func (b *shard[T]) startLoop() {
	for {
		select {
		case item := <-b.newItem:
			b.processItem(item)
		case <-timerCh:
			if b.batch.itemCount() > 0 {
				b.sendItems(triggerTimeout) // 觸發下游發送
			}
			b.resetTimer()
		}
	}
}
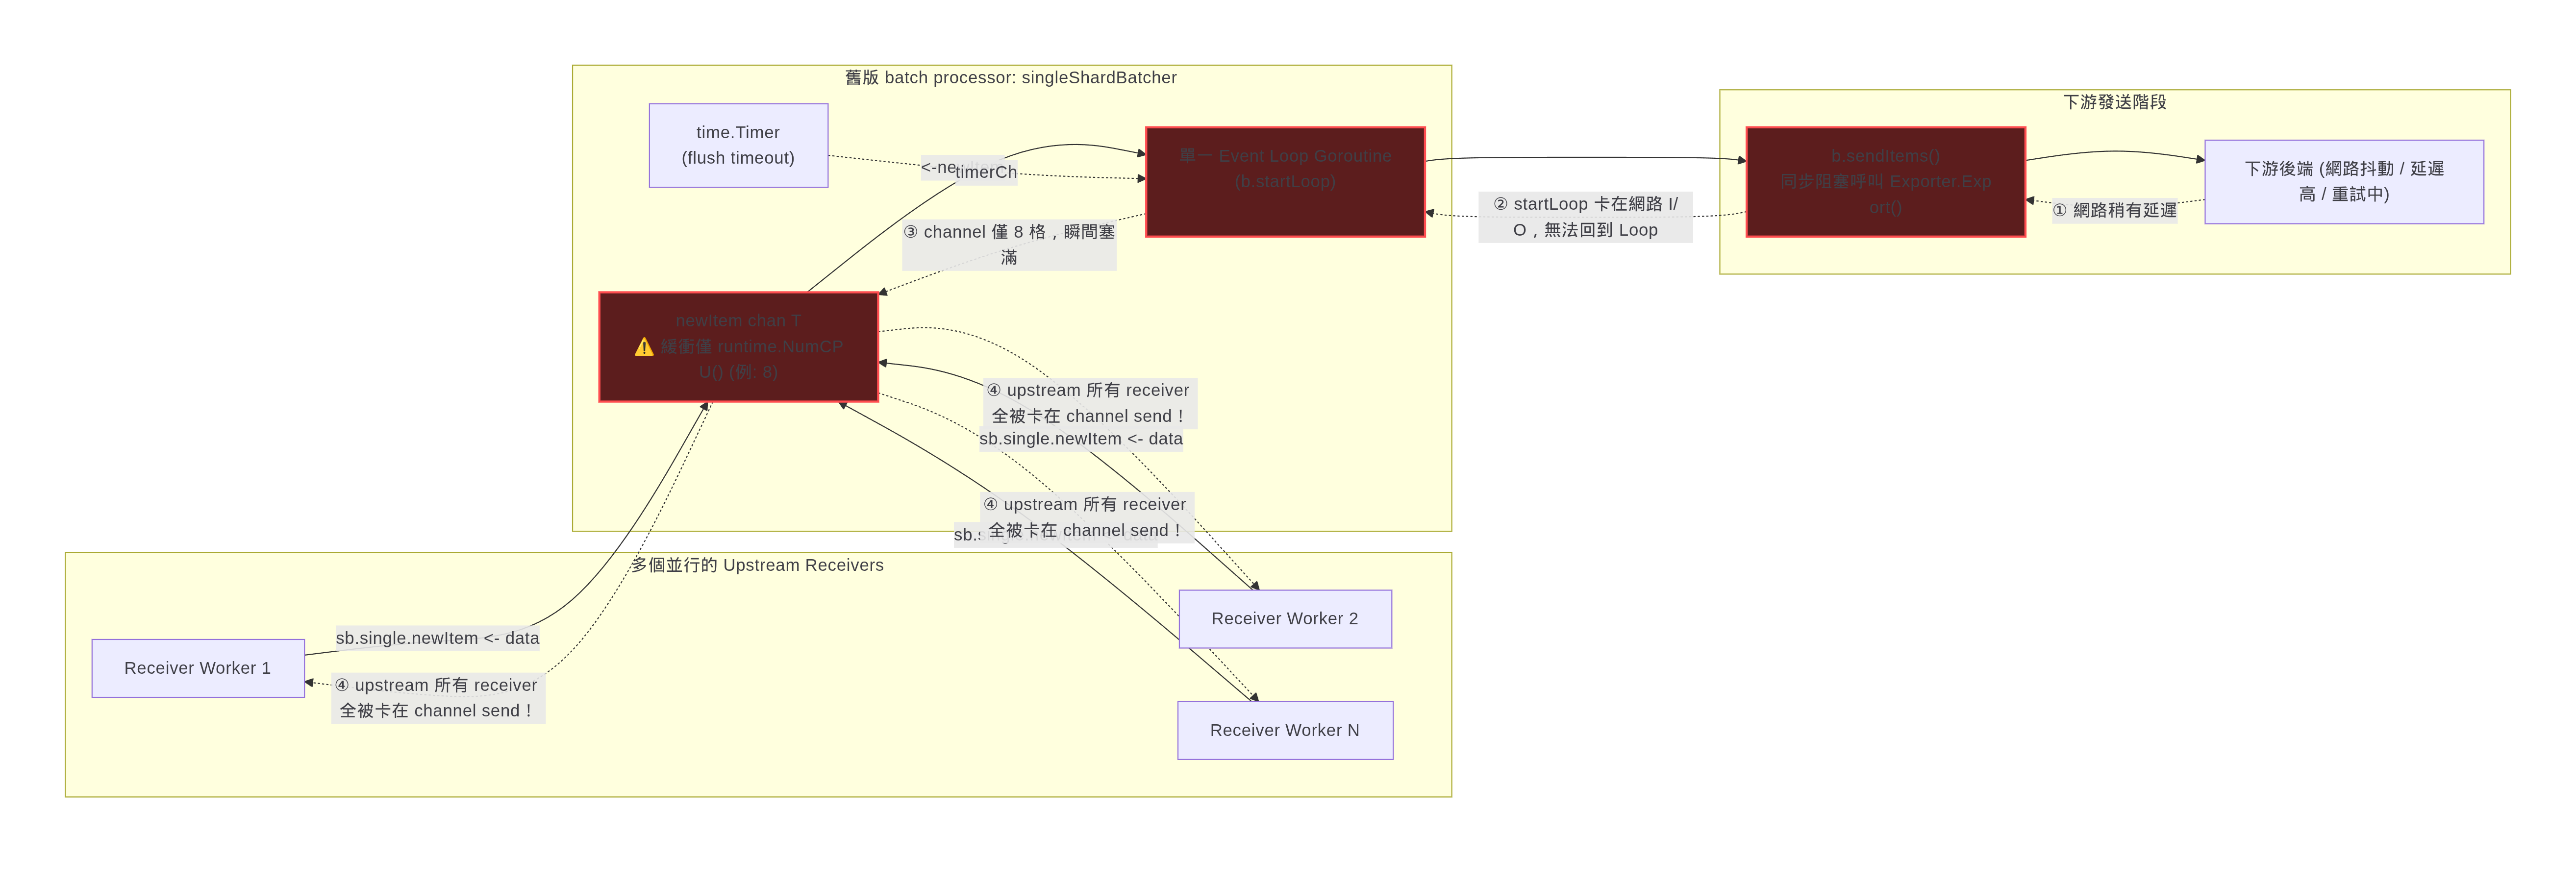
startLoop goroutine。當它呼叫 sendItems() 將資料發往下游 exporter 時,如果下游網路有延遲或發生 retry,這個迴圈就會卡在 b.sendItems() 呼叫上。newItem channel 容量僅有 runtime.NumCPU()(例如 8 或 16)。一旦 startLoop 卡住,只要十幾個 upstream 請求進來,channel 瞬間被塞滿。consume() 就會被阻塞在 sb.single.newItem <- data,進而卡死整個 HTTP/gRPC receiver 執行緒,將延遲直接回頂給前端業務服務。metadata_keys 讓它根據 header 開闢多個 shard,否則在預設情況下,批次聚合沒有任何並行發送能力!請再次觀察上述 consume 函式的回傳值:
sb.single.newItem <- data
return nil // 無條件回傳成功!
而在非同步發送的 sendItems 裡:
func (b *shard[T]) sendItems(trigger trigger) {
	sent, req := b.batch.split(b.processor.sendBatchMaxSize)
	err := b.batch.export(b.exportCtx, req)
	if err != nil {
		b.processor.logger.Warn("Sender failed", zap.Error(err))
		return // 僅僅打了一行 Warning Log,錯誤直接被吞噬!
	}
}
這造成了系統可靠度的「三大黑洞」:
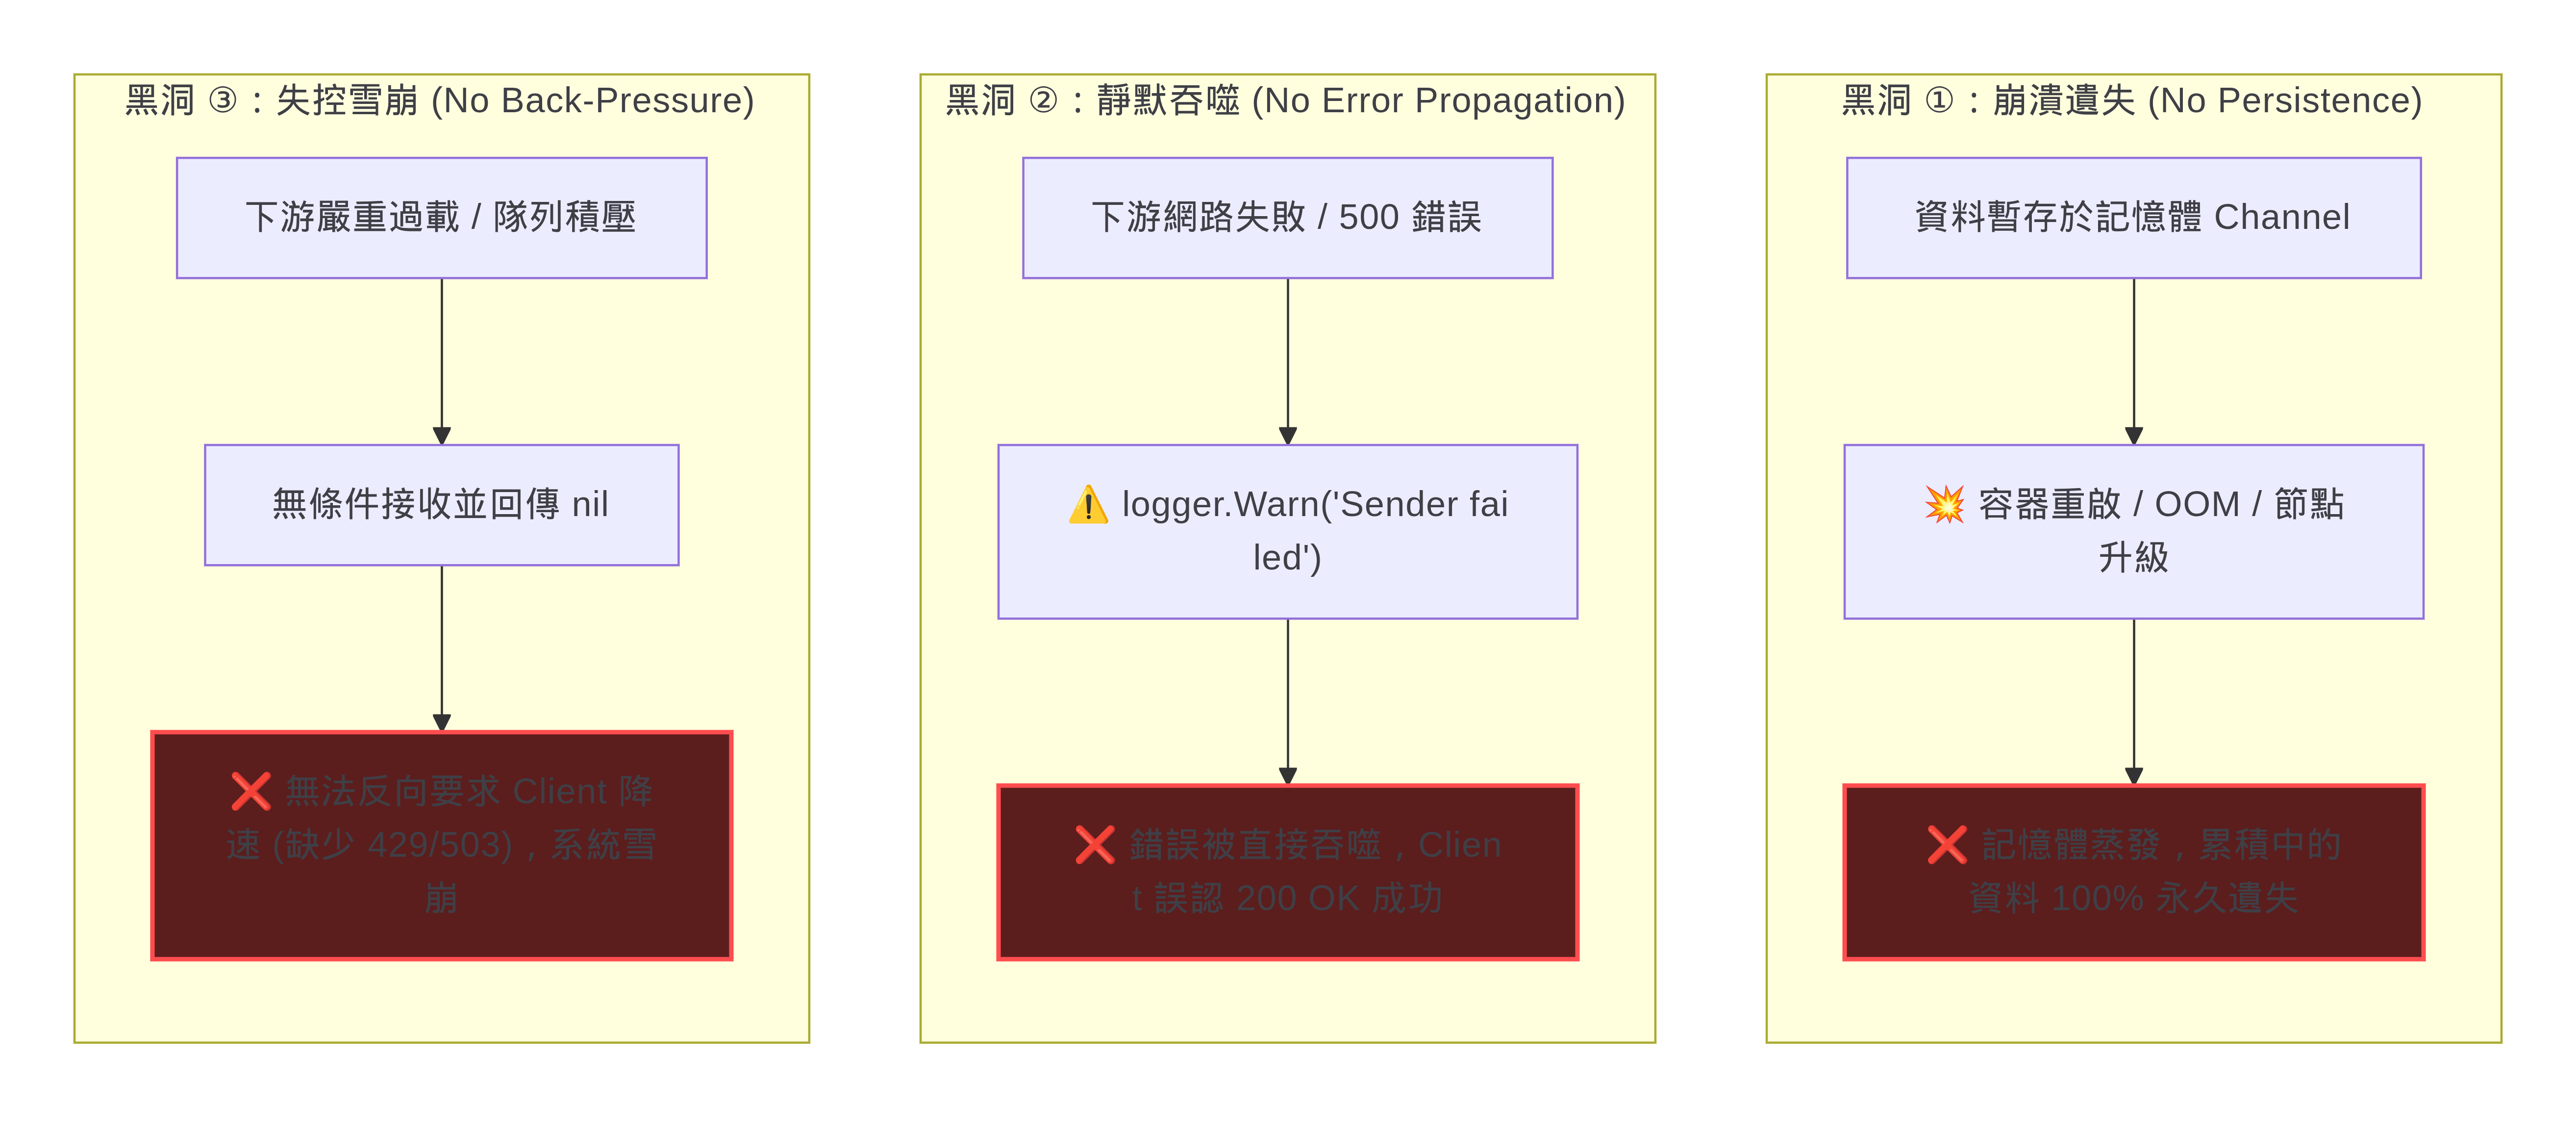
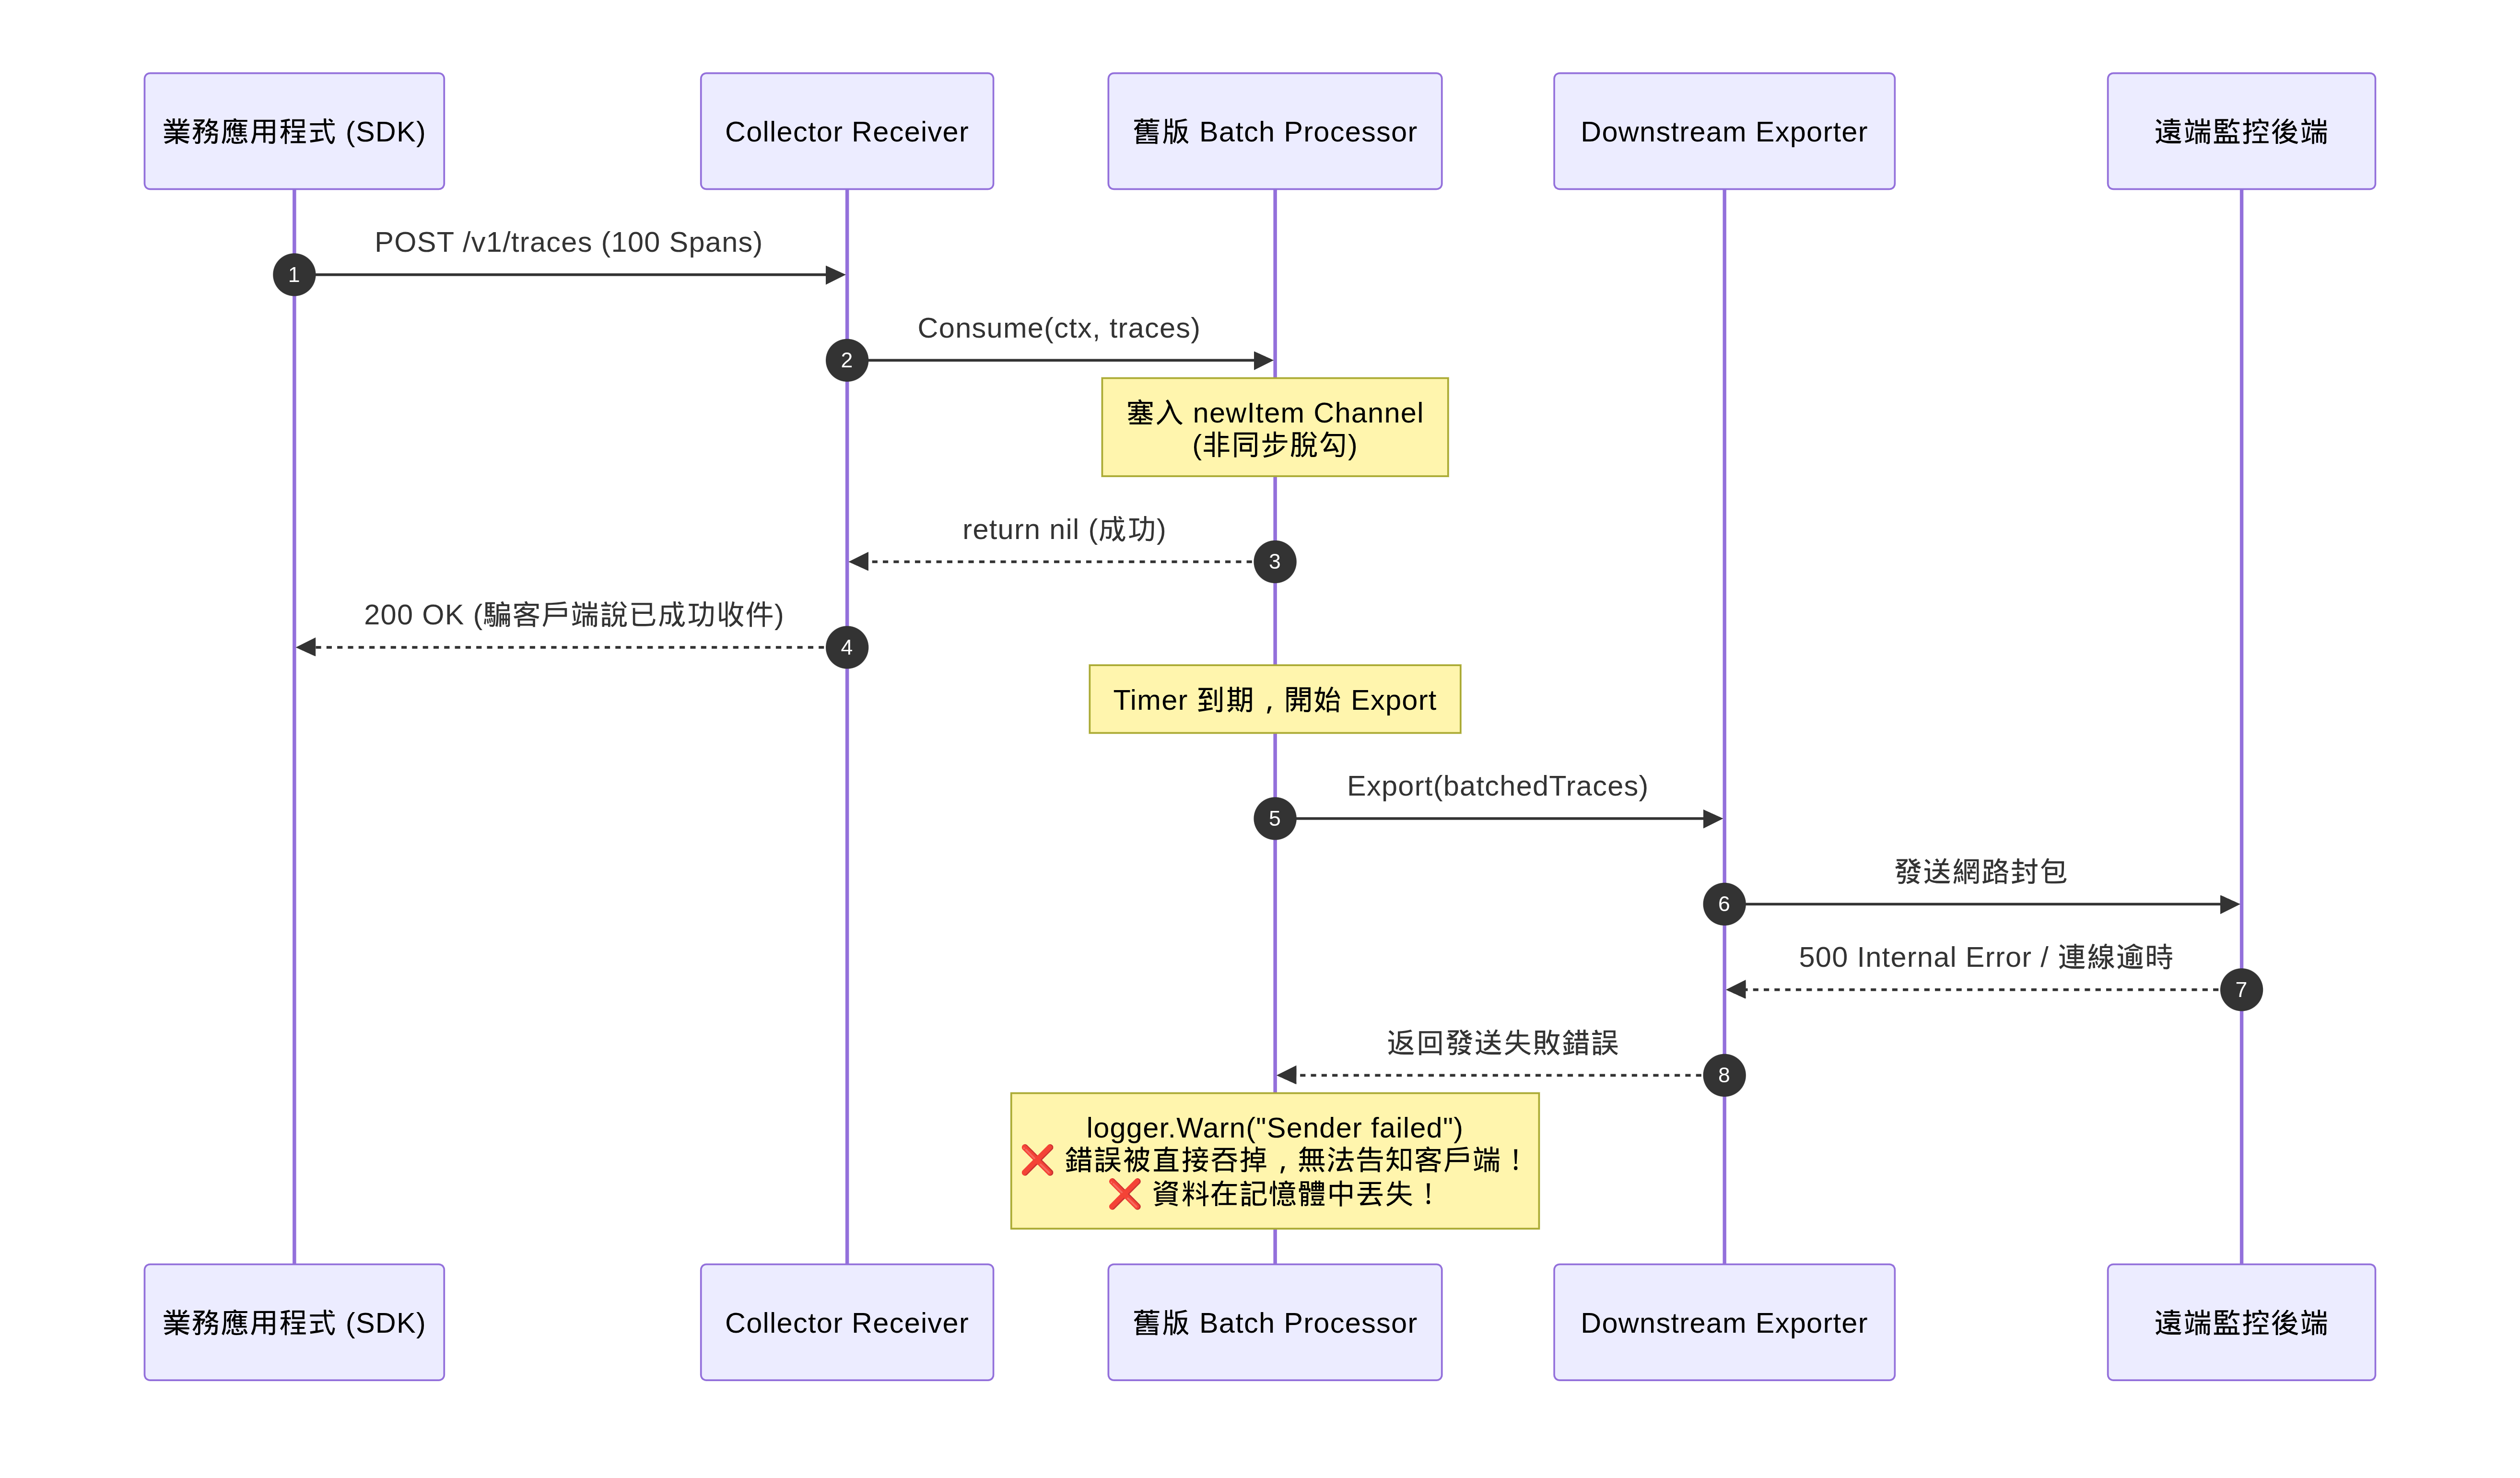
200 OK,誤以為遙測數據已安全送達。但後端當機或 Exporter 耗盡重試時,資料默默蒸發,發送端毫無感知,無法觸發 Client 重試。batch processor 內部的佇列純粹是記憶體 channel。當 Collector 滾動更新、Pod 被 Evict 或進程 Crash 時,滯留資料全數蒸發。因為 OTel collector 其實不像 RDBMS 有 WAL 機制,重啟後也是能從硬碟中的資料持續進行。但 OTel Collector 並沒這設計,也不會寫硬碟,因為 OTel collector 基本都是會先以 Sidecar container 的形式存在,如果要每個 sidecar 都配置 PVC 其實是很大的成本,所以不預設這機制 這是正常的。
為了解決上述三大硬傷,OpenTelemetry 架構團隊做了一次大膽的結構重組:將佇列與批次合二為一,並將批次處理的時機點往後推移到佇列之後!
| 比較維度 | 舊版 batch processor |
新版 Exporter-Level sending_queue.batch |
|---|---|---|
| 批次發生的位置 | Pipeline 處理中段(所有 Exporter 共用) | Exporter 發送端(各 Exporter 獨立運作) |
| 度量維度 (Sizer) | 僅限 Items Count | 支援 Requests、Items 與 Bytes |
| 持久化支援 | ❌ 無(記憶體 Channel,當機即遺失) | ✅ 完整支援(可對接 file_storage 等儲存擴充) |
| 背壓與確認控制 | ❌ 立即回傳 nil,吞噬下游失敗 |
✅ 支援 block_on_overflow 與 wait_for_result |
| 併發與執行緒模型 | 單一 Shard 單一 Loop,容易 Head-of-line blocking | 獨立 workerPool,佇列消費與網路發送解耦 |
| 多後端適應性 | ❌ 所有 Exporter 強迫接收同一種 Batch 大小 | ✅ Exporter A (OTLP gRPC) 可設 4MB;Exporter B (Datadog) 可設 2MB |
| 分區支援 (Partition) | 依賴未限制或粗糙的 Multi-shard | 內建長度前綴編碼 + LRU Cache + idle_timeout |
file_storage?在深入原始碼之前,許多具備大規模生產經驗的 SRE 與架構師會浮現一個非常犀利的工程疑問:
「OpenTelemetry Collector 本質上不是 RDBMS,沒有原生預設的 WAL 機制。在 Kubernetes 生態中,Collector 大多以 Pod 的 Sidecar 形式部署;若為數以千計的 Sidecar 容器各自分配獨立的 PVC,不僅維運成本巨大,還會迅速觸碰雲端供應商的單節點磁碟掛載上限(例如 AWS EC2 單機通常僅支援 28~39 塊 EBS 磁碟卷)。既然 Sidecar 預設走純記憶體(In-Memory)是合理的工程決策,為什麼新版 Exporter-Level 架構要大費周章地將持久化(
file_storage)與批次處理進行深度整合?」
這看似矛盾,但背後恰恰展現了 OpenTelemetry 架構委員會在 「分層部署拓撲」 與 「修復歷史假持久化漏洞」 上的嚴密工程思維:
在成熟的企業級可觀測性架構中,Collector 幾乎都是以 「雙層拓撲(Two-Tier Architecture)」 落地:
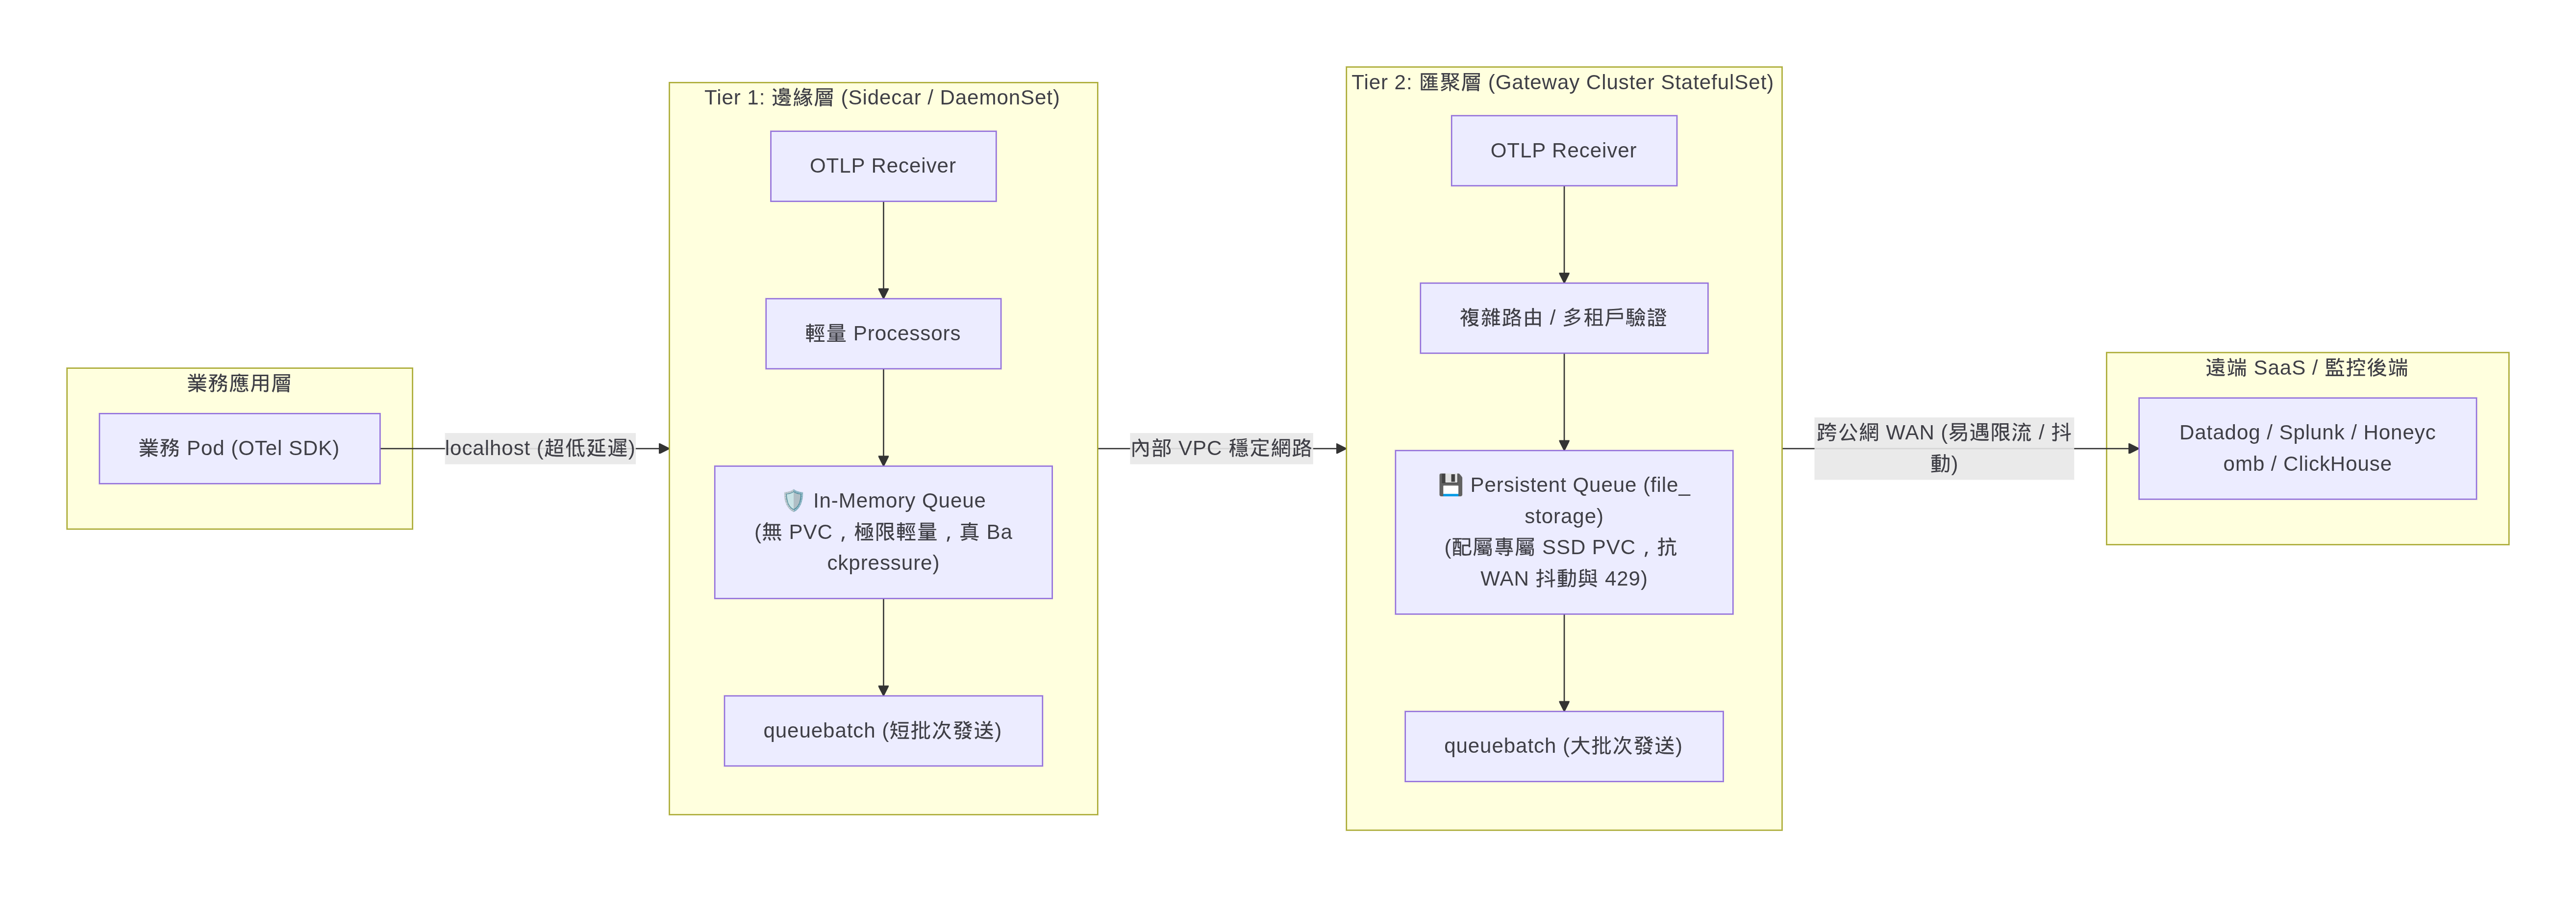
file_storage?更關鍵的原因在於:舊架構中的持久化是一個「虛假的安全保證」!
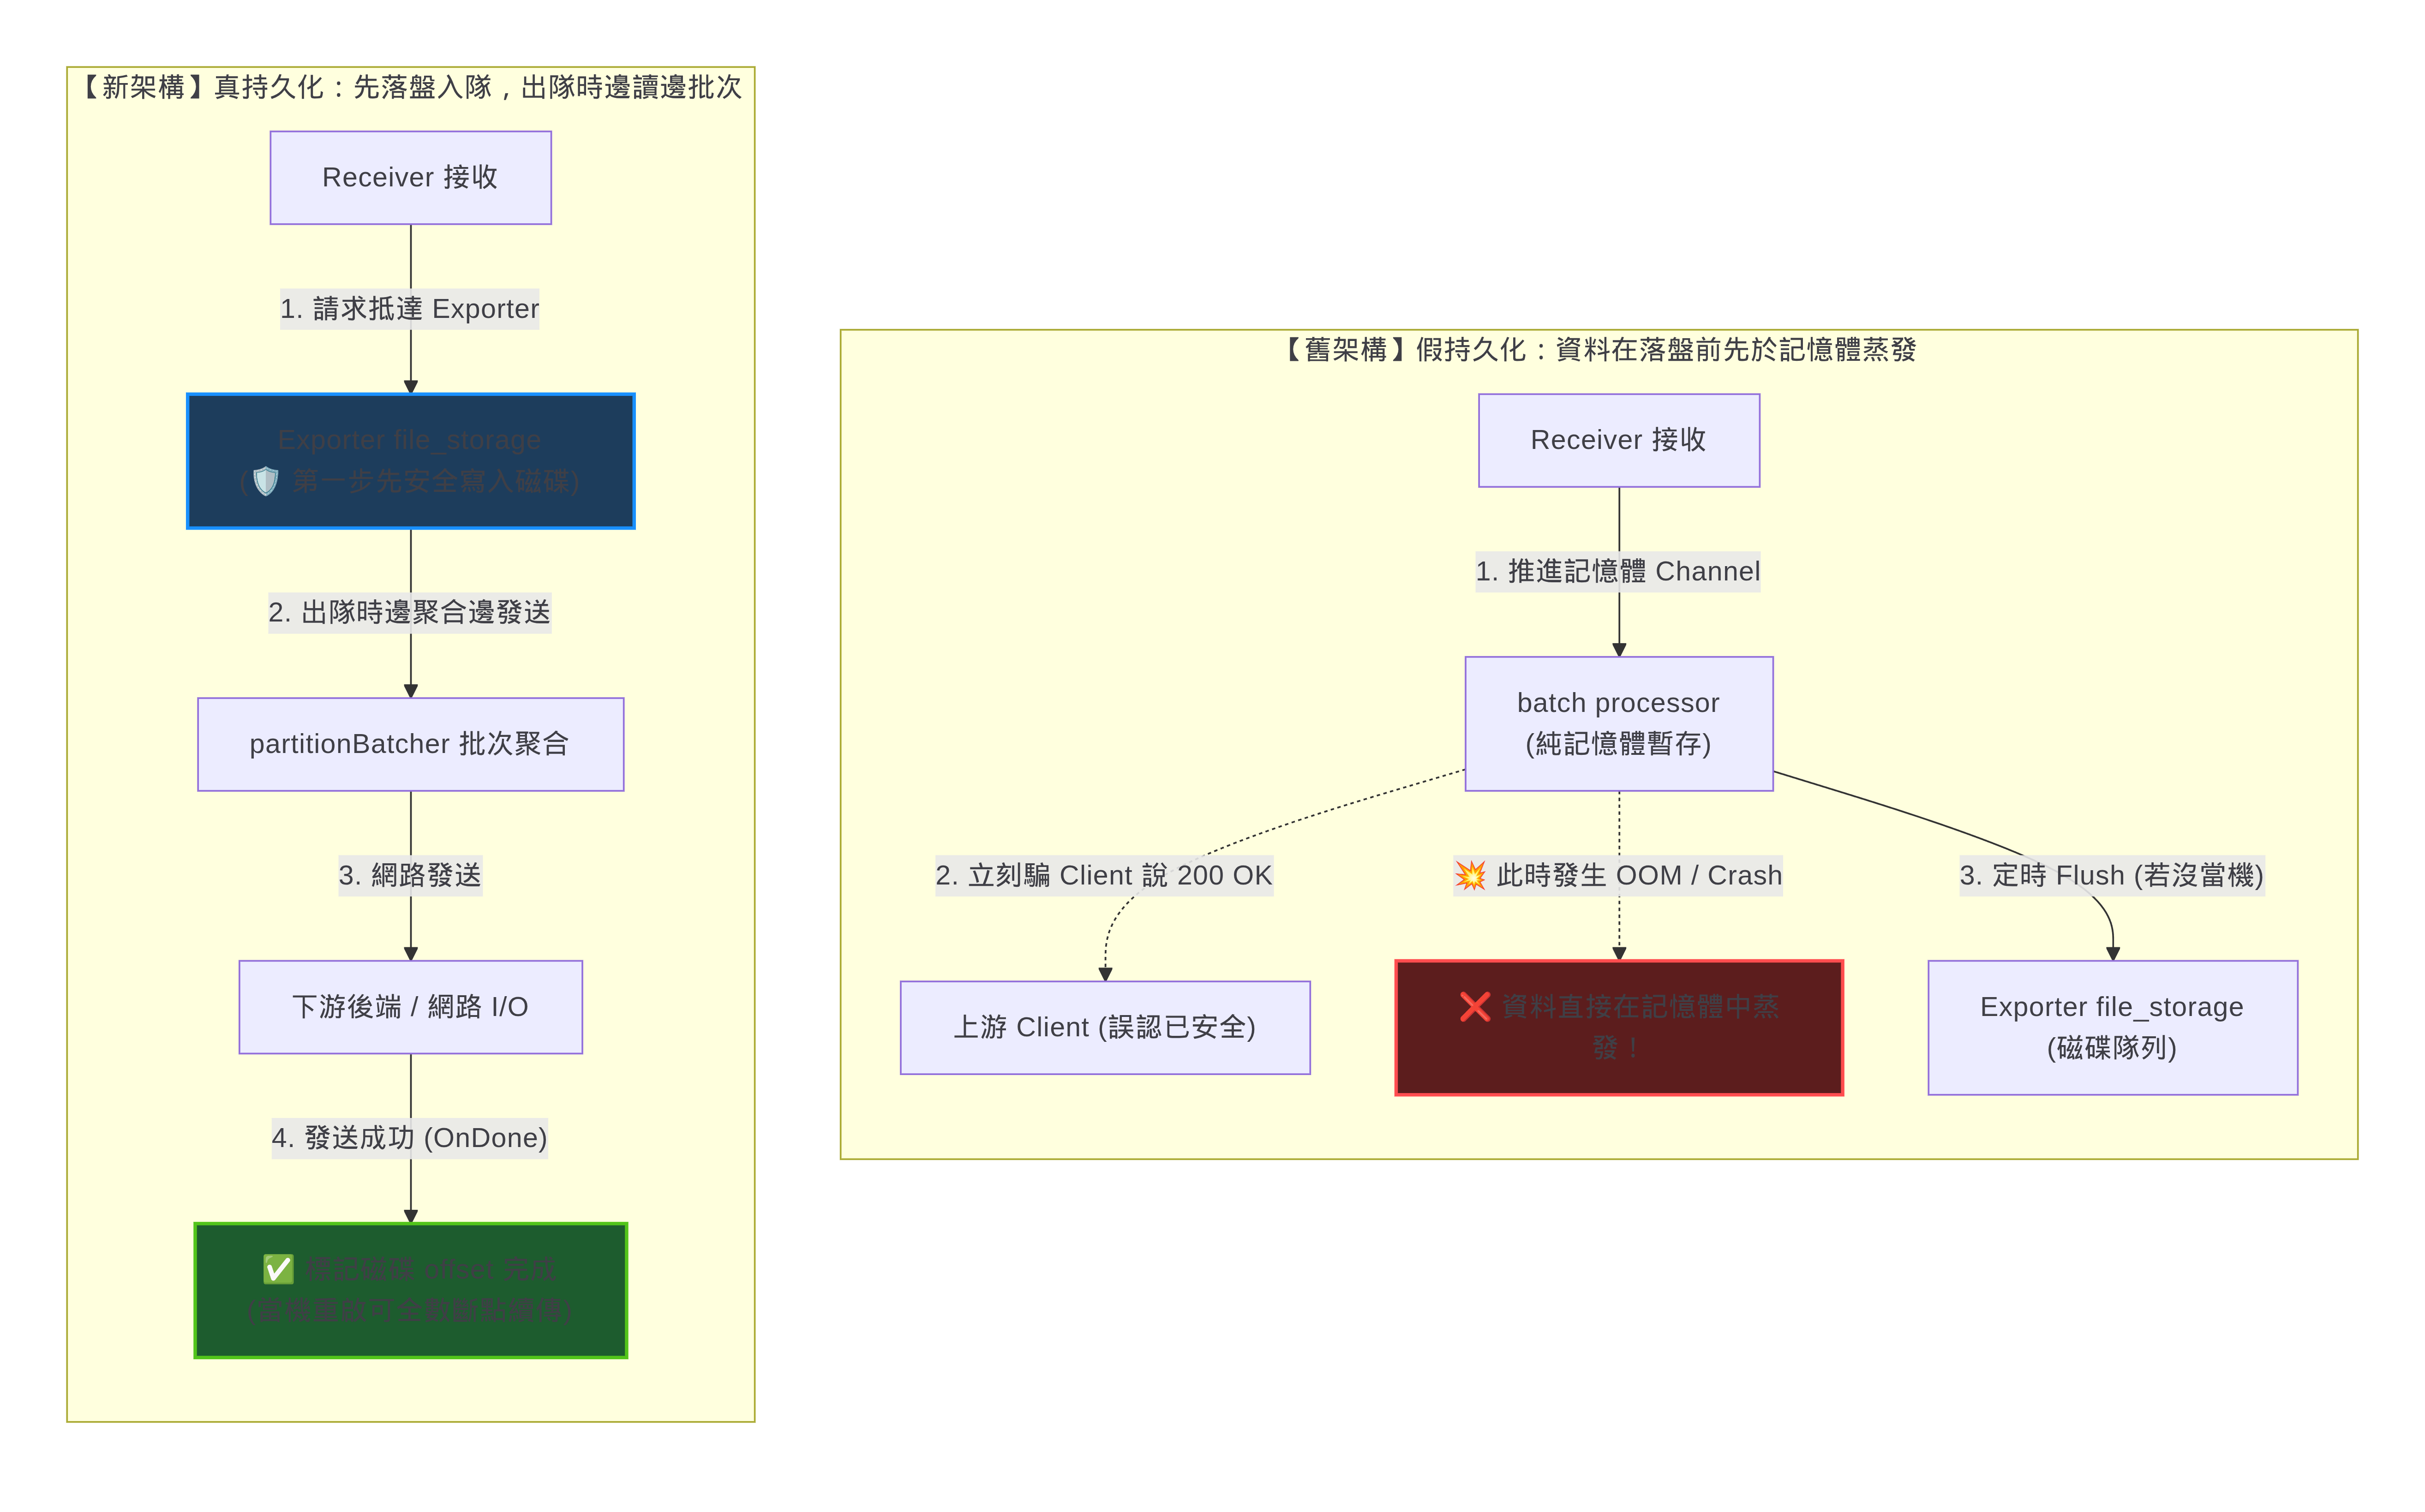
file_storage 位於 Exporter,但在進入 Exporter 前,請求必須在 batch processor 的記憶體中等待累積(數秒到數十秒)。但 batch processor 一收到資料就向上游回傳 nil(200 OK)。如果 Collector 在這幾秒內遭遇 OOMKill 或節點被 Evict,資料在還沒看過磁碟一眼之前就徹底蒸發了,後方的 file_storage 完全是個擺設!file_storage 磁碟;隨後由 partitionBatcher 從磁碟讀出並合併成批次發送;只有當下游網路確認成功後,Done 回調才會標記磁碟 Offset 完成。進程中斷重啟,能夠真正做到 100% 斷點續傳!即便在不掛載任何磁碟的 Sidecar 上,新架構的純記憶體佇列(in_memory)也帶來了徹底的可靠性躍升:
batch processor 即使自己的記憶體快被擠爆,依然向應用 SDK 回傳成功(nil),隨後在背景默默丟包或直接引發 OOMKill。block_on_overflow: true 與 wait_for_result: true,當 Sidecar 記憶體隊列滿載時,Receiver 會立即向業務應用的 OTel SDK 回拋 gRPC RESOURCE_EXHAUSTED (Code 8) 或 HTTP 429。此外,對於以 DaemonSet 模式運行的 Collector Agent,團隊甚至不需要昂貴的雲端 PVC,直接透過掛載宿主機的本地 NVMe SSD(如 hostPath 或 emptyDir):
extensions:
  file_storage:
    directory: /var/lib/otelcol/buffer # 掛載自宿主機本地 NVMe SSD
這樣既不佔用雲端磁碟配額,又能讓每個節點上的 Agent 擁有數十 GB 的抗網絡抖動磁碟緩衝區,在成本、效能與可靠性之間取得了絕佳平衡。
exporterhelper/internal/queuebatch 實作精華現在,我們打開 OpenTelemetry Collector 核心儲存庫中位於 exporter/exporterhelper/internal/queuebatch 的源碼,一窺這套工業級批次佇列系統是如何設計的。
Request 與 MergeSplit新架構的核心抽象位於 exporter/exporterhelper/internal/request/request.go:
type Request interface {
    // 取得基本項目數量(Spans, Datapoints, Log records)
    ItemsCount() int

    // 取得序列化後的位元組大小
    BytesSize() int

    // 核心方法:將當前 Request 與另一個 Request 進行合併與/或切分
    MergeSplit(ctx context.Context, maxSize int, sizerType SizerType, req Request) ([]Request, error)
}
以追蹤資料為例,在 traces_batch.go 裡的 MergeSplit 實作:
func (req *tracesRequest) MergeSplit(_ context.Context, maxSize int, szt request.SizerType, r2 request.Request) ([]request.Request, error) {
	var sz sizer.TracesSizer
	switch szt {
	case request.SizerTypeItems:
		sz = &sizer.TracesCountSizer{}
	case request.SizerTypeBytes:
		sz = &sizer.TracesBytesSizer{}
	default:
		return nil, errors.New("unknown sizer type")
	}

	// 1. 如果傳入了另一個請求 r2,先將 r2 合併進當前的 req
	if r2 != nil {
		req2, ok := r2.(*tracesRequest)
		if !ok {
			return nil, errors.New("invalid input type")
		}
		req2.mergeTo(req, sz, szt)
	}

	// 2. 如果沒有設定 maxSize 上限,直接回傳合併後的大包
	if maxSize == 0 {
		return []request.Request{req}, nil
	}

	// 3. 若超過 maxSize,依照 SizerType(數量或位元組)切分出獨立的 Requests
	return req.split(maxSize, sz, szt)
}
關鍵亮點:
MergeSplit實現了 zero-copy 或指針轉移(MoveAndAppendTo),並且同時支援 Items 與 Bytes 計算。如果一筆資料太大,它會將ResourceSpans拆解;若即使單一 Span 都大於maxSize且無法再切,它會明確拋出錯誤或降級處理,不再陷入無窮迴圈。
QueueBatch 的消費機制在 queue_batch.go 中,Collector 將佇列 queue.Queue 與批次器 batcher.Batcher 組裝成一個統一的結構體:
type QueueBatch struct {
	queue   queue.Queue[request.Request]
	batcher Batcher[request.Request]
}

func NewQueueBatch(set AllSettings[request.Request], cfg Config, next sender.SendFunc[request.Request]) (*QueueBatch, error) {
	b, err := NewBatcher(cfg.Batch, batcherSettings[request.Request]{
		partitioner: set.Partitioner,
		mergeCtx:    set.MergeCtx,
		next:        next,
		maxWorkers:  cfg.NumConsumers,
		obsMetrics:  set.ObsMetrics,
		logger:      set.Telemetry.Logger,
	})
	if err != nil {
		return nil, err
	}

	// 關鍵設計!若啟用了 Batching 且無分區,則將底層隊列的 Consumers 強制設為 1!
	// 詳見官方 Issue #12473
	if cfg.Batch.HasValue() && set.Partitioner == nil {
		cfg.NumConsumers = 1
	}

	// 建立隊列,並將 b.Consume 作為隊列出列時的回呼函式!
	q, err := queue.NewQueue(queue.Settings[request.Request]{
		SizerType:        cfg.Sizer,
		Capacity:         cfg.QueueSize,
		NumConsumers:     cfg.NumConsumers,
		WaitForResult:    cfg.WaitForResult,
		BlockOnOverflow:  cfg.BlockOnOverflow,
		StorageID:        cfg.StorageID,
        // ...
	}, b.Consume)

	return &QueueBatch{queue: q, batcher: b}, nil
}
[!NOTE] 為什麼無分區時 Queue 的
NumConsumers要設為 1?
這是非常精妙的併發控制!若多個佇列消費者同時從隊列撈取零散項目組裝批次,會造成資料碎片化與 Lock Contention。新架構中,由單一佇列通道出列餵給batcher,組裝成符合min_size的大批次後,再交由workerPool(內部維護maxWorkers = cfg.NumConsumers)進行高度並行的網路發送。這徹底避免了競態條件,同時維持了最大的網路吞吐!
partitionBatcher 與 workerPool許多工程師在初讀原始碼時會有一個大疑問:「為什麼最基層的批次器叫 partitionBatcher?如果我沒有開啟 Partition 分區,它又在扮演什麼角色?」
partitionBatcher 與 Partition 的架構關係在 queuebatch 的設計哲學中,partitionBatcher 是整個系統中最小的 Atomic Batching 狀態機。不論系統有沒有啟用分區,所有的批次聚合邏輯最終都落在它身上:
shardedBatcher,底層包裝了 1 個(或少數 Shards)partitionBatcher 實例。此時這個單一的 partitionBatcher 就代表「全局唯一的預設分區」,所有從佇列出列的資料都進入此處聚合。metadata_keys): 系統使用 multiBatcher,內部維護一個 LRU 快取。每個不同的租戶標頭組合(如 Tenant-A、Tenant-B)在記憶體中都會各自動態實例化一個專屬的 partitionBatcher,各自獨立計數、獨立計時。workerPool: 無論系統中存在 1 個還是 10,000 個 partitionBatcher,它們全都共用同一個全域的 workerPool! 這意味著即使有上千個租戶分區同時滿足發送條件,網路發送的並發 Goroutine 數量永遠被嚴格限制在 num_consumers 上限內,徹底杜絕了連線數爆炸與 CPU 耗盡。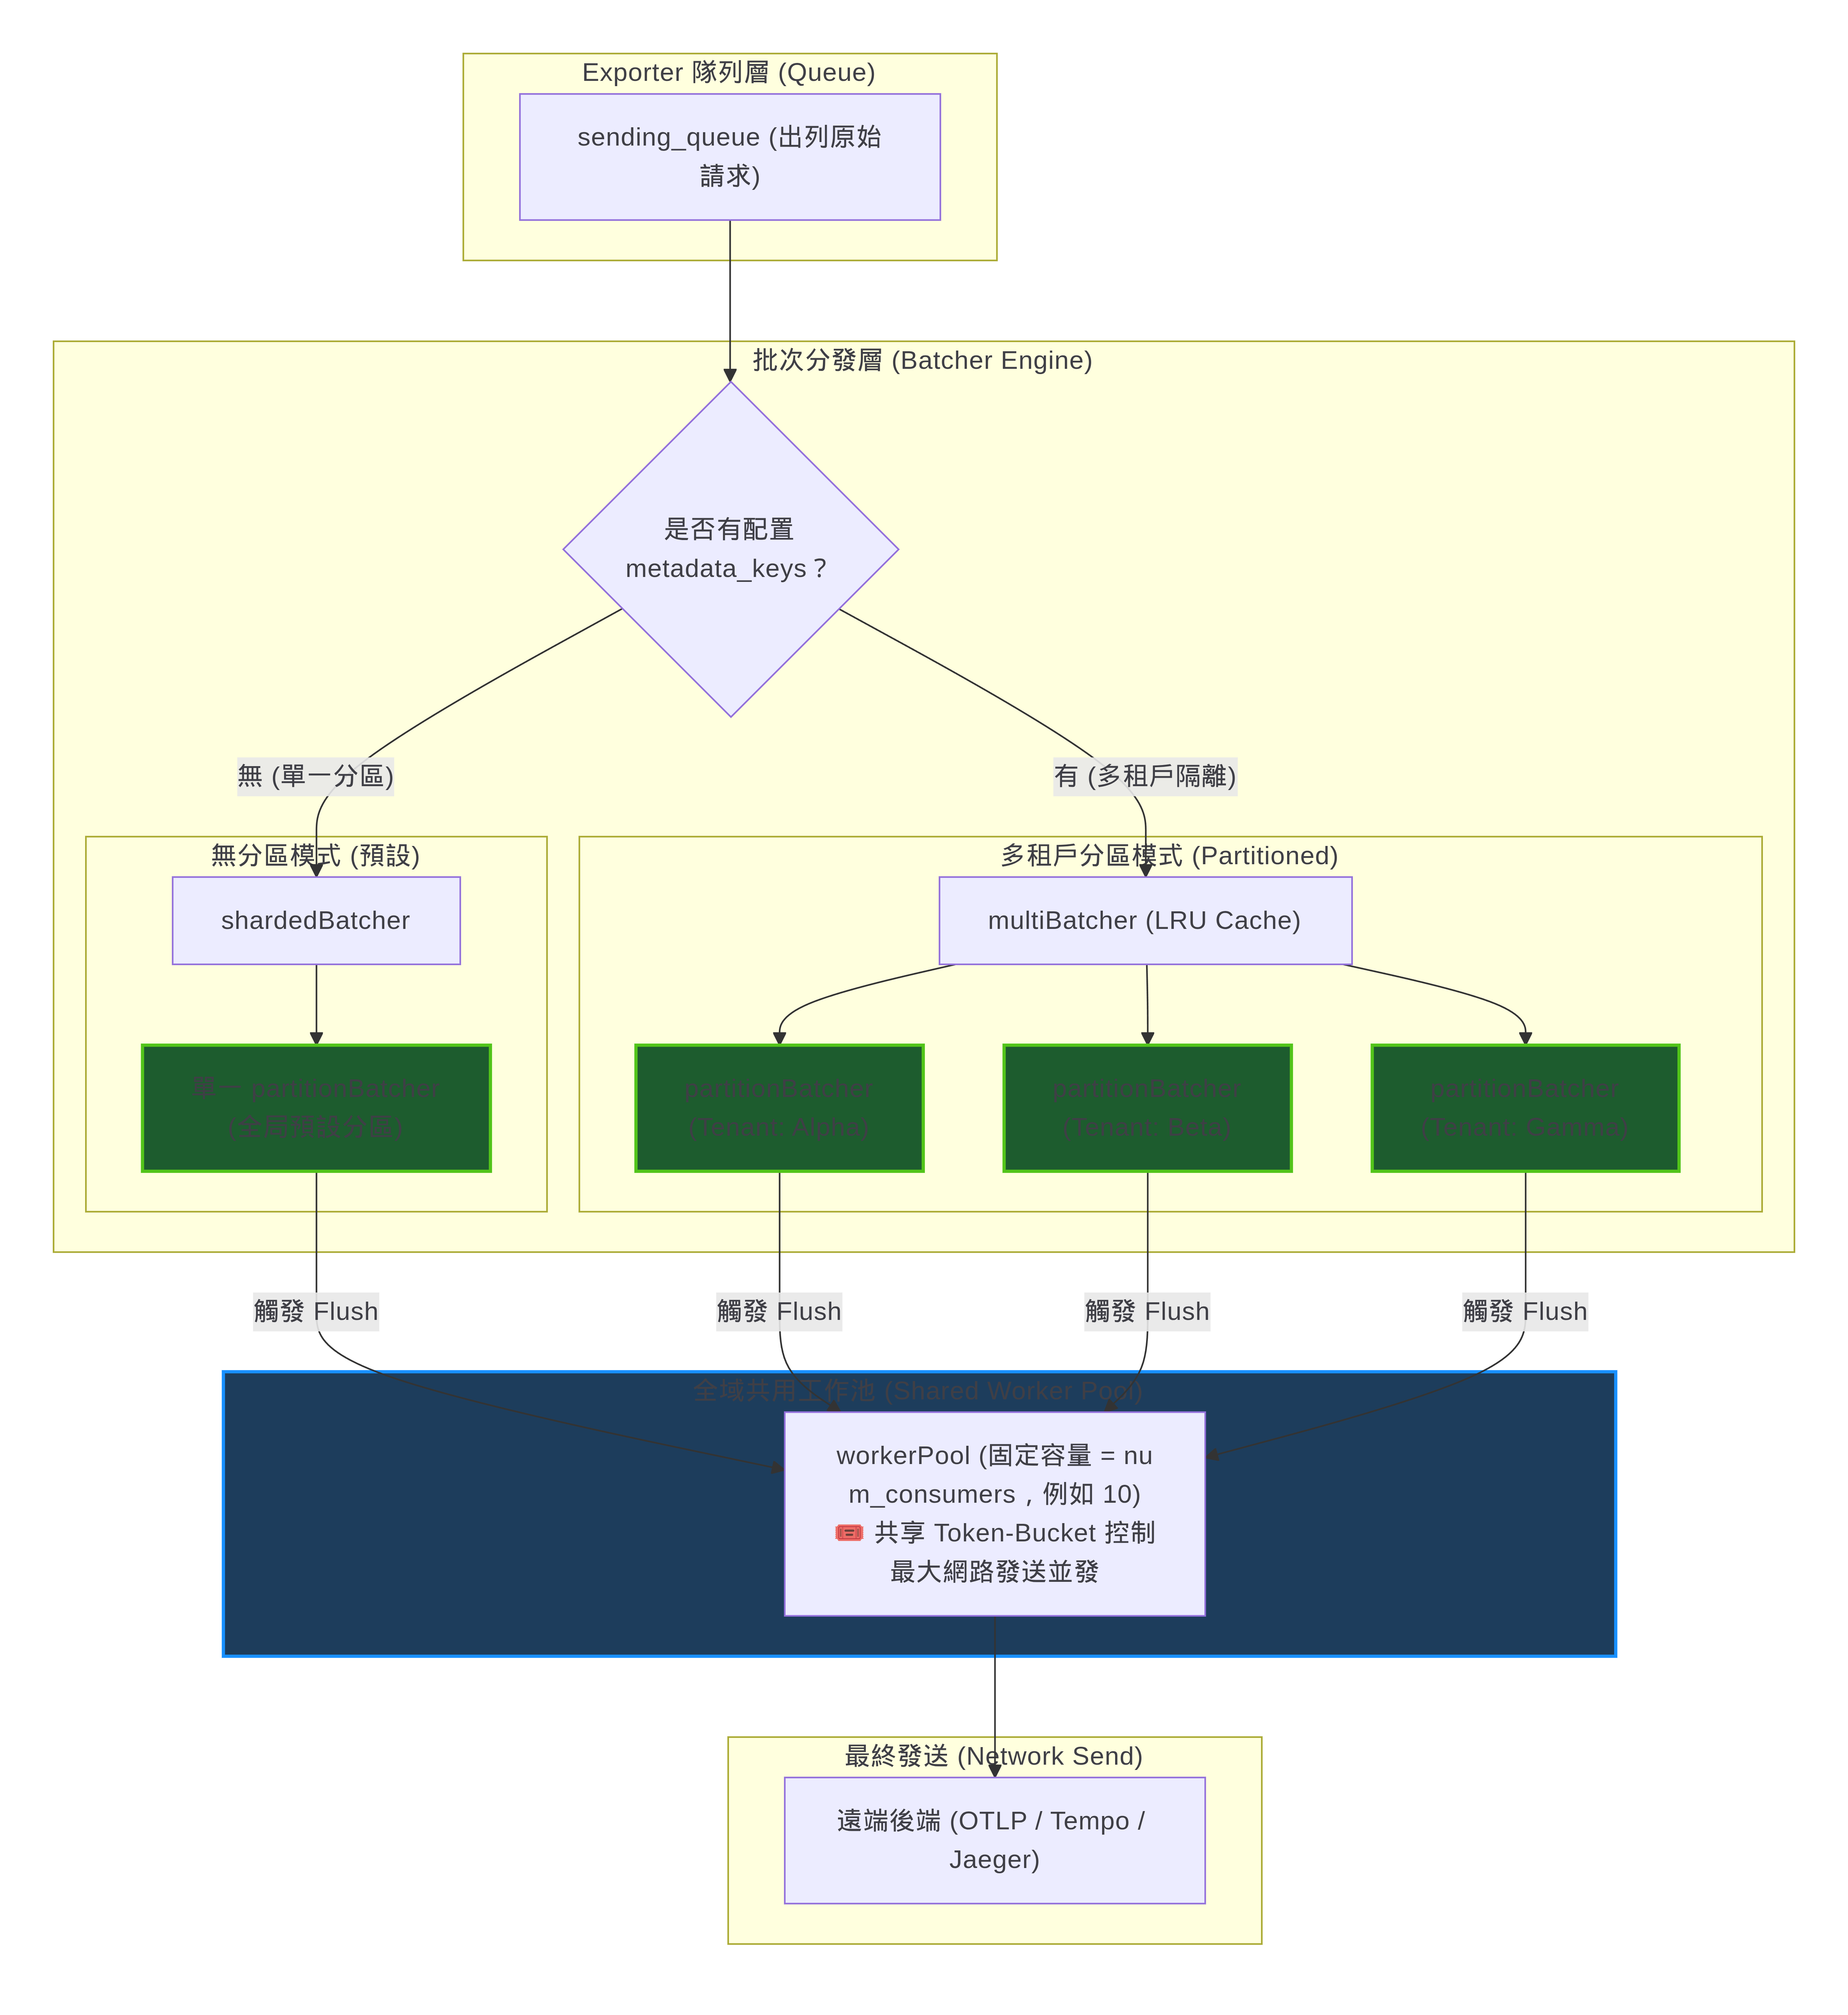
partitionBatcher 內部狀態機流轉機制負責單一分區狀態與定時 Flush 的核心是 partition_batcher.go 中的結構體:
type partitionBatcher struct {
	cfg            BatchConfig
	wp             *workerPool                      // 指向全域共用的 Worker Pool
	sizer          request.Sizer
	consumeFunc    sender.SendFunc[request.Request] // Exporter 的實際發送函式
	currentBatchMu sync.Mutex                       // 保護當前分區的互斥鎖
	currentBatch   *batch                           // 目前正在累積中的 Batch
	timer          *time.Timer                      // 控制 flush_timeout 的定時器
	active         bool
}
當佇列出列並呼叫 b.Consume(ctx, req, done) 時,會進入核心方法 consumeInternal。其狀態流轉決策如下圖所示:
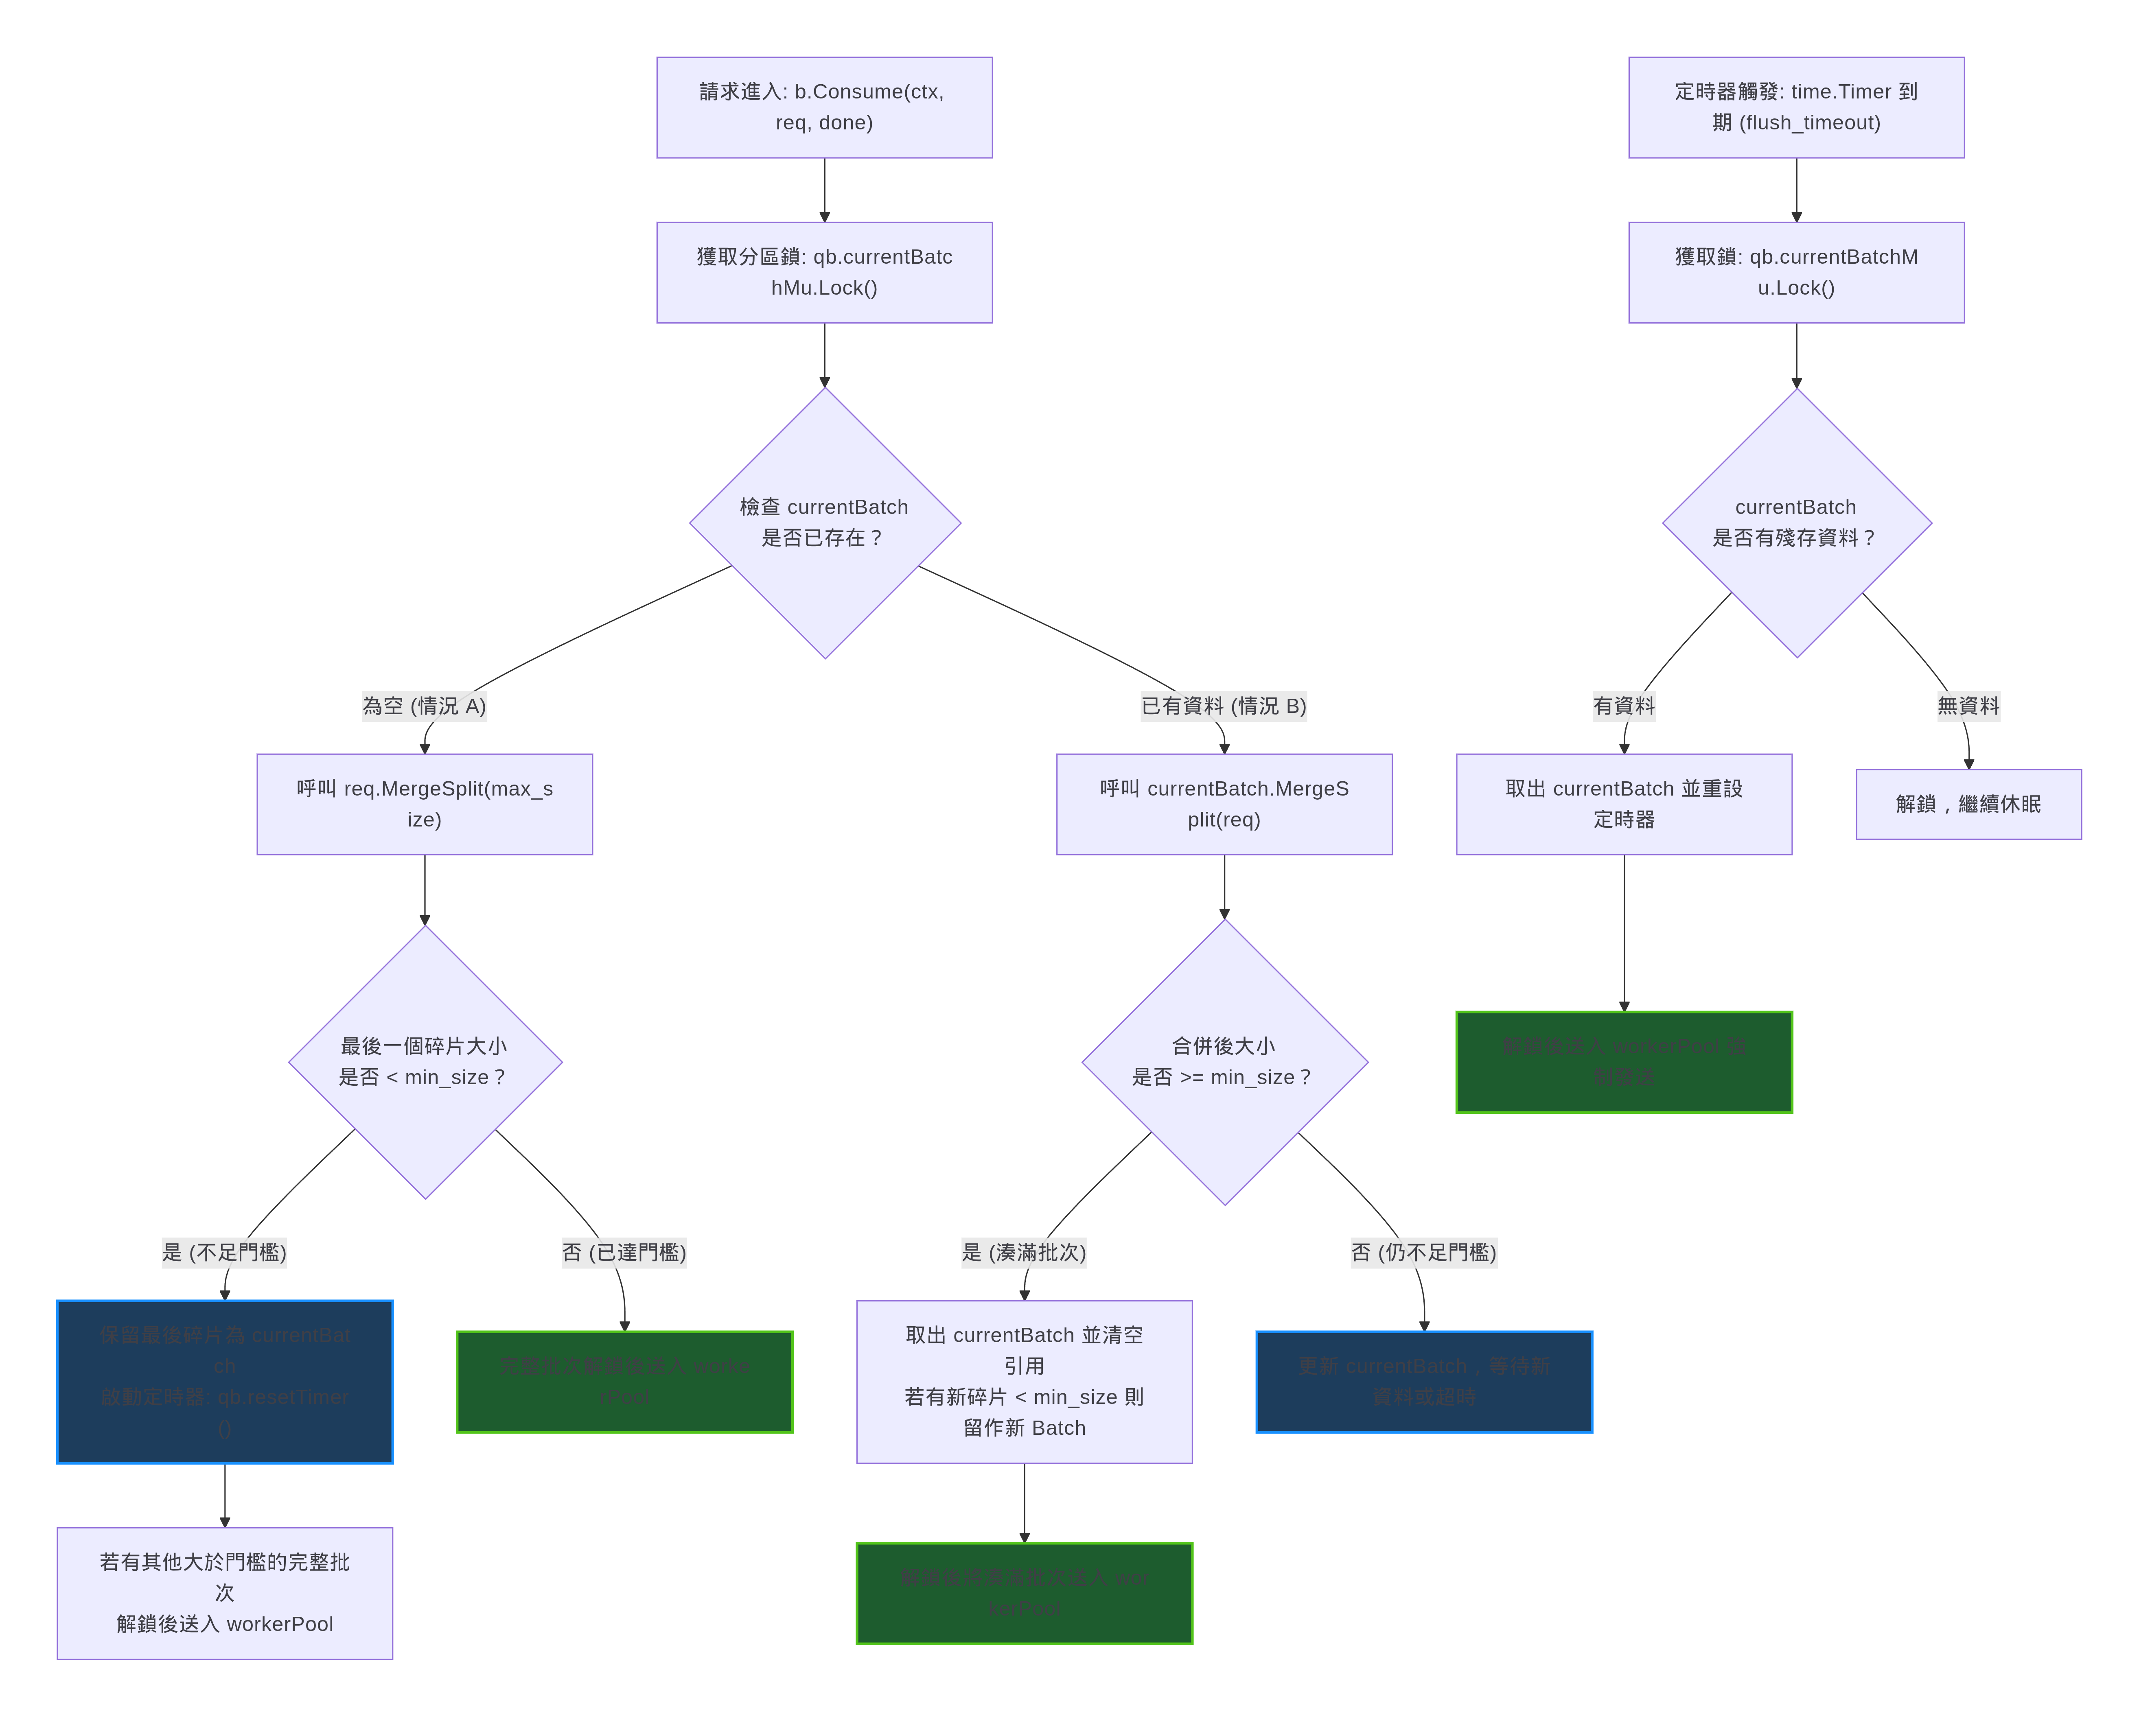
func (qb *partitionBatcher) consumeInternal(ctx context.Context, req request.Request, done queue.Done) bool {
	qb.currentBatchMu.Lock()
	defer qb.currentBatchMu.Unlock()

	// 情況 A:目前沒有累積中的 Batch
	if qb.currentBatch == nil {
		reqList, _ := req.MergeSplit(ctx, int(qb.cfg.MaxSize), qb.cfg.Sizer, nil)
		lastReq := reqList[len(reqList)-1]

		// 檢查最後一個碎片是否小於 MinSize
		if qb.sizer.Sizeof(lastReq) < qb.cfg.MinSize {
			// 不立刻發送,留存為 currentBatch,並重設 FlushTimeout 定時器!
			reqList = reqList[:len(reqList)-1]
			qb.currentBatch = &batch{
				ctx:  ctx,
				req:  lastReq,
				done: multiDone{done},
			}
			qb.resetTimer()
		}

		// 超過 MinSize 的其他完整批次,解鎖後直接調用 qb.flush()!
		for _, r := range reqList {
			qb.flush(ctx, r, done)
		}
		return qb.active
	}

	// 情況 B:已有累積中的 Batch,將新進來的 req 合併進去
	reqList, _ := qb.currentBatch.req.MergeSplit(ctx, int(qb.cfg.MaxSize), qb.cfg.Sizer, req)
	qb.currentBatch.done = append(qb.currentBatch.done, done)

	// 若合併後達到 MinSize 門檻,取出 currentBatch 並呼叫 qb.flush() 送入 workerPool!
    // 剩餘不足 MinSize 的尾端碎片則重設為新的 currentBatch。
}
workerPool 的 Token-Bucket 併發發送模型當批次湊滿或超時觸發 qb.flush() 時,它並不會無限制地 go consumeFunc() 開闢 Goroutine,而是必須向 workerPool 取得執行配額:
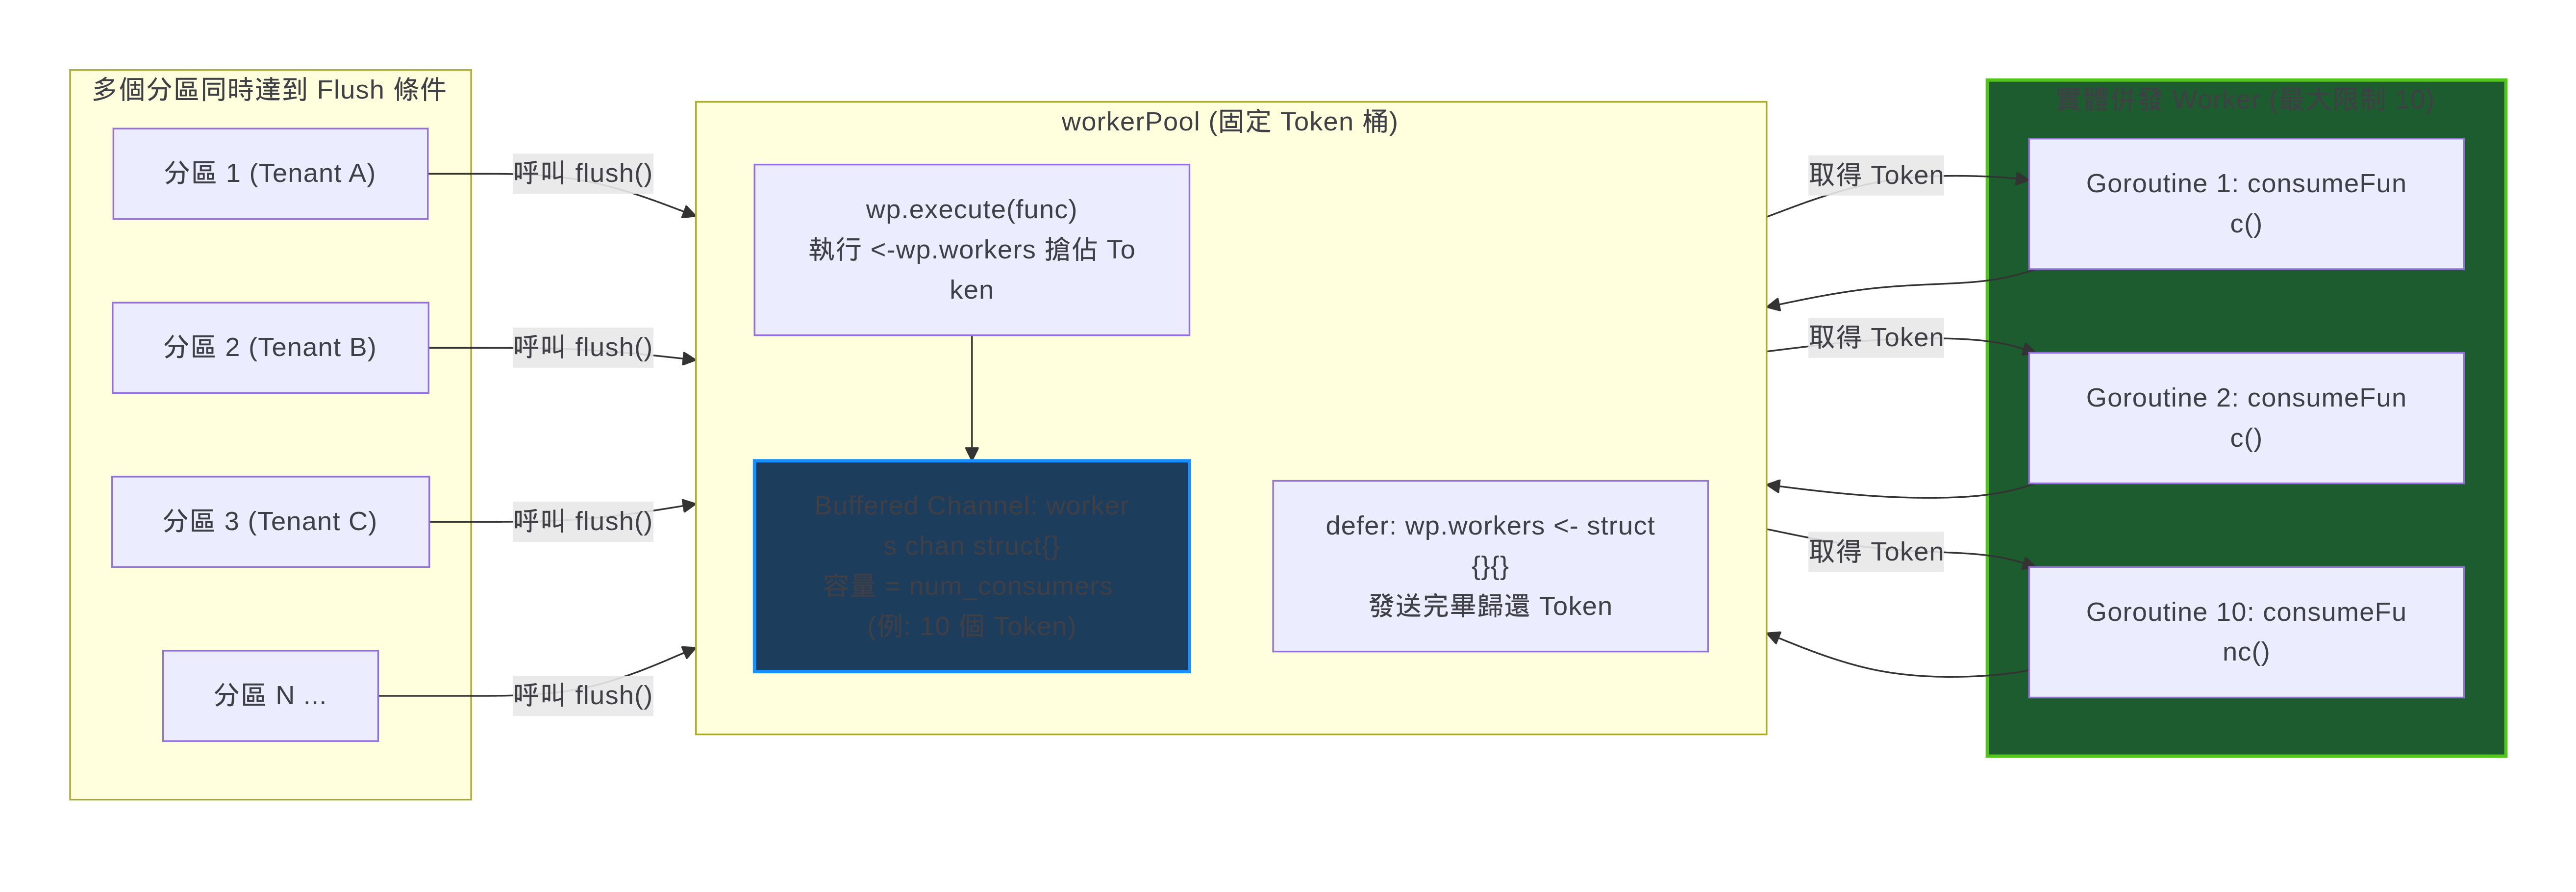
type workerPool struct {
	workers chan struct{} // 帶緩衝的 struct{} Channel,容量為 num_consumers
}

func newWorkerPool(maxWorkers int) *workerPool {
	workers := make(chan struct{}, maxWorkers)
	for range maxWorkers {
		workers <- struct{}{} // 初始化時將 Token 填滿
	}
	return &workerPool{workers: workers}
}

func (wp *workerPool) execute(f func()) {
	<-wp.workers // 搶佔一個 Token 配額;若已達 10 個 Worker 滿載,則此處自然阻塞!
	go func() {
		defer func() {
			wp.workers <- struct{}{} // 網路發送完畢(成功或失敗),立即歸還 Token
		}()
		f()
	}()
}
架構精妙之處:
- Zero Allocation:利用
chan struct{}實作 Token Bucket,無需額外的 Lock 競爭或計數器。- 解耦佇列消費與網路發送:佇列只要負責快速將資料餵給 Batcher 聚合;網路 I/O 阻塞全部由
workerPool自適應調節,永遠維持最佳並發吞吐。
multiDone 與 refCountDone在舊架構中,資料一進 batch processor 就斷開確認了;但在新架構中,若啟用了持久化隊列(如 file_storage)或設定了 wait_for_result: true,系統必須確保「多個原始佇列項目被併成一個 Batch 發送」或「單一超大請求被拆解成多個 Batch 發送」時,每個佇列項目的 Ack/Nack 都是百分之百精確的!
源碼中使用了兩個精巧的裝飾器:
multiDone當 5 個小 Request 合併成 1 個 Batch 發送:
type multiDone []queue.Done

func (mdc multiDone) OnDone(err error) {
	for _, d := range mdc {
		d.OnDone(err) // 當 Batch 發送成功或失敗時,一次性通知所有參與者!
	}
}
refCountDone當 1 個巨型 Request(如 50MB Traces)被 MergeSplit 切成 10 個小批次發送:
type refCountDone struct {
	done     queue.Done
	mu       sync.Mutex
	refCount int64
	err      error
}

func (rcd *refCountDone) OnDone(err error) {
	rcd.mu.Lock()
	defer rcd.mu.Unlock()
	rcd.err = multierr.Append(rcd.err, err)
	rcd.refCount--
	if rcd.refCount == 0 {
		// 只有當全部 10 個切片都完成發送,才真正向佇列提交最終結果!
		rcd.done.OnDone(rcd.err)
	}
}
架構價值:這保證了極致的 Reliability(可靠度)。只要有任何一個切片在網路中失敗,底層持久化佇列就能準確記錄並重新排程重試,徹底告別「靜默丟包」。
multiBatcher 與 LRU 淘汰機制在 Multi-tenancy 環境中,不同租戶(如帶有不同 X-Tenant-ID 或 x-auth-token)不能混成同一批次送往後端。
新模組在 metadata_partitioner.go 中,利用 Varint 長度前綴二進位編碼 生成分區 Key,杜絕了字串拼接可能帶來的碰撞注入:
func (p *metadataKeysPartitioner) GetKey(ctx context.Context, _ request.Request) string {
	kb := make([]byte, 0, 64)
	meta := client.FromContext(ctx).Metadata
	for _, k := range p.keys {
		values := meta.Get(k)
		kb = binary.AppendUvarint(kb, uint64(len(values)))
		for _, val := range values {
			kb = binary.AppendUvarint(kb, uint64(len(val)))
			kb = append(kb, val...)
		}
	}
	return string(kb)
}
在 multi_batcher.go 中,透過 HashiCorp 的 simplelru 控制記憶體上限:
cache, err := lru.NewLRU[string, *partitionBatcher](cacheSize, func(_ string, pb *partitionBatcher) {
    // 當分區數量超過 cacheSize 被驅逐時,自動觸發非同步 Flush,絕不丟失資料!
    mb.wp.execute(pb.shutdownInternal)
})
若某個分區在 idle_timeout(預設 90s)內沒有新資料進來,該分區會被平滑移除並釋放記憶體,完美解決了舊版 multi-shard 記憶體無限洩漏的隱患。
queuebatch 參數全貌與底層行為詳解在 OpenTelemetry Collector 中,queuebatch 是 exporterhelper 內建的核心模組,也是全新 queue_batch processor 的底層引擎。換言之,無論是在 Exporter 的 sending_queue 下,還是在 Processor 的 queue_batch 下,其設定層級、欄位名稱與驗證邏輯都是完全通用且一致的。
# 適用於 Exporter: exporters.<name>.sending_queue
# 或適用於 Processor: processors.queue_batch
enabled: true                       # [bool] 是否啟用隊列 (預設: true)
sizer: requests                     # [enum: requests|items|bytes] 隊列計量單位 (預設: requests)
queue_size: 1000                    # [int64] 隊列最大容量 (單位由 sizer 決定,預設: 1000)
num_consumers: 10                   # [int] 隊列消費端/發送端 Worker 並發數 (預設: 10)
block_on_overflow: false            # [bool] 隊列滿載時是否阻塞呼叫端 (預設: false)
wait_for_result: false              # [bool] 是否等待發送完成才向客戶端回傳 (預設: false)
storage: file_storage/buffer        # [string] 持久化擴充 ID (可選,預設: 無)

batch:                              # [可選區塊] 批次聚合設定 (預設不啟用,填入 batch: {} 啟用)
  enabled: true                     # [bool] 是否啟用批次聚合 (預設: false)
  sizer: items                      # [enum: items|bytes] 批次計量單位 (繼承隊列 sizer,或預設 items)
  min_size: 8192                    # [int64] 觸發 Flush 的最小門檻 (預設: 8192)
  max_size: 0                       # [int64] 批次切分上限,0 為不限制 (預設: 0)
  flush_timeout: 200ms              # [duration] 最長延遲發送時間 (預設: 200ms)

  partition:                        # [可選區塊] 多租戶/標頭獨立分區設定
    metadata_keys:                  # [list of strings] 用於分區的 Client Metadata 標頭鍵名
      - X-Tenant-ID
      - x-auth-token
    cache_size: 10000               # [int] LRU 快取保留的最大活躍分區數 (預設: 10000)
    idle_timeout: 90s               # [duration] 空分區閒置超時自動清理時間 (預設: 90s)
| 欄位名稱 | 型別 | 預設值 | 合法選項 / 範圍 | 底層對應 Go Struct | 行為解析與生產環境建議 |
|---|---|---|---|---|---|
enabled |
bool |
true |
true, false |
Config |
是否啟用發送隊列。若設為 false,資料將繞過佇列與批次器,直接同步呼叫 Exporter 發送(此時 num_consumers、batch 等均失效)。 |
sizer |
string |
requests |
requests, items, bytes |
Config.Sizer |
決定 queue_size 的計量單位:• requests:以進來的 Request 批次數計數(吞吐最高、CPU 消耗近乎 0,但無法防範單一超大 Request 撐爆記憶體)。• items:以最小遙測單元(Spans/Points/Logs)計數。• bytes:以序列化後的 Protobuf 位元組大小計數(記憶體控制最精確,但需負擔序列化 CPU 計算)。 |
queue_size |
int64 |
1000 |
大於 0 的整數 | Config.QueueSize |
隊列的最大容納上限,數值單位由上述 sizer 決定。• 若搭配持久化儲存(storage),代表磁碟緩衝區允許容納的請求上限。• ⚠️ 遷移時若將 batch 移入 exporter,請務必重新評估此數值(詳見第六章)。 |
num_consumers |
int |
10 |
大於 0 的整數 | Config.NumConsumers |
佇列的最大並發消費數。• 重要原始碼行為:當啟用批次(batch)且未設定分區時,底層會將隊列消費者強制設為 1,而將 num_consumers 的數值指派給 workerPool 作為最終發送網路請求的並行 Worker 數,避免多消費者組裝批次時產生資源爭搶。 |
block_on_overflow |
bool |
false |
true, false |
Config.BlockOnOverflow |
隊列滿載(達到 queue_size)時的溢位背壓策略:• false(預設,Fail-fast):立即拒絕請求並拋出可重試錯誤,使 Receiver 快速向 Client 回傳 HTTP 429/503。• true(Block on deadline):阻塞呼叫端 goroutine,直到隊列釋出空位或 Context Deadline 逾時。 |
wait_for_result |
bool |
false |
true, false |
Config.WaitForResult |
端到端確認機制:• false(預設):資料成功進入隊列就立即向呼叫端回傳成功(非同步入隊)。• true:呼叫端會持續阻塞等待,直到資料真正被消費者取出、完成批次聚合並經由網路成功送到後端(或遭遇永久性失敗)。適合要求嚴格 At-least-once 交付的金融交易級管線。⚠️ 限制:無法與持久化儲存 storage 同時開啟。 |
storage |
string |
none (空) |
任何合法的 Storage 擴充 ID | Config.StorageID |
指定持久化儲存擴充元件(例如 file_storage/persistent)。• 設定後將完全停用 Go 記憶體隊列,改由磁碟檔案儲存。• 實現在進程重啟、Pod 重新調度時的未發送遙測資料恢復。 |
批次設定位於 batch 子區塊下。在預設情況下,batch 是關閉的;若要以預設值啟用批次,只需在 YAML 中宣告 batch: {} 或 batch: enabled: true。
| 欄位名稱 | 型別 | 預設值 | 合法選項 / 範圍 | 底層對應 Go Struct | 行為解析與生產環境建議 |
|---|---|---|---|---|---|
enabled |
bool |
false |
true, false |
Config.Batch |
是否啟用 Exporter 層級批次聚合。在 v0.171.0 之後大部分 Exporter 將預設改為 true。 |
sizer |
string |
繼承 / items |
items, bytes |
BatchConfig.Sizer |
批次聚合與切分的度量單位。• 不可設為 requests(批次本身就是要聚合 requests,故只能計量內容物)。• 繼承邏輯:若未特別指定,會自動繼承自外層隊列的 sizer;若外層隊列為 requests 或未指定,則預設回退為 items。 |
min_size |
int64 |
8192 |
非負整數 ($\ge 0$) | BatchConfig.MinSize |
觸發主動 Flush 的最小門檻。• 當累積中的批次大小(Items 數或 Bytes 數)達到或超過此數值時,立即觸發 flush() 並交由 workerPool 送出。• ⚠️ 若 batch.sizer 與外層隊列 sizer 相同,min_size 必須 $\le$ queue_size,否則會觸發 Config 驗證失敗。 |
max_size |
int64 |
0 (不限制) |
非負整數 ($\ge 0$) | BatchConfig.MaxSize |
Batch Splitting(批次切分上限):• 0:不限制最大大小,不進行切分。• > 0:啟用 MergeSplit 自動切分演算法。傳入的單一請求若超過此數值,會被強制拆分成多個小於等於 max_size 的獨立請求。• ⚠️ 若大於 0,必須滿足 max_size >= min_size。通常搭配 sizer: bytes 設為 4194304(4MB)以防禦 gRPC 接收上限。 |
flush_timeout |
duration |
200ms |
大於 0 的時間長度 | BatchConfig.FlushTimeout |
最長延遲等待時間。• 即使批次累積的資料量尚未達到 min_size,一旦自上一批發送後經過此時間長度,定時器(time.Timer)將強制觸發 Flush,保證遙測數據的即時性,避免低流量時資料卡在記憶體。 |
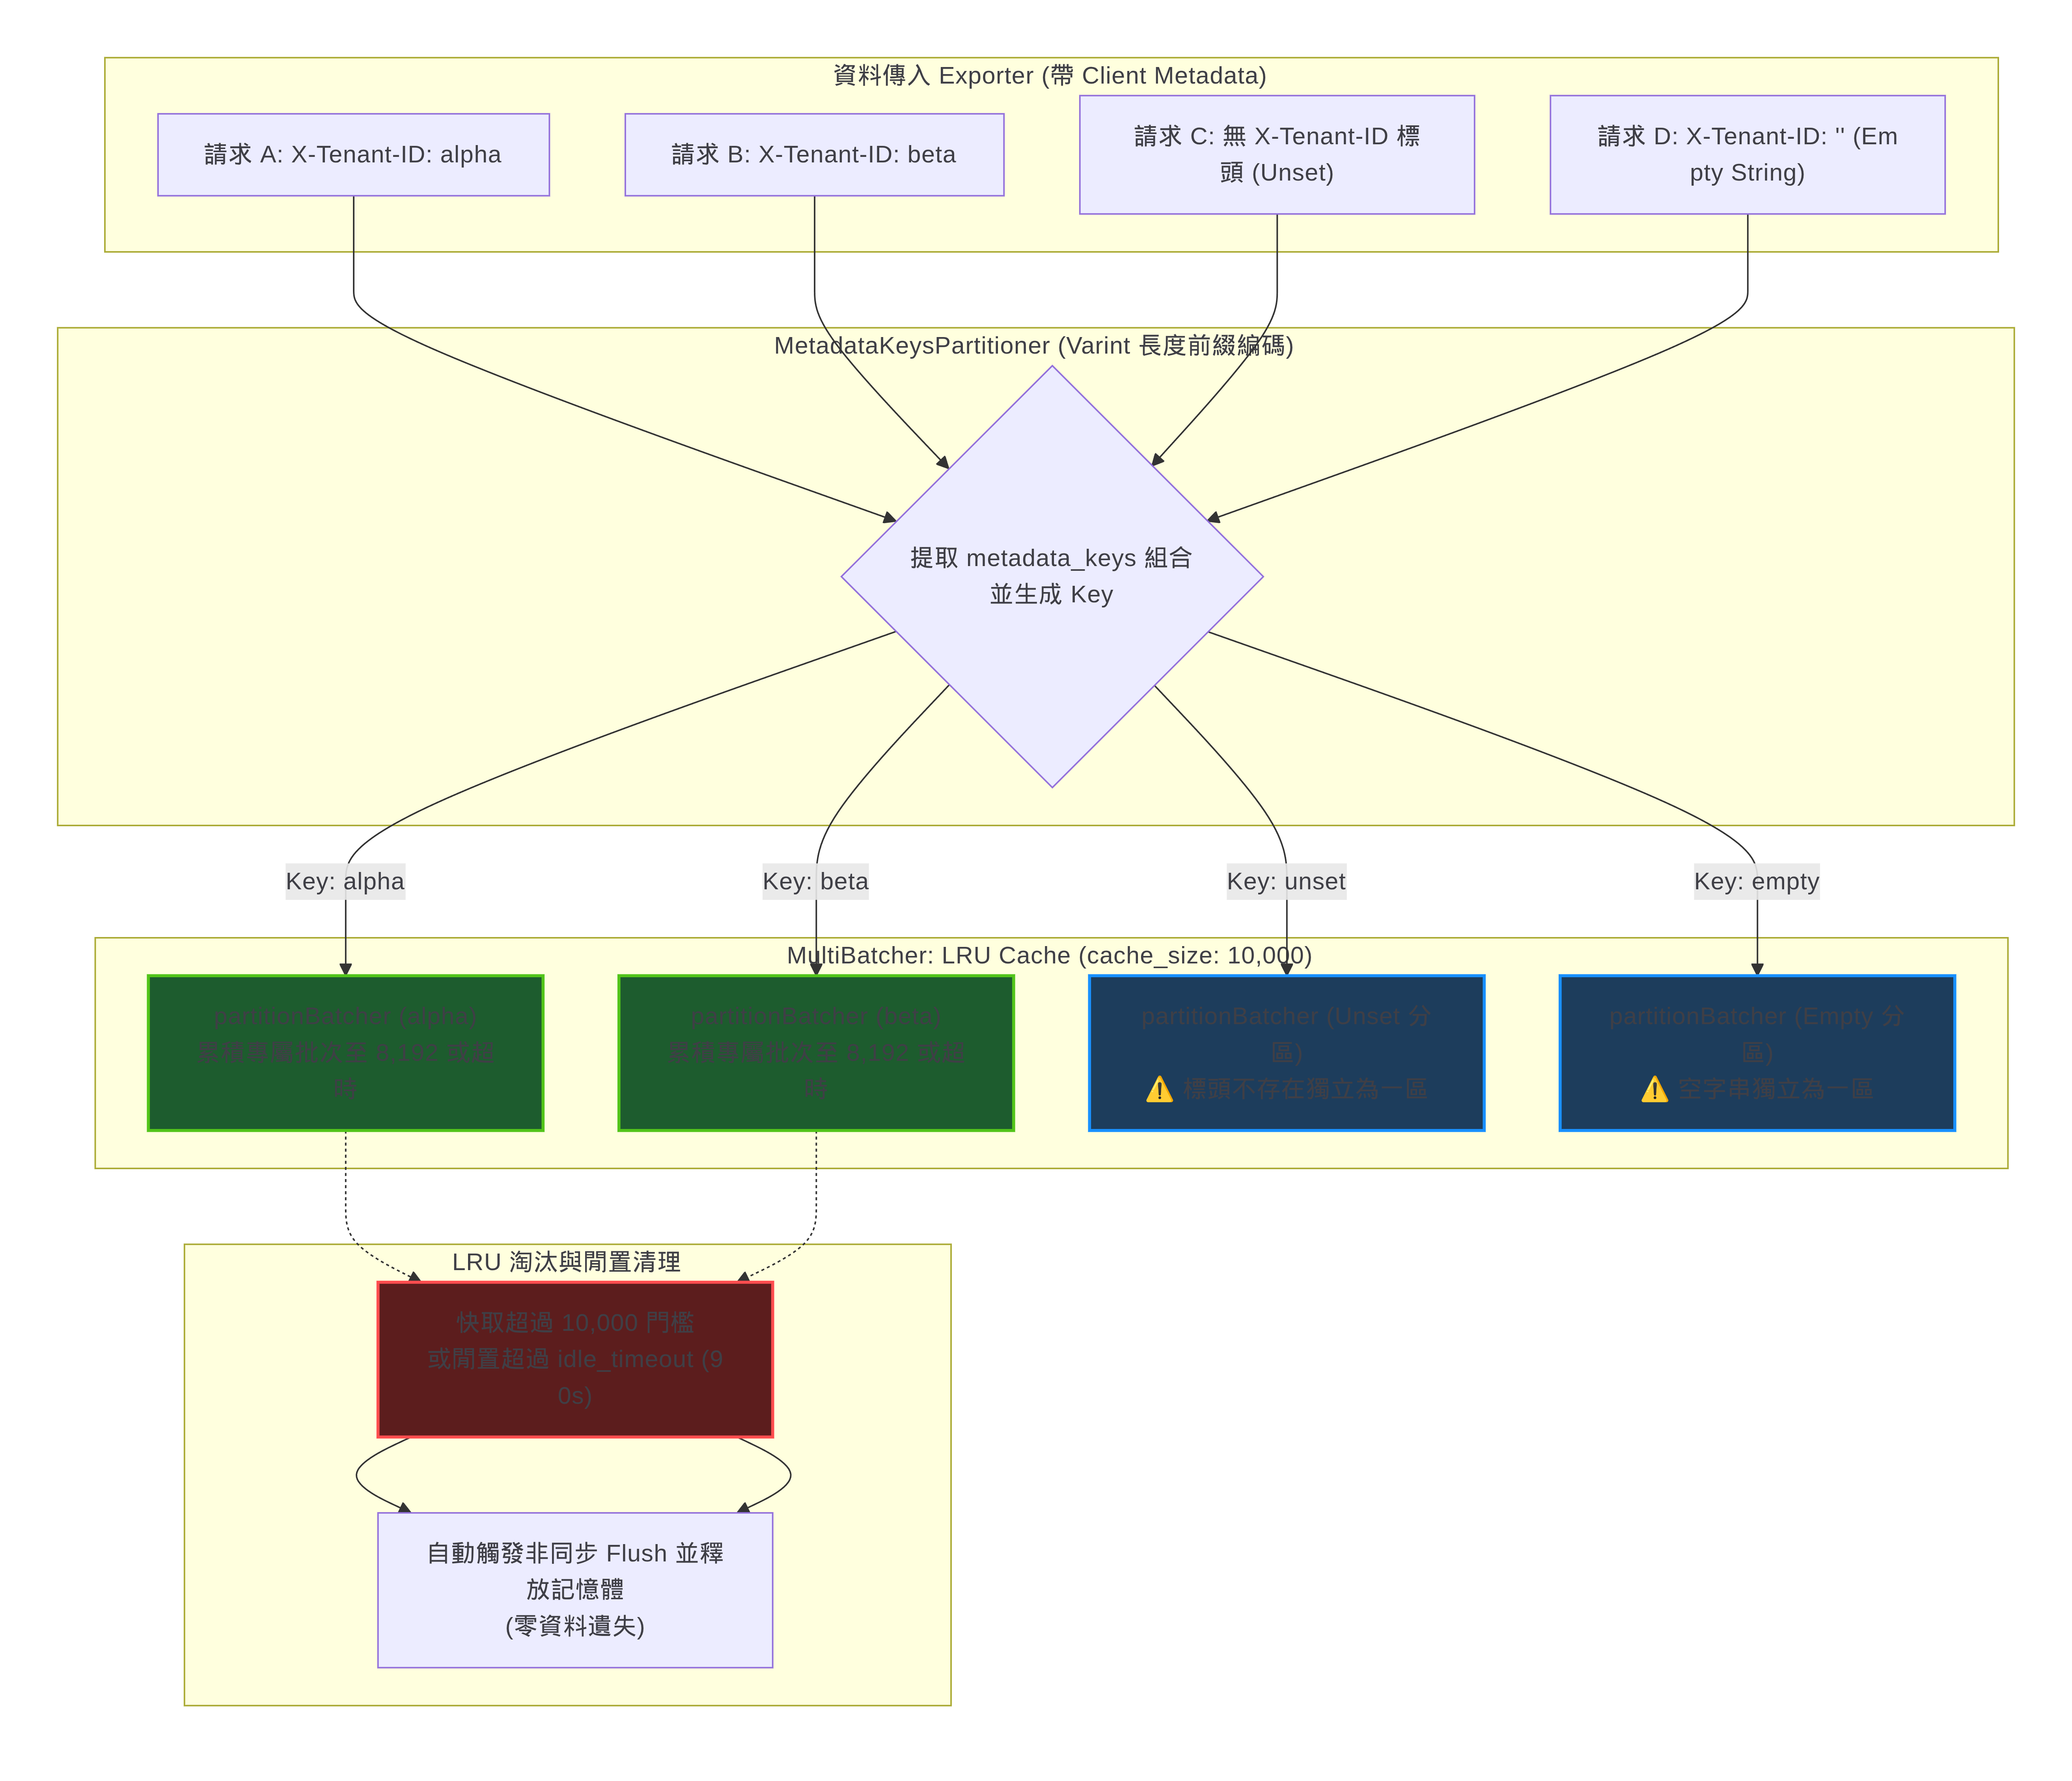
多租戶分區位於 batch.partition 子區塊下。在官方 README(Commit 302c933)與架構設計中,partition 專門解決不同 Tenant、不同 Auth Token 或不同路由上下文的數據隔離打包問題。若未配置分區,所有經過該 Exporter 的資料都會混雜在同一個 Batch 中發送;而當啟用分區時,系統會為每個獨立的標頭特徵組合維護專屬的批次器。
| 欄位名稱 | 型別 | 預設值 | 合法選項 / 範圍 | 底層對應 Go Struct | 官方規範行為與實戰注意事項 |
|---|---|---|---|---|---|
metadata_keys |
[]string |
[] (空列表) |
字串陣列 | PartitionConfig.MetadataKeys |
用於切分獨立批次的 Client Metadata 鍵名列表(如 ["X-Tenant-ID", "x-auth-token"])。• 預設值:為空。為空時全局僅使用單一 Batcher 實例,所有請求共用聚合。• Case-insensitive(大小寫不敏感):設定 X-Tenant 或 x-tenant 均等價。• 重複檢查:若陣列中存在重複鍵名(不分大小寫),啟動驗證時直接拒絕並拋錯:duplicate entry in metadata_keys。• 未設 vs 空值的獨立性(關鍵邊界條件):官方規範明訂 Empty value(值為空字串 "")與 Unset metadata(完全未傳入該標頭)被視為兩種完全獨立的 Distinct Cases,絕不會混在同一批次中發送! |
cache_size |
int |
10000 |
大於 0 的整數 | PartitionConfig.CacheSize |
LRU 快取保留的最大活躍分區 Batcher 實例數。• 必須為正整數。• 淘汰與 Flush 機制:當活躍租戶分區數超過此上限時,LRU 自動淘汰 LRU (Least Recently Used) 分區。淘汰時會立刻觸發該分區的非同步 Flush,確保資料安全送出,絕不發生記憶體遺失。• 專用觀測指標:當前活躍分區數與配置容量會透過以下兩個 Prometheus 指標導出:- otelcol_exporter_queue_batch_partition_cache_size- otelcol_exporter_queue_batch_partition_cache_capacity |
idle_timeout |
duration |
90s |
大於 0 的時間長度 | PartitionConfig.IdleTimeout |
分區閒置超時自動清理週期。• 必須為正時間長度。• 防止 Partition Churning:官方特別警告,此數值必須設定高於上游 Data arrival interval(資料到達間隔)!例如在 Prometheus 拉取架構中,常見的 Scrape 間隔為 15s~60s;若將 idle_timeout 設為 10s,會導致分區在兩次 Scrape 之間被銷毀,下一個週期又重新創建,引發高頻的物件配置與 Partition Churning。預設 90s 是安全跨越 60s 抓取週期的黃金數值。 |
NewMetadataKeysMergeCtx)在同一個分區內,多筆請求會被聚合成一個大的 request.Request,那最終送往後端的 Context(帶有的 HTTP 標頭)該以誰為準?
在 metadata_partitioner.go 原始碼中,設計了專屬的 Context 合併函式:
func NewMetadataKeysMergeCtx(keys []string) func(context.Context, context.Context) context.Context {
	if len(keys) == 0 {
		return nil
	}
	return func(ctx1, _ context.Context) context.Context {
		m1 := client.FromContext(ctx1).Metadata
		m := make(map[string][]string, len(keys))
		for _, key := range keys {
			v1 := m1.Get(key)
			if len(v1) > 0 {
				m[key] = v1
			}
		}
		// 僅提取 metadata_keys 指定的標頭生成全新的乾淨 Context,防止污染!
		return client.NewContext(
			context.Background(),
			client.Info{Metadata: client.NewMetadata(m)},
		)
	}
}
metadata_keys 內的標頭,既保證了下游 Exporter 能拿到正確的 Tenant ID或授權 Token,又杜絕了不同請求間非關鍵私人 Header 的交互洩漏。exporters:
otlp/multi_tenant:
endpoint: tempo.internal:4317
sending_queue:
enabled: true
sizer: items
queue_size: 200000
batch:
enabled: true
sizer: items
min_size: 5000
flush_timeout: 200ms
partition:
metadata_keys:
- X-Tenant-ID # 依據客戶端租戶 ID 切分批次
- authorization # 依據授權 Token 切分批次
cache_size: 2000 # 保留最多 2000 個活躍租戶分區
idle_timeout: 120s # 2 分鐘無資料自動清理釋放記憶體
metadata_keys 從網路封包到記憶體分區的端到端範例許多人看到 metadata_keys 常會疑惑:「這些 keys 到底是從哪裡來的?在 HTTP 或 gRPC 封包裡到底長什麼樣子?Collector 又是怎麼把它們拆成不同 Batch 的?」
以下透過一個完整的電商多租戶與多環境情境,展示資料從客戶端送出到 Collector 內部切分的全過程:
假設有三間不同租戶的微服務,同時向 Collector(0.0.0.0:4318)發送 Traces:
客戶端 1(租戶 Alpha / 生產環境)發出的 HTTP Request:
POST /v1/traces HTTP/1.1
Host: otel-collector:4318
Content-Type: application/x-protobuf
X-Tenant-ID: tenant-alpha
X-Environment: production
Authorization: Bearer alpha-secret-token

[Protobuf 二進位資料: 包含 50 個 Spans]
客戶端 2(租戶 Beta / 測試環境)發出的 HTTP Request:
POST /v1/traces HTTP/1.1
Host: otel-collector:4318
Content-Type: application/x-protobuf
X-Tenant-ID: tenant-beta
X-Environment: staging
Authorization: Bearer beta-secret-token

[Protobuf 二進位資料: 包含 120 個 Spans]
客戶端 3(遺留舊服務 / 未帶租戶標頭)發出的 HTTP Request:
POST /v1/traces HTTP/1.1
Host: otel-collector:4318
Content-Type: application/x-protobuf

[Protobuf 二進位資料: 包含 20 個 Spans]
[!WARNING] 重要避坑:在 OpenTelemetry Collector 中,Receiver 預設不會把 HTTP Header 或 gRPC Metadata 傳遞到 Pipeline 的 Context 內!
若要讓metadata_keys生效,必須在 Receiver 明確宣告include_metadata: true,否則 Context 永遠抓不到標頭!
receivers:
  otlp:
    protocols:
      http:
        endpoint: 0.0.0.0:4318
        include_metadata: true  # 🚨 關鍵!必須開啟才會將 HTTP Header 寫入 Context
      grpc:
        endpoint: 0.0.0.0:4317
        include_metadata: true  # 🚨 關鍵!必須開啟才會將 gRPC Metadata 寫入 Context
當設定了 include_metadata: true 後,Receiver 會呼叫 client.NewContext(ctx, client.Info{Metadata: ...}),將所有傳入的標頭封裝進 Go 的 Context 之中。
partition 設定我們希望針對 X-Tenant-ID 與 X-Environment 兩個維度做隔離打包:
exporters:
  otlp/tempo:
    endpoint: tempo-distributor:4317
    sending_queue:
      enabled: true
      batch:
        enabled: true
        sizer: items
        min_size: 5000
        flush_timeout: 500ms
        partition:
          metadata_keys:
            - X-Tenant-ID
            - X-Environment
          cache_size: 1000
          idle_timeout: 90s
multiBatcher 記憶體內的二進位編碼與實例對照表當上述三筆請求通過 Exporter 時,metadataKeysPartitioner.GetKey() 會透過長度前綴編碼生成分區 Hash Key,並在 LRU Cache 中維護完全隔離的 partitionBatcher 實例:
| 請求來源 | 提取到的 Client Metadata | 底層 Varint 二進位編碼 Key(示意) | 記憶體中對應的獨立實例 | 獨立累積狀態 (Items / Timer) |
|---|---|---|---|---|
| 客戶端 1 | X-Tenant-ID: tenant-alphaX-Environment: production |
\x01\x0c"tenant-alpha"\x01\x0a"production" |
partitionBatcher #1(專屬 Alpha 產線區) |
目前累積 3,450 / 5,000 itemsTimer: 倒數 320ms |
| 客戶端 2 | X-Tenant-ID: tenant-betaX-Environment: staging |
\x01\x0b"tenant-beta"\x01\x07"staging" |
partitionBatcher #2(專屬 Beta 測試區) |
目前累積 5,000 / 5,000 items💥 達到 min_size,觸發 Flush! |
| 客戶端 3 | 未帶有任何租戶與環境標頭 (Unset) | \x00\x00(鍵數量為 0) |
partitionBatcher #3(專屬 Unset 隔離區) |
目前累積 20 / 5,000 itemsTimer: 倒數 480ms |
隔離成效:
- 資料互不污染:租戶 Beta 的資料即便量大湊滿 5,000 筆觸發 Flush,也絕對不會把租戶 Alpha 累積中的 3,450 筆資料提前帶走。
- 下游精準授權與路由:當
partitionBatcher #2觸發 Flush 時,藉由NewMetadataKeysMergeCtx,送往下游 Tempo / Mimir 的 gRPC 呼叫中將精確帶上X-Tenant-ID: tenant-beta標頭,下游的分散式儲存即可直接依據此 Header 寫入對應租戶的隔離 Bucket!
Collector 在啟動階段會呼叫 Config.Validate()、BatchConfig.Validate() 與 PartitionConfig.Validate() 進行嚴格的靜態檢查。以下整理出所有隱含的約束與報錯訊息對應表:
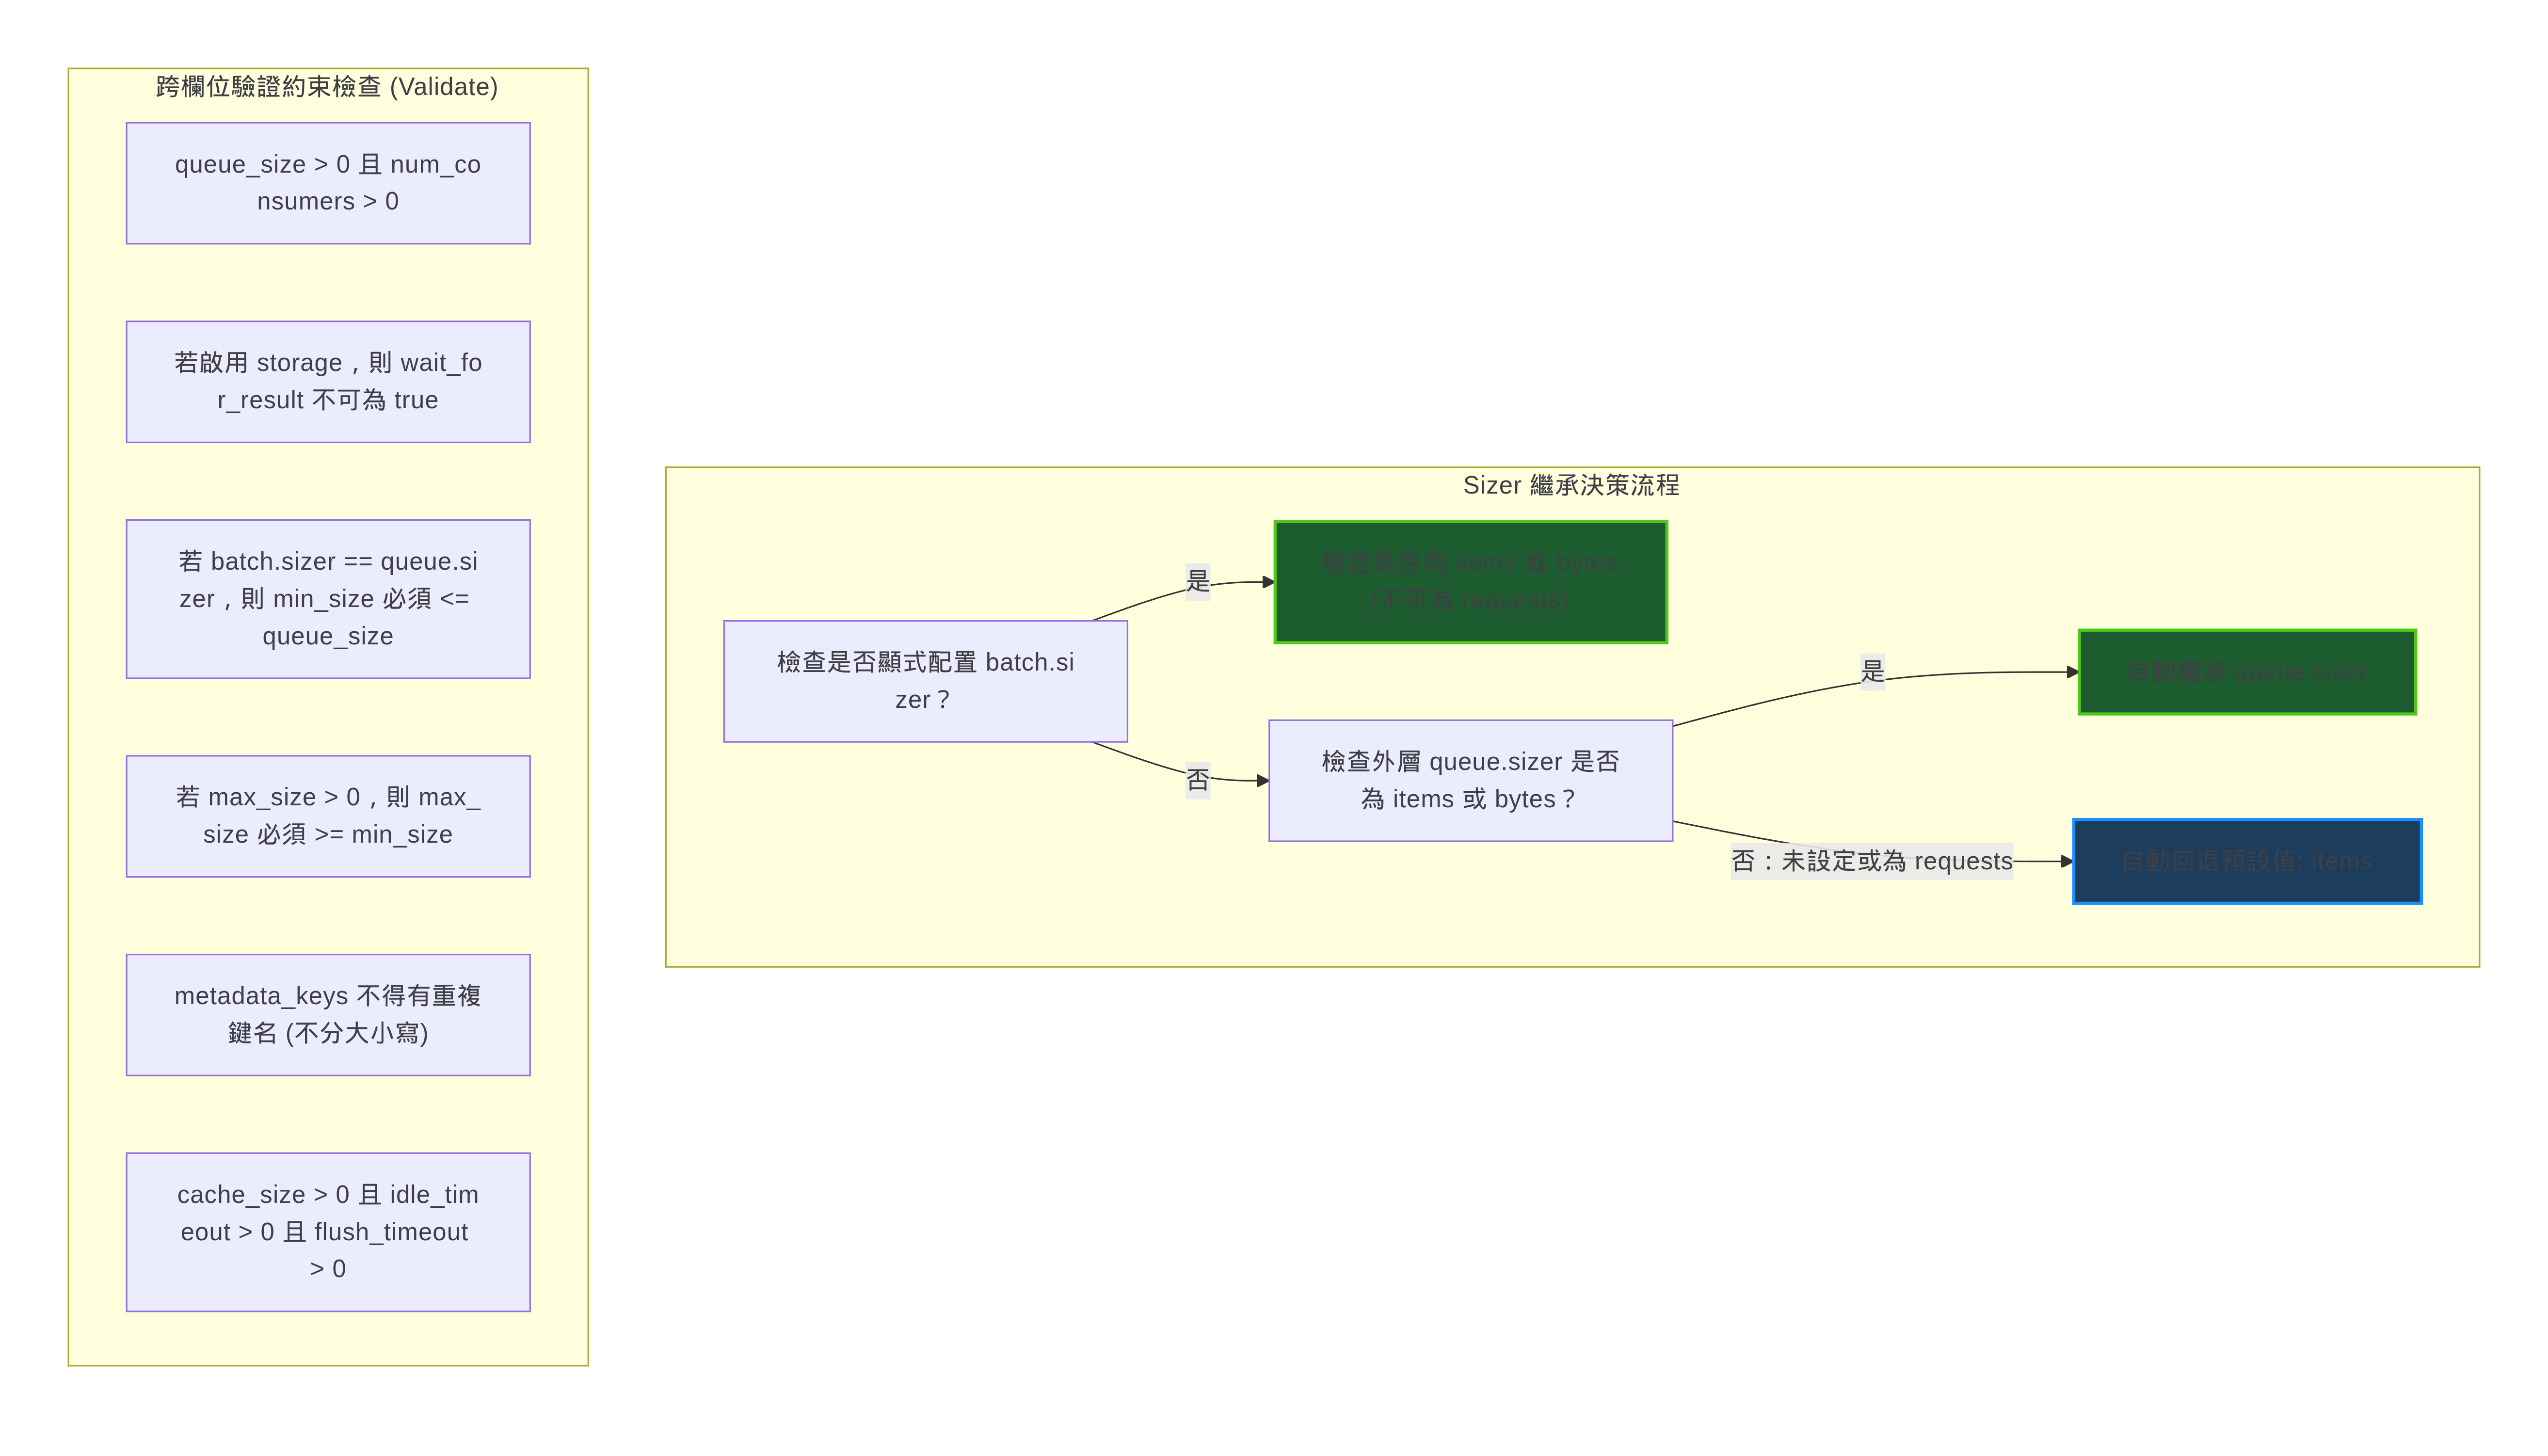
| 條件與規則 | 違規情境範例 | Collector 啟動報錯訊息 |
|---|---|---|
batch.sizer 限制 |
在 batch.sizer 填寫了 requests |
`batch` supports only `items` or `bytes` sizer, found "requests" |
| 容量覆蓋衝突 | batch.sizer 與隊列 sizer 均為 items,但 min_size: 10000、queue_size: 5000 |
`min_size` must be less than or equal to `queue_size` |
| 切分區間顛倒 | 設定了 min_size: 8192,但 max_size: 4000 |
`max_size` (4000) must be greater or equal to `min_size` (8192) |
| 持久化與同步等待衝突 | 同時啟用了 storage: file_storage 與 wait_for_result: true |
`wait_for_result` is not supported with a persistent queue configured with `storage` |
| 標頭鍵名重複 | metadata_keys: ["X-Tenant", "x-tenant"] |
duplicate entry in metadata_keys: "x-tenant" (case-insensitive) |
| 正數驗證 | queue_size: 0 或 num_consumers: -1 |
`queue_size` must be positive / `num_consumers` must be positive |
| 超時長度驗證 | flush_timeout: 0s 或 idle_timeout: 0s |
`flush_timeout` must be positive / `idle_timeout` must be positive |
這是所有 SRE 與平台工程師在 2026~2027 年升級 OTel Collector 時最容易踩中的致命雷區。官方在公告中特別以專門章節《Queue capacity after migration》提出嚴正警告:將批次處理移入 sending_queue,同時也將批次移到了隊列的「另一側(the other side of the queue)」!
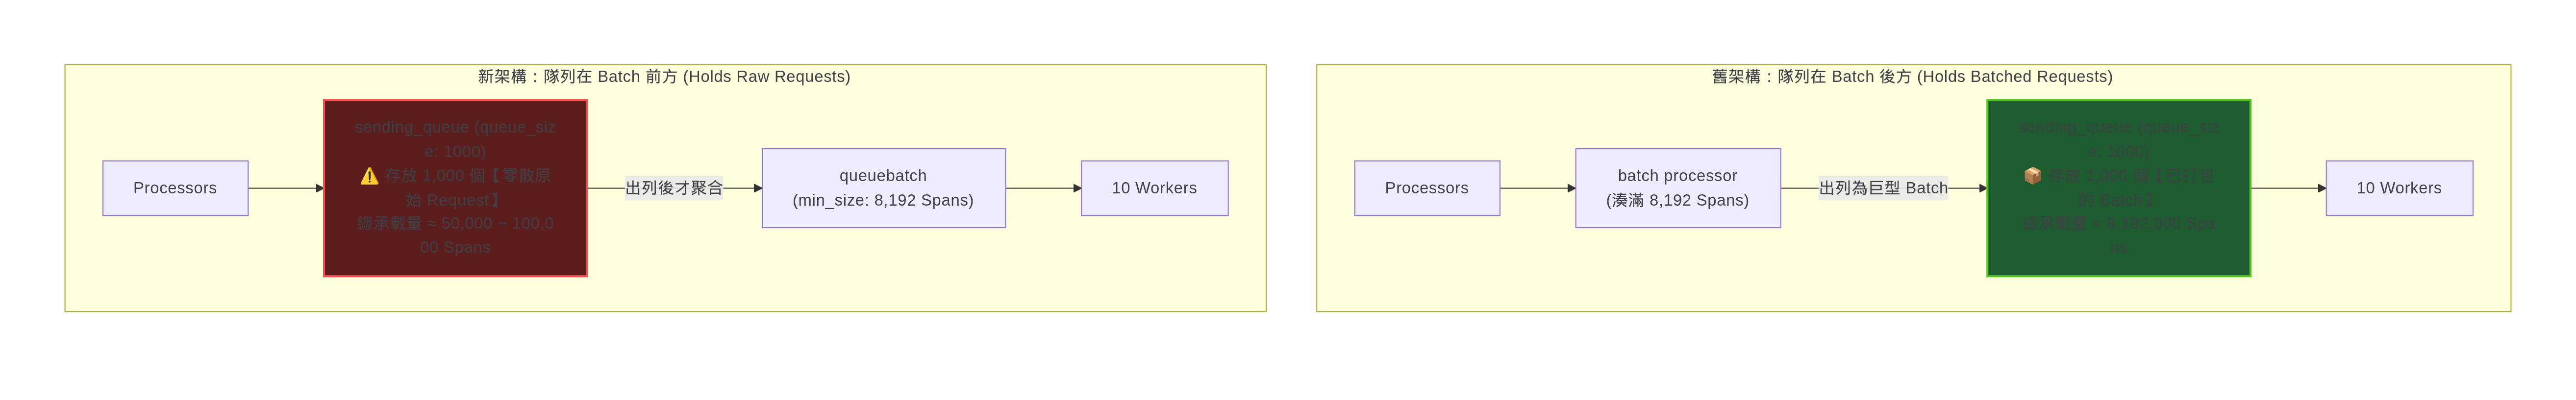
在舊版典型的 batch processor 管線中,Exporter 的 sending_queue 出現在 batch processor 之後:
batch processor 打包好的大型 Requests(例如每包 8,192 items)。預設 queue_size: 1000 可以容納高達 800 萬筆遙測資料: 舊隊列容量舊隊列容量=1000×8192=8,192,000 Spansbatch processor」並「在 Exporter 啟用 batch: enabled: true」,卻直接繼承了預設的 queue_size: 1000(且預設 sizer: requests): 新隊列容量新隊列容量=1000×100=100,000 Spans 整體隊列可容納的資料總量暴跌了 98.7%! 相同的 queue_size: 1000 在以 requests 計算時,實際緩衝的資料量少得可憐。一旦下游後端出現幾秒鐘的網路微抖動,隊列瞬間被打滿;若 block_on_overflow: false(預設),Collector 就會直接開始瘋狂丟包,產生大量的 otelcol_exporter_enqueue_failed_requests 報錯!官方明確指出,在遷移至 sending_queue 批次時,必須考慮提高 queue_size 來容納合適數量的未批次請求。對於 In-memory Queue 場景,容量規劃應遵循兩大核心法則:
num_consumers Busy): 隊列中緩衝的未批次資料量,理想上至少要能讓所有 num_consumers 都能持續滿載並發送批次: 最低工作水位最低工作水位≥num_consumers×min_sizeblock_on_overflow),必須在最低水位之上額外分配隊列空間,用以在下游網路抖動、短暫超時或重試期間暫存新進資料,避免請求直接被拒絕或卡死上游。當 queue_size 改用 items 計量時,請求本身的批次大小就不再造成容量波動。以 Items 或 Bytes 計算的隊列,能讓 sending_queue 的記憶體成本完全透明化(Explicit Memory Costs),不再像 Requests 計量那樣忽大忽小、不可預測:
exporters:
  <exporter>:
    sending_queue:
      sizer: items            # 佇列以 items 計量,不再以 requests 次數計算
      queue_size: 100_000      # 總容量 10 萬個 items (約可容納 50~100 個 SDK 批次)
      num_consumers: 10       # 10 個併發 Worker 負責導出批次
      batch:
        enabled: true
        sizer: items          # 導出批次以 items 計量
        min_size: 5_000       # 湊滿 5,000 items 立即導出
使用 bytes 的好處是,當下游後端(如 Jaeger、Tempo、Kafka、雲端可觀測性後端)的接收限制也是以位元組為單位時,能夠完美貼合限制。透過設定 max_size,可以保證每一筆送出的網路請求都絕不超過後端配額:
exporters:
  <exporter>:
    sending_queue:
      sizer: bytes            # 佇列以 bytes 為單位計量
      queue_size: 100_000_000 # 嚴格緩衝 100 MB (100 MB buffered)
      batch:
        enabled: true
        min_size: 1_000_000   # 累積到 1 MB 才送出批次 (1 MB batches)
        max_size: 10_000_000  # 嚴格限制在 10 MB 以內,保持在後端訊息上限之下
架構價值:
- 記憶體可預期性:
queue_size: 100_000_000讓 SRE 能在 Kubernetes Pod 的 Request/Limit 中精準預留出 100MB 專用隊列記憶體,杜絕因為流量突增導致記憶體不可控膨脹。- 雙邊邊界防禦:
min_size: 1MB保證網路封包具備足夠的高壓縮比;max_size: 10MB透過MergeSplit自動將超大遙測資料在出列時平滑切分,徹底杜絕 gRPC 4MB 或後端 HTTP Message Limit 造成的拒絕錯誤。
使用 items 或 bytes 雖然帶來了記憶體與訊息大小的確定性,但天下沒有白吃的午餐——items 與 bytes 的計算都需要消耗比 requests 更多的 CPU:
requests 是最輕量的(僅做 atomic 整數計數)。bytes 是最昂貴的,因為它必須計算甚至模擬 Protobuf Encoded Size。| Sizer 類型 | 計算標的 | 記憶體預測度 | CPU 額外開銷 | 效能與原理分析 |
|---|---|---|---|---|
requests |
HTTP/gRPC 請求批次數 | 低(請求大則佔記憶體) | 幾乎為 0(極快) | 僅作整數計數,最高效能,但無法防止單一超大 Request 撐爆隊列。 |
items |
Spans / Points / Logs 數 | 中(物件數量固定) | 低(輕微遍歷) | 遍歷 Resource/Scope 結構計數,CPU 開銷極低,兼顧保護與效能。 |
bytes |
Protobuf 序列化後位元組 | 極高(精準防禦) | 最高(最昂貴) | 必須動態計算資料的 Protobuf 編碼體積,在高吞吐流量下會顯著消耗 CPU。 |
切換至 Exporter-Level 批次之後,維運團隊必須立即在 Prometheus / Grafana 中持續監控 otelcol_exporter_queue_size 並與 otelcol_exporter_queue_capacity 進行對比:
$$\text{隊列使用率 (%)} = \frac{\text{otelcol_exporter_queue_size}}{\text{otelcol_exporter_queue_capacity}} \times 100%$$
otelcol_exporter_queue_size:目前暫存在隊列中的資料量(單位自動對齊所選的 sizer)。otelcol_exporter_queue_capacity:設定的隊列容量上限。rate(otelcol_exporter_enqueue_failed_requests[5m]) > 0,代表隊列深度不足或消費者數量過少,必須依上述公式調高 queue_size 或 num_consumers!這是官方最強烈推薦的主流做法。適用於單一 Pipeline 或各 Exporter 有獨立後端配置的場景。
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

processors:
  # ⚠️ batch processor 已在此完全移除!
  memory_limiter:
    check_interval: 1s
    limit_percentage: 75
    spike_limit_percentage: 20

exporters:
  otlp:
    endpoint: tempo.monitoring.svc.cluster.local:4317
    tls:
      insecure: true
    sending_queue:
      enabled: true
      sizer: items
      queue_size: 200000        # 依 items 計算佇列長度
      num_consumers: 16         # 併發發送的 Worker 數量
      block_on_overflow: false  # 若佇列已滿是否阻塞(false 代表立即拋回錯誤觸發背壓)
      batch:
        enabled: true
        sizer: items
        min_size: 8192          # 湊滿 8192 items 發送
        max_size: 16384         # 超過 16384 自動切分
        flush_timeout: 200ms    # 最長等待時間

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter] # 乾淨俐落,無 batch
      exporters: [otlp]
若對資料可靠度有嚴苛要求(不容許 Collector 重啟遺失資料):
extensions:
  file_storage/traces:
    directory: /var/lib/otelcol/buffer
    timeout: 10s

exporters:
  otlp:
    endpoint: tempo.monitoring.svc.cluster.local:4317
    sending_queue:
      enabled: true
      storage: file_storage/traces # 掛載磁碟持久化擴充
      queue_size: 50000            # 持久化於磁碟的請求數
      batch:
        enabled: true
        min_size: 8192
        flush_timeout: 500ms

service:
  extensions: [file_storage/traces]
  pipelines:
    traces:
      receivers: [otlp]
      exporters: [otlp]
queue_batch Processor官方也清楚意識到:並非所有情況都適合在 Exporter 才批次!有兩種特殊情境仍然需要在 Processor 階段進行批次處理:
spanmetrics processor、metricsgeneration 或日誌滾動聚合元件,這些 Processor 在面對「單一大批次」時的效能與計算效率,遠遠高於處理數百個零散小請求。針對這些場景,OTel 推出全新的 queue_batch processor(底層完全複用 queuebatch 引擎):
processors:
  # 使用全新的 queue_batch 替代已棄用的 batch
  queue_batch:
    sizer: requests
    queue_size: 50
    block_on_overflow: true    # 隊列滿時阻塞上游
    wait_for_result: false
    num_consumers: 1           # 保持單一輸出至下游 processor
    batch:
      enabled: true
      sizer: items
      min_size: 8192
      flush_timeout: 200ms

  spanmetrics:                 # 依賴大批次以提升聚合效能
    aggregation_temporality: "AGGREGATION_TEMPORALITY_CUMULATIVE"

exporters:
  otlp/tempo:
    endpoint: tempo:4317
    # 這裡的 sending_queue 就不需要再開 batch: true 了
  otlp/s3:
    endpoint: s3-exporter:4317

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [queue_batch, spanmetrics]
      exporters: [otlp/tempo, otlp/s3]
為了避免在升級至 2027 年的新版本時措手不及,建議團隊自即日起啟動升級準備:
在當前版本的 Collector 中,你可以透過啟動參數開啟 Feature Flag 測試新版預設行為:
otelcol --config=config.yaml --feature-gates=pkg.exporterhelper.queueBatchEnabled
在升級儀表板與告警規則時,請務必切換指標監控路徑:
| 監控面向 | 舊版指標(即將廢除) | 新版指標(即刻生效) | 說明 |
|---|---|---|---|
| 佇列目前堆積量 | otelcol_processor_batch_batch_send_size_count |
otelcol_exporter_queue_size |
目前佇列內存放的單位數 |
| 佇列最大容量 | N/A | otelcol_exporter_queue_capacity |
設定的佇列上限(可用來算使用率 %) |
| 入隊丟包/失敗數 | N/A | otelcol_exporter_enqueue_failed_requests |
核心告警指標!大於 0 表示隊列爆滿丟包 |
| 發送超時觸發計數 | otelcol_processor_batch_timeout_trigger_send |
otelcol_exporter_queue_batch_send (label trigger=timeout) |
批次因時間到期而發送的次數 |
| 容量滿足觸發計數 | otelcol_processor_batch_batch_size_trigger_send |
otelcol_exporter_queue_batch_send (label trigger=size) |
批次湊滿門檻發送的次數 |
| 分區快取使用量 | otelcol_processor_batch_metadata_cardinality |
otelcol_exporter_queue_batch_partition_cache_size |
多租戶 LRU Cache 使用分區數量 |
processors.batch。sending_queue.batch。spanmetrics 或複雜 Fan-out):更換為 processors.queue_batch。queue_size: 1000?如果是,務必改成 sizer: items 並評估合適容量(如 200000),避免隊列瞬間萎縮。batch.sizer 設為 bytes 並配置 max_size: 4194304。processor_batch_* 規則。rate(otelcol_exporter_enqueue_failed_requests[5m]) > 0 告警。batch processor 的淡出,象徵著 OpenTelemetry Collector 從「能用就好」的原型時代,正式跨入「大規模工業級分散式架構」的成熟階段。
過去,觀測管線往往在流量激增時成為系統中最脆弱的一環——記憶體不可控、背壓傳不回去、下游抖動引發本機 OOM。透過將 Queue、Backpressure、Byte Sizing 與 Storage Extension 在 Exporter 層級形成原生閉環,Collector 終於擁有了能夠承載關鍵金融交易與超大規模雲原生負載的可靠底座。
不要等到 2027 年 v0.177.0 被強迫升級破壞配置,今天就動手檢視並重構你的 Collector 管線吧!
302c933)sending_queue 與 batch 的官方設定規範,包含 sizer(requests/items/bytes)、min_size、max_size、block_on_overflow、wait_for_result 以及分區(Partitioning)參數。file_storage)、Context 傳遞限制、重試機制與消費端模型架構圖。queue_batch.go:佇列與批次器整合入口、生命週期啟動與關閉、約束非分區情況下隊列消費者為 1。batcher.go:Batcher 介面定義與分發工廠(建立 shardedBatcher 或 multiBatcher)。partition_batcher.go:單一分區狀態機、consumeInternal、flush、workerPool 以及 multiDone / refCountDone 呼叫追蹤。multi_batcher.go:基於 HashiCorp SimpleLRU 的多租戶快取控制,結合 idle_timeout 與驅逐自動 Flush。metadata_partitioner.go:Varint 長度前綴二進位編碼分區器。traces_batch.go、logs_batch.go、metrics_batch.go:MergeSplit 演算法與三種遙測訊號的位元組 / 項目數計算。singleShardBatcher、單一 startLoop goroutine 以及 channel 阻塞與錯誤吞噬行為。
 雷N

 iThome鐵人賽
 看影片追技術