
終於結束了前面的Regression跟Classification,這章開始,要介紹Cluster跟相關的方法。
雖然Cluster跟Classification很像,但跟前面的方法不同之處在於,Classification的前提是我們已經先有一套分類了,然後要把資料透過統計的方式做歸類。Cluster 的前提是,我們不清楚資料中是否有一組數據剛好都很接近或很相似,但要透過統計的方式去找到這樣的資料模式。
這又稱為非監督式學習。先複習監督式,監督式的經典範例是給model範例蘋果,並告訴他這個分類是蘋果,接著監督式會找到跟這個蘋果很像的數據,並將它們都分類為蘋果。
但非監督式學習不需要告訴模型分類,模型會根據相似性做分組。
這一章號稱會教兩種Clustering方式、一個是K-Means 另一個則是Hierachical clustering,就從K-means開始吧~
K-means
1.決定你有幾個組別,先假設分兩組
2.產生隨機的2數據點(AB),不能跟現有資料重複,當作分群中心A、B
3.計算分群中心A、B跟所有數據的差距,靠近A的為群A、靠近B的為群B
4.在群A跟群B中計算平均點,然後產生了新的中心,我們稱A'、B'
5.重複做3~4的步驟,直到所有數據對應的分類不再有變化
而組別的數量有什麼好方式可以決定呢? Elbow 法是老師推薦的方式,這個是比較適合完全都不知道有幾個分類的方法。有的時候可以根據領域知識,決定分類的組別數。
Elbow法其實是把所有組別數都算過、使用WCSS公式評估,然後找一個相對適合的。
WCSS公式如下:
把不同組別數的K-means結果算出每個組別內數據到分群中心的平均距離,然後做加總。
(用一下老師的圖示意)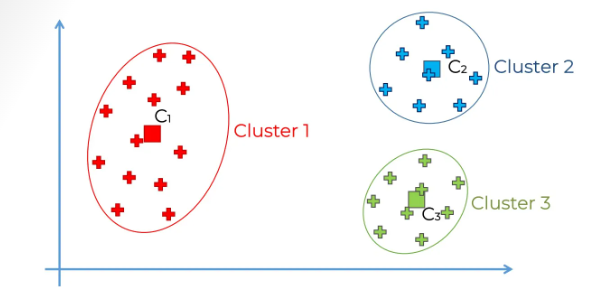
接著、把每個組別數所產生的WCSS距離放到圖表上做觀察,我們可以看到分成X組時,WCSS值急速下降。就是那組了。折起來的地方很像手肘、所以就稱為elbow法
(私以為不太可靠、有點隨機跟人為的感覺、不同人看很可能會有不同的解讀)
K-means 還有一個比較大的問題:一開始的分群中心(Centroid)是隨機產生的。代表即使使用完全相同的資料,只要一開始隨機選到的中心點不同,最後得到的分群結果就可能完全不同。例如我們想把資料分成 3 群。假設資料本身大致分布在左、中、右三個區域,如果第一次隨機產生的兩個中心點剛好都落在左邊,那麼 K-means 在後續分群時,就可能得到一個不太理想的結果。
所以問題就變成:「能不能不要完全隨機,而是讓新的中心點盡量選在離現有中心較遠的位置?」
這就是 K-means++ 的主要想法。它的做法可以想成:第一個中心點還是隨機選,但後面的中心點會根據「距離目前中心點有多遠」來決定被選中的機率。距離越遠的資料點,被選成新中心點的機率越高。
假設我們要分成 3 群,可以分成以下幾個步驟。
1.隨機選擇第一個中心點,先從所有資料中隨機選出一個資料點,作為第一個分群中心,這一步仍然保留隨機性。
2.計算所有數據到這個隨機點的距離,接著、將距離做加權,加權後距離原有的點最遠的數據點當成第二個分群中心。
3.計算所有數據到1,2中心點的距離,對距離做加權後,找出加權距離最大的點,此為第三個分群中心。
接著就可以開始做K-means了,這個方法可以避免一開始的隨機點灑得太近或灑得太遠,可以盡量保持組與組之間差異比較大。
K-means綜合來說,是個想盡辦法讓組間差異大、組內差異小的一個方法。
實作
先去sklearn+ kmeans當關鍵字找到相關的library,然後匯入。
用fit方法並帶入資料後,小精靈就會依據定義的參數將資料做分類,但我們並不知道哪個組別數才是合理的,所以這時候要用迴圈的方式算每個K cluster的WCSS值,WCSS值在sklearn裡是記在inertia這個屬性裡頭
from sklearn.cluster import KMeans
kmeans = KMeans(n_clusters = i, init = 'k-means++', random_state = 42) -- n_clusters是i,可配合迴圈做
kmeans.fit(X)
wcss.append(kmeans.inertia_) --將每個cluster的WCSS值記錄在陣列裡、後續方便找elbow的位置
找到elbow的位置後,用來做預測
kmeans = KMeans(n_clusters = 3, init = 'k-means++', random_state = 42)
y_kmeans = kmeans.fit_predict(X)
其實算到這邊就結束了、後面也是視覺化的部分,我建議要跟著講師實作一次(plot的邏輯個人認為不太直覺)~視覺化不是必要、但是Kmeans用視覺化看效果真的很好,可以明確看出分群的結果合不合理

 duckravel48

 iThome鐵人賽
 看影片追技術