
(jason3e7 的疑問)LLM 以前就有,但好像去年底突然大爆發,為什麼?
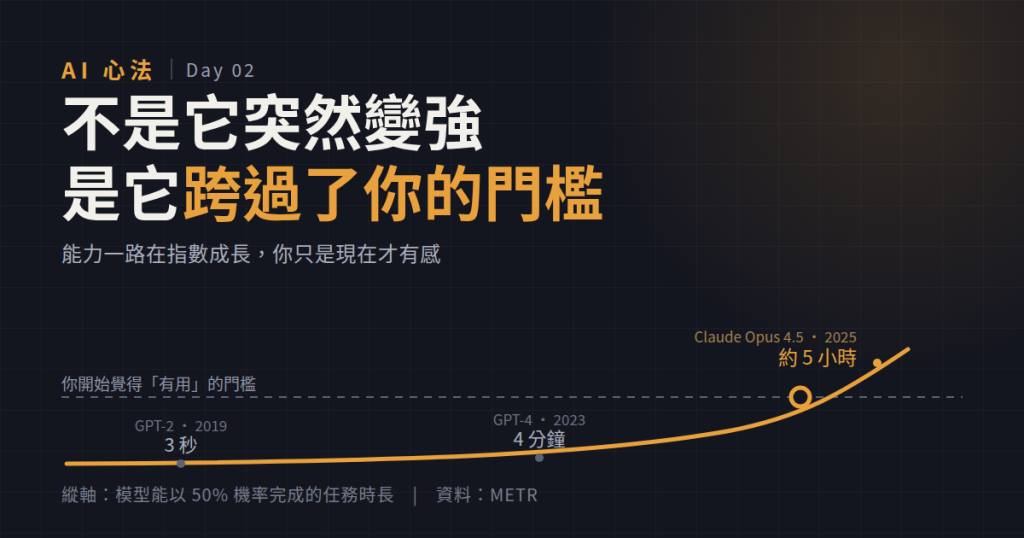
答案有點反直覺:能力沒有突然爆發,它一路都在指數成長。爆發的是「它跨過了對你有用的那條線」。
研究機構 METR 把這件事量化成一個指標:模型能以 50% 機率完成的任務時長。
| 模型(發布年) | 任務時長(50% 成功率) |
|---|---|
| GPT-2(2019) | 3 秒 |
| GPT-4(2023) | 4 分鐘 |
| Claude 3.7 Sonnet(2025-02) | 1 小時 |
| Claude Opus 4.5(2025-11) | 約 5 小時 |
這個指標有三個地方要先講清楚,不然很容易誤讀。
一、那是臨界點,不是保證。 50% 不是說「所有五小時的任務它都有一半機會」,而是成功率剛好掉到一半的那個長度。曲線是連續的:人要做一小時的事,它成功率遠高於一半;人要做十小時的事,就明顯低於一半了。
二、「人」指的是專家。 這個時長是拿領域專家的實際耗時當基準 - 「五小時」是一個本來就會做這件事的人要花的時間,不是隨便找個人來試。
三、「工作」有範圍。 題庫涵蓋的是機器學習研究工程、軟體工程與軟體維運這三類任務,不是所有職業的工作。
這條線全期平均每 6.2 個月翻一倍;而 2023 年之後更快,每 4.2 個月就翻一倍。
更新的資料還顯示一件事:2026 年的模型已經衝到 12 小時以上,但信賴區間從 5 小時橫跨到 60 小時,METR 自己也講明,超過 16 小時就超出這套題庫能測的範圍了。量尺已經跟不上被量的東西。
指數曲線的特性就是這樣 - 在跨過你的門檻之前,看起來什麼都沒發生:
前三格你都不會覺得「爆發」。跨到第四格的那一刻,你的體感就是世界一夕之間變了。曲線沒有變,是你的門檻被跨過了。
那條指數曲線是三件事撐起來的,而且是先後點火,不是同時。
第二點才是真正的轉折。它把「這條路走不走得通」變成「你想花多少錢」。一件事只要能用錢換,產業就會全力押注。
GPT-3 在 2020 年就存在了,但很難用 - 你得用很技巧的方式去「引導」它接話。2022 年的 InstructGPT(Ouyang et al.)用 RLHF(從人類回饋中做強化學習)把模型調成「照指令做事」。
這一步沒有讓模型更聰明,是讓它變得可用。同年 11 月 ChatGPT 之所以炸開,是產品時刻,不是模型突破 - 底層模型早就在那裡了。
這是第一次「感覺上的爆發 ≠ 技術上的突破」。同樣的錯覺,後面還會再發生一次。
2024 年 OpenAI 的 o1 系列開了第二根軸:不是把模型訓練得更大,而是在回答時多給它一點算力去想。
這根軸特別的地方在於,它可以用時間換聰明 - 一個小模型讓它想 10 秒,可以贏過一個大上十幾倍、但秒答的模型。從 o1 到它的後繼者 o3,投在強化學習上的算力增加了超過 10 倍。
到這裡,模型已經很強了。但你去年感覺到的那次爆發,還缺最後一塊。
前面三個引擎讓模型「會想」;2024 年底開始的這一波,讓它「能動」。
把兩件事乘起來,就是答案:
(它能接手人要做好幾個小時的工作)×(它能接上你真實的檔案與工具)= 第一次可以「交辦一件真事」。
所以「去年底突然大爆發」的實際內容是:不是模型在那個月變聰明了,而是模型的能力曲線,剛好在那時候跟工具生態的成熟度撞在一起。
順帶一提,同一段時間也出現了「尺不夠長」的訊號:SWE-bench Verified 這個寫程式評測 2024 年 8 月才推出,到 2026 年 OpenAI 已公開表示它不再足以衡量前沿的寫程式能力。當你的量尺跟不上,你就會覺得到處都在爆發。
三條可以直接拿去用的心法:
一、「現在不行」的保存期限很短。
如果曲線 4 到 6 個月翻一倍,那你半年前試過、覺得「AI 做不到」的事,現在很可能做得到。把失敗過的嘗試記下來,每季重試一次,比每天追新聞有用得多。
二、你能施力的地方不是模型。
爆發來自「模型能力 × 工具接得好不好 × 任務切得夠不夠準」這個乘積。模型你改不了,但另外兩項完全在你手上。
三、你不一定要待在能力邊界上。
前面說過,50% 是成功率剛好掉到一半的那個長度 - 任務切得越小,成功率就越回得去。與其把一件五小時的事整包丟給它,不如切成五件一小時的事。真的得在邊界上做,就先想好怎麼驗。
最後留一個提醒:上面講的每一個「突然」,拆開來看都不突然。
下次聽到「AI 又爆發了」,先問一句:是它的能力變了,還是我的門檻被跨過了?


 iThome鐵人賽
 看影片追技術