
不囉嗦直接來,Hierarchical Cluster是另外一個cluster的方法
做法
我看完這串後有點??? 做到最後就是把所有的點合併成一個點那...還有什麼意思呢?
有的、跟Kmeans一樣,要搭配其他方式找群。
HC用的是dendrogram,接著決定閾值,最後就可以畫出群聚了。
以下圖為範例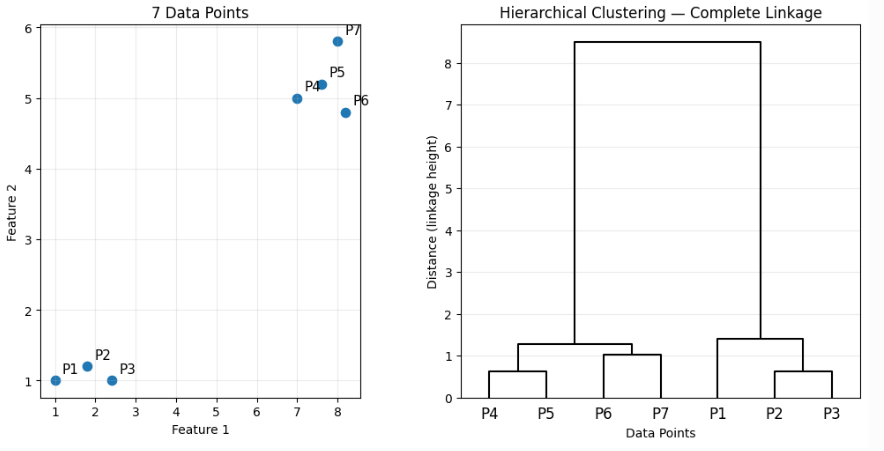
Hierarchical Clustering 一開始把每一個資料點都當成一個 cluster。
一開始有七個點,等同有七個群聚,P1~P7,接著計算彼此之間的距離,找距離比較近的 cluster 合併。
因為 P2 和 P3 距離最近,所以合併成:{P2,P3}
接著發現 P4 + P5 是距離最近的,形成 {P4,P5}
再來,P6 + P7,{P6,P7}
這時候:{P1} {P2,P3} {P4,P5} {P6,P7}
接下來比較「cluster 和 cluster」之間的距離。
例如 {P4,P5} 和 {P6,P7} 也很接近,所以:
{P4,P5} + {P6,P7} 變成:{P4,P5,P6,P7}
如此不斷重複直到最後變成一個大的cluster
接著就是決定閾值,以下呈現閾值為1跟為6的差別,閾值為6時,只有兩個Cluster,為1時,就可以切跟多cluster出來了。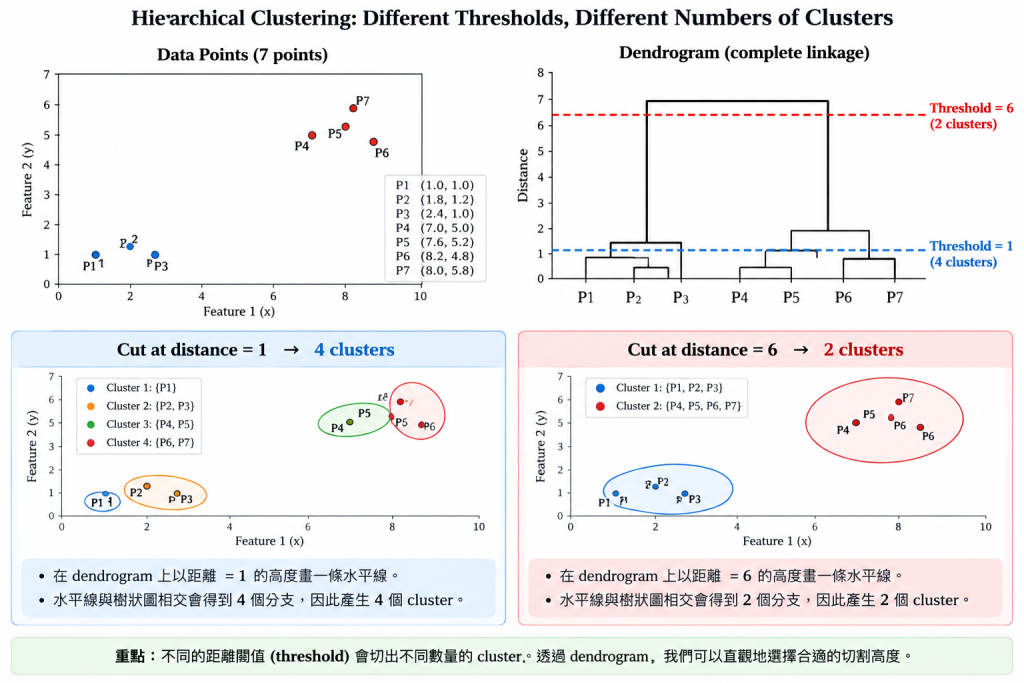
不過怎麼決定切出來的結果是最好的? 一般是建議找距離最長的那一段(組間距離差異最大那段)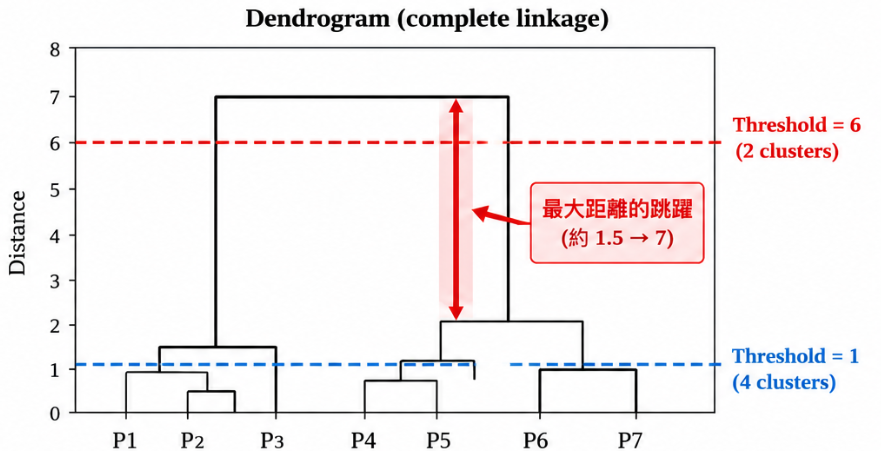
實做我本來想跳過XD 但發現HC 第一次用了跟其他章節不同的函式庫,只好勉強做一下了QQ
直接import scipy.cluster.hierarchy,
https://docs.scipy.org/doc/scipy/reference/cluster.hierarchy.html
要用的是dendrogram這個方法,但要跟linkage一起搭配使用
import scipy.cluster.hierarchy
Z = hierarchy.linkage(X, method = 'ward') method --method決定合併的方式,舉例來說,ward是讓群內 variance 增加最少,single就單純合併兩群中最近的兩點,centroid是兩個群的中心來算距離並合併, etc
dn = hierarchy.dendrogram(Z)
plt.show() --超棒的不用特別寫視覺化就是棒,官網有提供範例做更清楚的視覺化
用dendrogram決定好'群'跟閾值後,
就可以再跳回sklearn的懷抱了
from sklearn.cluster import AgglomerativeClustering
hc = AgglomerativeClustering(n_clusters = 3, linkage = 'ward')
y_hc = hc.fit_predict(X) --最後的y_hc會是分群的結果這樣
不過群聚沒畫出來真的很難感受'分群',所以可以參照講師的視覺畫方式改一改再呈現囉~
最後講一下兩種cluster的優缺點,Kmeans的缺點很顯而易見,就是決定K很不容易XD 而HC 分群方法相對公正,但是你可以想像當資料超級多的時候,分群會變得很吃力,所以不太適合資料量太大的情境
--
目前上完第四章已Day18,課程是第27節,終於上超過一半了(共50節)QAQ 開始絕望覺得很難在育嬰假結束前上完
(尤其我三分鐘熱度不停想開新副本)

 duckravel48

 iThome鐵人賽
 看影片追技術