
提到持續整合,大家會想到什麼?
我第一次聽到持續整合(Continuous Integration),已經是十多年前的事了。印象中,那幾年在社群裡聽到持續整合時,經常會連同持續交付(Continuous Delivery,簡稱 CD)一同提起,也就是 CI/CD。
後來,我第一次參加鐵人賽,正是以持續整合為主題:CI 從入門到入坑,同時也獲得了優選。
在研究持續整合的過程中,我發現平常聽到的 CI/CD,談的往往是自動化測試與部署。這些做法對開發流程確實有幫助,但持續整合還關注另一件事:團隊是否頻繁整合彼此的程式,並確認整合後的結果。
當年知道持續整合的同時,正好也在學習寫單元測試。手上的功能主要需要確認邏輯是否正確,剛好適合拿來練習。寫完所有測試案例看到了一個 Passed 的綠勾勾,心情很開心。
但隔沒多久就不開心了,因為另一個同事在做相關功能的時候改壞了。他沒有執行單元測試,也不知道如何執行。於是壞掉的測試就這樣被提交與上線,留下不知道怎麼修正單元測試的我。
如果當時同事知道如何執行測試,並在整合後確認結果,就能及早發現失敗並一起處理。團隊也可以把建置與測試寫成腳本,交由持續整合服務(CI Server)在版本更新時自動執行,減少漏做驗證的情況,並記錄對應版本的結果。失敗時主動通知相關成員,讓團隊能及早處理問題,也提醒其他成員暫緩使用尚未通過驗證的版本。
以下繼續沿用 Kevin 共用模組的假想情境,說明團隊如何安排自動化建置、確認驗證結果,以及處理失敗。
Kevin 已整理出 Elvina 需要的模組調整,可以分開驗證並整合,不必等待其他尚未完成的程式,Phoebe 則協助審查。
在談到建置腳本時曾提過,建置過程可以很複雜,但啟動建置的方法應該簡單。把步驟寫進腳本,就能減少手動操作時漏做檢查、打錯指令或弄錯順序的問題。另一個好處是,準備好所需環境後,就能在不同主機上執行同一份腳本,不必另外整理一套驗證步驟。
開發者先補上測試,確認新增的功能符合需求,也沒有破壞原本的功能。接著把執行測試與其他必要檢查的步驟寫進建置腳本。環境準備好後,只要執行一個指令,就能啟動這些步驟,確認程式是否通過驗證。
接著 Kevin 將測試、腳本與必要設定隨程式一起提交,並寫下如何準備環境,包括需要哪些工具與套件、使用什麼版本,以及如何取得。Phoebe 取得程式、按照說明準備好環境後,就能用相同的指令啟動建置,執行與 Kevin 相同的驗證步驟。
團隊也可以按照相同的說明準備一個獨立的環境,用來執行建置腳本。以 GitHub 為例,可以設定 Webhook,在有人推送程式時發送通知。接收通知的程式再依設定取得要驗證的版本,在準備好的環境中執行建置,並記錄結果。這種協助團隊自動執行建置、記錄與回報結果的服務,就是開頭提到的持續整合服務。
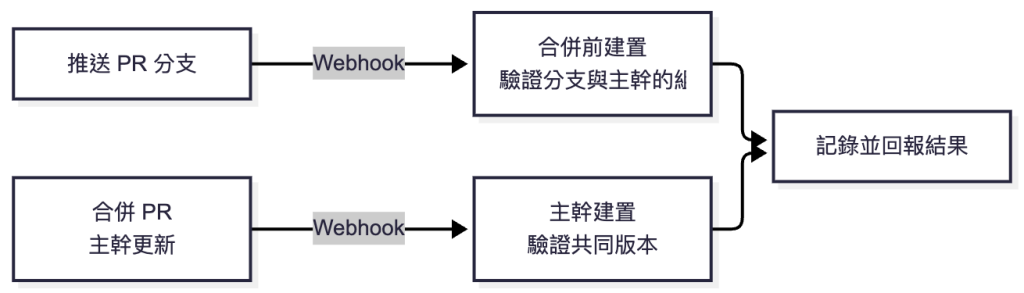
建置要驗證哪個分支,也需要設定。以這個 PR 流程為例,團隊會分別設定 PR 分支與主幹的建置:前者用來檢查準備合併的程式,後者用來確認合併後的共同版本。
Kevin 推送 PR 所在分支的程式後,就會觸發建置,他與 Phoebe 便能在審查時查看驗證結果。如果 Kevin 依照審查意見修改程式並再次推送,持續整合服務也會重新執行建置,確認修改後的結果。
除了設定何時執行,還要確認建置時是否把主幹的程式一起取來驗證。只測 Kevin 分支上的程式,還不能確認它與主幹上的最新程式是否能一起運作。如果檢查通過後,其他人又將程式合併到主幹,Kevin 就要先把這些更新合併到自己的分支,再重新驗證,避免沿用主幹更新前的結果。
完成必要審查與驗證、將 PR 合併到主幹後,持續整合服務再依設定執行主幹建置,驗證合併後、大家共同使用的版本。
下圖整理兩種建置的觸發時機,假設團隊已設定好 Webhook、建置環境與驗證步驟。
Kevin 的模組雖然已經寫好,仍要等合併前的必要檢查通過,才能合併到主幹供 Elvina 取得。建置花的時間越長,從程式寫好到其他人可以使用之間的等待就越長,開發者之間的距離也越大。
建置結果越晚回報,開發者也越晚知道是否需要修正。如果是主幹的建置失敗,而等待結果期間又有其他提交進入,就可能還要確認這些提交是否受到影響。
團隊可以先查看各次建置的紀錄,區分排隊與執行建置各花了多少時間。若一直等不到可用的執行環境,就要調整執行資源或排程;若時間集中在某個建置步驟,就要檢查該步驟的耗時原因。互不依賴的檢查可以考慮平行執行,但要先確認是否共用測試資料或其他資源,避免互相干擾。
團隊也可以把建置分成幾個階段,先執行較快的檢查,通過後再執行較花時間的驗證。前面的階段失敗時,開發者就能開始處理,不必等到全部流程結束才知道有問題。
每個階段都要清楚標示驗證範圍。單一模組的測試通過,還不能代表它和其他程式一起運作的結果也已確認。如果後續階段是這次整合的必要驗證,就要等它完成,才能判定整體是否通過。
團隊會從主幹取得程式繼續開發,因此持續整合服務需要保留每次主幹建置的紀錄,包括使用哪個提交、執行哪些檢查,以及檢查結果。開發者合併 PR 後,就能查到這次主幹更新的建置紀錄,確認合併後的版本是否通過驗證,避免沿用合併前或其他版本的成功結果。
建置紀錄也要顯示各項檢查的狀態。如果必要檢查仍在排隊或執行,就要等結果出來後再判斷;檢查被取消或略過,也不能當作已經通過。開發者確認必要檢查全部通過後,再把這次提交與建置結果分享給需要這些程式的成員。其他成員取得程式後,仍要驗證它與自己正在開發的程式是否能一起運作。
如果主幹建置失敗,持續整合服務就要通知提交者查明原因並修復。這樣能協助團隊及早發現並處理合併前漏掉的問題,形成一道安全網。
合併前的必要檢查失敗時,先處理問題,重新驗證通過後再合併。若程式進入主幹後才發現失敗,就需要優先處理,讓共同版本恢復到通過必要驗證的狀態。
提交者收到主幹建置失敗的通知後,先確認受影響的版本與失敗步驟,開始修復並告知團隊。處理期間暫停合併無關提交,避免增加需要判斷的變更。修復建置要列為優先事項,但不需要所有人都停下來一起除錯。
先依建置紀錄確認問題出在程式還是建置環境,再由相關成員處理。原因清楚且能立即修正時,就直接修復;若是程式變更造成失敗,短時間內又無法確認修法,可以先還原該變更,再繼續查明原因。
在 Git 裡,可以用 git revert 新增提交,反向套用先前的變更並保留歷史。它處理的是版本庫裡的內容,不會自行把正式環境換回先前的成品。
還原前,Kevin 要確認後續提交是否依賴被撤銷的內容,必要時一起調整,避免還原造成另一個失敗。Elvina 若已在自己的分支使用新模組,也需要知道主幹暫時不再提供哪些行為,才能調整開發安排。
同一份程式有時通過、有時失敗,則需要檢查測試資料、執行順序、環境與程式本身的不穩定行為。重跑到成功並不能解釋前一次失敗。若暫時停用某項檢查,要記錄缺少的驗證、負責處理的人與替代方式;沒有足夠依據時,相關的整合或發布仍須等待。
修復或還原後,Kevin 要重新執行必要建置。確認主幹通過驗證,再分享對應提交與結果,通知團隊恢復整合。如果採用還原,Elvina 需要等模組重新修正、整合並通過驗證後,才能從主幹取得所需的行為。
處理過程也要補足原本缺少的驗證。直接修正程式時,若現有測試無法涵蓋這次問題,就補上能重現問題的測試,一起確認修正結果;若先還原變更,則在重新整合前完成這些確認。環境問題也應補齊必要設定與取得依賴的步驟,減少後續建置依靠人工處理的情況。
持續整合服務對於程式品質有一定程度的幫助,但我也遇過反模式:開發者不在本機執行建置腳本,沒有先驗證程式,就直接發 PR,等持續整合服務回報結果。
這樣一來,原本在本機就能發現的問題,也要等程式推送、建置排隊與執行後才會知道。發現失敗後,開發者還要回到本機修正,再推送程式、等待下一次結果。如果每次都用這種方式確認程式是否能通過基本檢查,就會反覆增加等待回饋的時間。
開發者應該先在本機執行建置腳本,處理發現的問題,確認通過後再推送程式,並查看持續整合服務的驗證結果。
把建置步驟寫成腳本後,還需要讓團隊知道如何執行、何時執行,以及失敗後如何處理。持續整合服務可以協助執行建置與回報結果,開發者則需要持續整合程式、確認對應版本的驗證狀態,並優先處理主幹上的問題。
建置通過能提供繼續開發與判斷發布的依據,但只涵蓋實際執行的驗證;是否具備發布條件,仍需確認其他交付準備。


 iThome鐵人賽
 看影片追技術