
前幾集我一路追 Spark 的 Job、Stage、task、shuffle 和輸出檔案。當資料寫完後,我平常很自然地會在下一個 job 裡寫下 spark.table("analytics.orders");但這個 table name 到底怎麼變成一批可以讀取的檔案,我其實說不清楚。
查詢一張表時,Spark 需要找到三件事:誰來執行查詢、這個名稱對應哪份 metadata,以及真正的資料放在哪裡。這一段開始會沿著這條路徑往下看。這一集我們先畫地圖,把整個全局概念先建立起來,再用一個最小的 local Hive 實驗,把名稱、metadata 和檔案連起來。
spark.table() 查詢,從 API 到 data files 經過哪些角色。我先用 Hive 生態系常見的路徑建立直覺。它可以分成三個工作區域:提交與執行、metadata control plane、實體資料。
【提交與執行】
Python DataFrame API / SQL client / BI tool
        ↓
連線或呼叫方式:Py4J、JDBC、ODBC、HTTP、Thrift ...
        ↓
Query engine:Spark SQL、Hive、Presto、Trino

【Metadata control plane】
Catalog(角色):解析 catalog.namespace.table
        ↓
Hive Metastore(系統實作):提供並保存 table metadata
        ↓
Metadata backend:Derby、MySQL、PostgreSQL ...

【實體資料】
Storage:HDFS、S3、GCS、本機檔案系統 ...
        ├─ warehouse:managed table 常用的預設根路徑
        └─ external location:自行指定的資料路徑
        ↓
Data files:Parquet、ORC、CSV、JSON ...
這張圖的箭頭代表「下一步需要取得的資訊」,不代表每個元件都一定是獨立服務。 local mode 的 PySpark 直接經由 Py4J 呼叫同一個 application 裡的 Spark JVM;通常是在 BI tool 連遠端 Trino 或 HiveServer2 時,JDBC、ODBC 或 HTTP 才常會成為 client 與 query engine 的連線方式。
| 名詞 | 這條路徑中的責任 |
|---|---|
| query engine | 規劃並執行 SQL 或 DataFrame query,例如 Spark SQL。 |
| catalog | 解析 catalog.namespace.table 這類 table identifier,並管理 database/namespace 與 table。 |
| metastore | 保存、提供 table metadata 的服務或機制。Hive Metastore 常同時實作 catalog 與 metastore 的責任。 |
| metadata backend | Hive Metastore 保存 metadata 時使用的關聯式資料庫,例如 Derby、MySQL、PostgreSQL。 |
| warehouse | 受管理 table 預設使用的 storage 根路徑 convention。 |
| data files | 真正保存 rows 的檔案,例如 Parquet、ORC、CSV、JSON。 |
我用餐廳做一個簡單比喻:
analytics.orders 對應哪一份 table metadata。為了把上面的角色都留在筆電上觀察,實驗選擇了這組最小組合:
Python DataFrame API
  ↓ Py4J
Spark SQL(local[2])
  ↓ Hive-compatible catalog / metastore client
Embedded Derby
  ↓ metadata 中記錄的 Location
暫時本機 workspace
  ├─ warehouse/analytics.db/managed_events/
  └─ external-events/
      ↓
      Parquet data files
Derby 是以 Java 實作、可嵌入 JVM 的輕量關聯式資料庫。它很適合本機測試:內容看得到、每次實驗可丟棄,也能從乾淨狀態重跑;多個 Spark application 共用時容易受到並行與 lock 限制,正式環境通常會選用 Hive Metastore service 搭配 MySQL 或 PostgreSQL 等後端。
實驗先建立一個每次執行都不同的暫時 workspace,再把 Hive metastore 的 JDBC connection URL 指向裡面的 Derby database:
from pathlib import Path
from tempfile import mkdtemp

from pyspark.sql import SparkSession

workspace = Path(mkdtemp(prefix="ep10-catalog-hive-tables-"))
warehouse_path = workspace / "warehouse"
metastore_path = workspace / "metastore_db"
external_events_path = workspace / "external-events"

spark = (
    SparkSession.builder.appName("ep10-catalog-hive-tables")
    .master("local[2]")
    .config("spark.sql.warehouse.dir", str(warehouse_path))
    .config(
        "spark.hadoop.javax.jdo.option.ConnectionURL",
        f"jdbc:derby:{metastore_path};create=true",
    )
    .enableHiveSupport()
    .getOrCreate()
)
enableHiveSupport() 讓這個 SparkSession 使用 Hive-compatible catalog 支援。javax.jdo.option.ConnectionURL 是 Hive metastore 內部用來指定 metadata database 的設定;加上 spark.hadoop. 前綴後,Spark 會把它交給 Hive 使用。jdbc:derby:...;create=true 表示若這次實驗的 Derby database 還不存在,就在 metastore_path 建立它。
這裡出現 JDBC 的位置是 Hive metastore client 與 Derby 之間;Python DataFrame API 仍然經由 Py4J 呼叫 Spark JVM。
實驗先做出一份很小的 events DataFrame:
from pyspark.sql import functions as F

C = F.col

events = (
    spark.range(1, 13, numPartitions=2)
    .withColumn("event_date", F.lit("2026-10-05").cast("date"))
    .withColumn(
        "region",
        F.when(C("id") % 3 == 0, "TW")
        .when(C("id") % 3 == 1, "JP")
        .otherwise("US"),
    )
    .withColumn("event_type", F.when(C("id") % 2 == 0, "view").otherwise("click"))
    .select(C("id").alias("event_id"), "event_date", "region", "event_type")
)
它有 schema 和 rows,卻還沒有 analytics.events 這類可以跨 query 使用的名稱。接著建立 database,並把相同內容各自寫成 managed table 和 external table:
spark.sql("CREATE DATABASE IF NOT EXISTS analytics")

events.write.mode("overwrite").saveAsTable("analytics.managed_events")

events.write.mode("overwrite").parquet(str(external_events_path))
spark.sql(
    "CREATE TABLE analytics.external_events "
    "USING PARQUET "
    f"LOCATION '{external_events_path}'"
)
SHOW DATABASES 與 SHOW TABLES 顯示的是 catalog 裡註冊的名稱:
+---------+
|namespace|
+---------+
|analytics|
|default  |
+---------+

+---------+---------------+-----------+
|namespace|tableName      |isTemporary|
+---------+---------------+-----------+
|analytics|external_events|false      |
|analytics|managed_events |false      |
+---------+---------------+-----------+
DESCRIBE EXTENDED 可以直接看到 Hive-compatible catalog 保存的幾個關鍵欄位:
+--------+-------------------------------------------------------------+
|col_name|data_type                                                    |
+--------+-------------------------------------------------------------+
|Type    |MANAGED                                                      |
|Provider|parquet                                                      |
|Location|file:/.../warehouse/analytics.db/managed_events             |
+--------+-------------------------------------------------------------+

+--------+-------------------------------------------------------------+
|col_name|data_type                                                    |
+--------+-------------------------------------------------------------+
|Type    |EXTERNAL                                                     |
|Provider|PARQUET                                                      |
|Location|file:/.../external-events                                    |
+--------+-------------------------------------------------------------+
兩張表都能用同樣的 table name 介面讀取,差異落在 location 的管理責任。
| table type | 這次實驗的 location | 資料生命週期的直覺 |
|---|---|---|
| managed | warehouse/analytics.db/managed_events/ |
Spark 依 warehouse convention 建立與管理 table location。 |
| external | external-events/ |
建表時登記既有或自行指定的資料位置。 |
這裡看到的 Provider: parquet 指向 data file format;Hive-compatible catalog 負責保存 table metadata。兩者分工不同,後面會分別深入。
spark.table() 最後仍會掃描檔案用 table name 讀取資料時,Spark 先從 metadata 取得 location 與 provider,再建立掃描計畫:
spark.table("analytics.managed_events").select("region").explain(mode="simple")
Physical Plan 裡可以找到:
== Physical Plan ==
*(1) ColumnarToRow
+- FileScan parquet spark_catalog.analytics.managed_events[region#...]
   Batched: true, DataFilters: [], Format: Parquet,
   Location: InMemoryFileIndex(1 paths)[file:/.../warehouse/...],
   ReadSchema: struct<region:string>
實驗前一步的 .show() action 在 Spark UI 也留下相同線索;紅框中的 scan 名稱保留了 catalog、namespace、table name 與檔案格式:
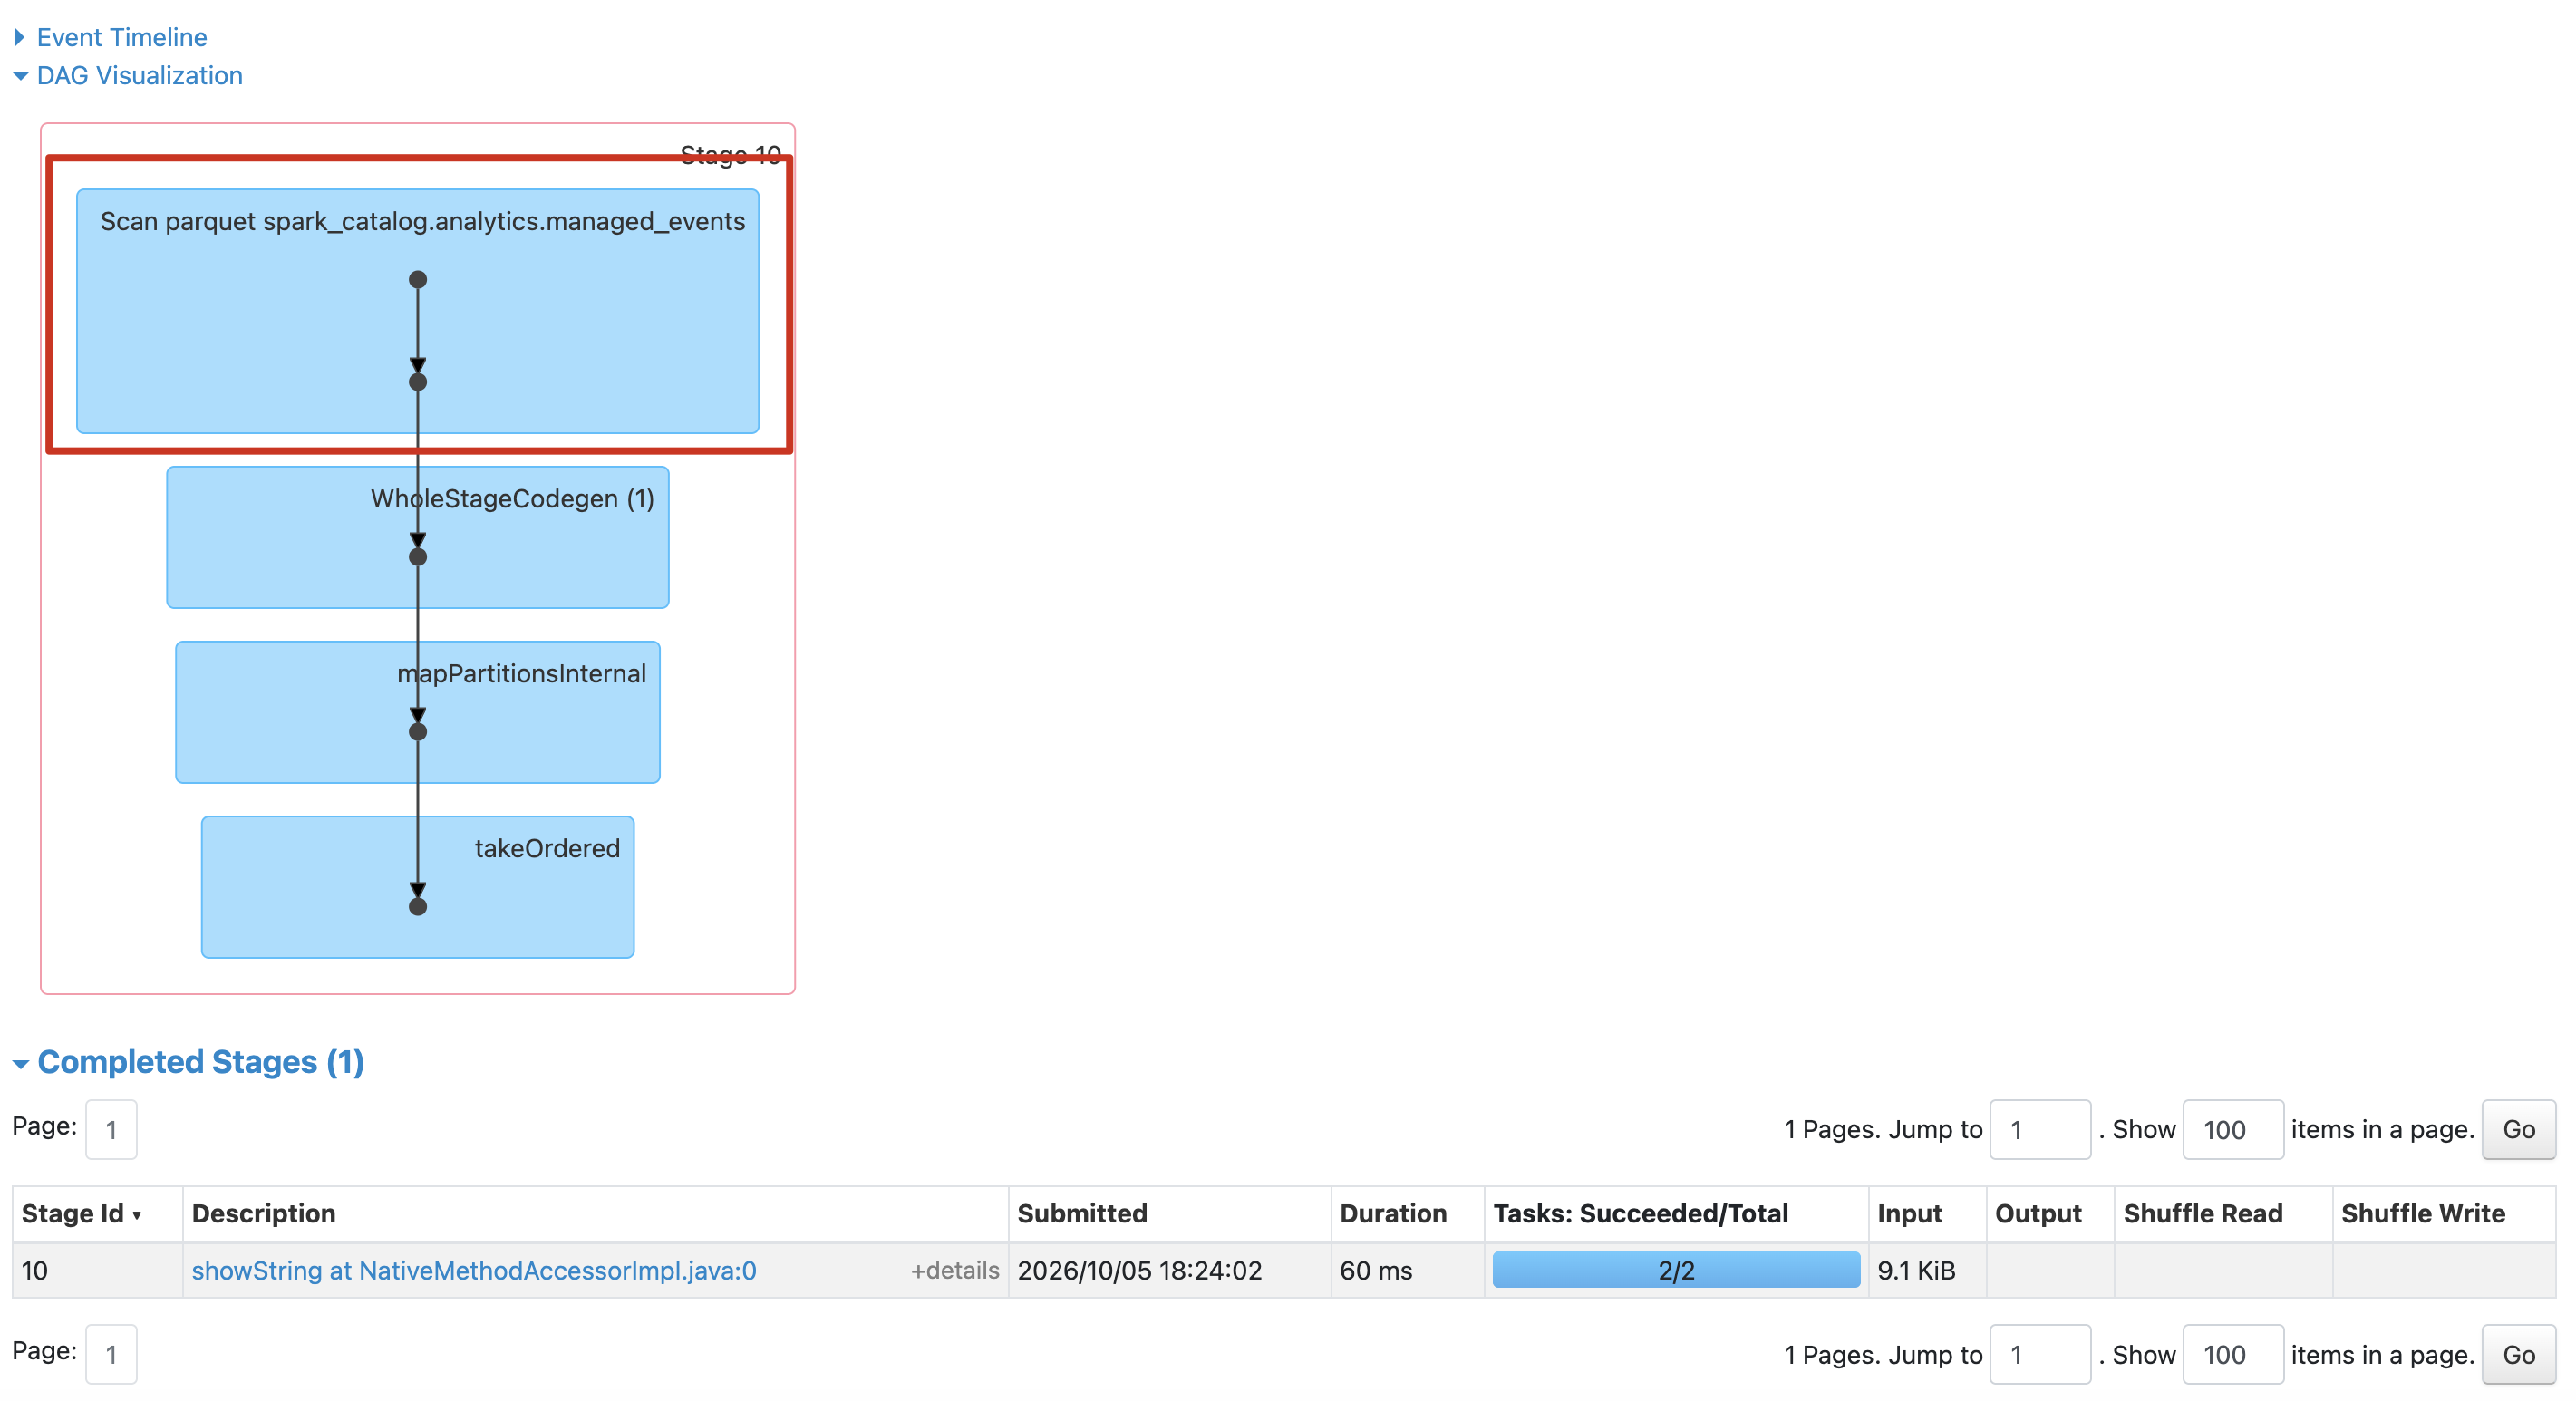
這段輸出把路徑接起來了:spark_catalog.analytics.managed_events 這個名稱,透過 catalog metadata 找到 warehouse 裡的 location,最後由 FileScan parquet 讀取實體檔案。
實驗最後列出兩個 location 底下的內容;以下省略 macOS 產生的 .crc 檔與每次不同的 UUID:
warehouse/analytics.db/managed_events/
├── part-00000-....snappy.parquet
├── part-00001-....snappy.parquet
└── _SUCCESS

external-events/
├── part-00000-....snappy.parquet
├── part-00001-....snappy.parquet
└── _SUCCESS
我原本容易把 Hive、warehouse、Parquet 都當成「存資料的地方」。跑完這個實驗後,我會先把它們放回各自的角色:Spark SQL 負責執行查詢;Hive-compatible catalog 與 metastore 保存 table metadata;warehouse 或 external location 保存實體資料;Parquet 是實際 data files 的格式。
這份地圖也幫我在看設定時先問對問題:我現在是在設定 Python client 與 engine 的連線、metastore 的 metadata backend、table 的 location,還是 data files 的格式?它們會一起出現在一個 Spark job 裡,調整的責任與影響範圍卻不同。
下一篇會停在 Hive 生態系內,仔細看 Hive Metastore 到底保存了什麼,以及 managed table、external table、warehouse 和 metadata backend 在真實資料工作中的責任邊界。
🚀 GitHub:
Ep10|一張表從名字到檔案:Spark 資料儲存全貌
🚀 spark-learning-lab 系列文章與實作:
https://github.com/jeffery5bai/spark-learning-lab
Apache Spark 3.4.4 — Hive Tables:
https://archive.apache.org/dist/spark/docs/3.4.4/sql-data-sources-hive-tables.html
Apache Spark 3.4.4 — Catalog API:
https://archive.apache.org/dist/spark/docs/3.4.4/api/python/reference/pyspark.sql/catalog.html

 jeffery5bai

 iThome鐵人賽
 看影片追技術