
建立專案的流程搬進 Discord。使用者可以先說明需求,看過第一輪草案後,再決定直接定稿或提出修改。
實際使用後,我發現流程的頭尾還有兩個地方不夠自然。入口太依賴固定句型;到了 Review 階段,畫面只有通過與否,也很難看出方案到底差在哪裡。
所以今天調整了這兩段:前面加入自然語言意圖判斷,後面補上四項評分和理由。完整流程變成:
使用者說出需求 → 判斷是否要建立專案 → 收集資料
→ Agent 討論 → Review 評分 → 顯示結果
原本的入口主要辨識「我要做一個網站」這類固定格式。這條快速路徑我仍然保留,因為規則能直接判斷時,就沒有必要每次都等待模型。
遇到其他說法,例如「想開一間咖啡廳」或「幫我規劃一個記帳 App」,訊息才會交給 ProjectIntentAgent。它會請本機的 Qwen 判斷三件事:
回傳結果分成 create_project、not_project 和 uncertain。只有判斷為建立專案,而且信心值至少為 0.8,Bot 才會進入確認階段。
if intent.intent == "create_project" and intent.confidence >= 0.8:
    session = intake.start_from_title(
        session_key,
        intent.title,
        stage="intent_confirmation",
    )
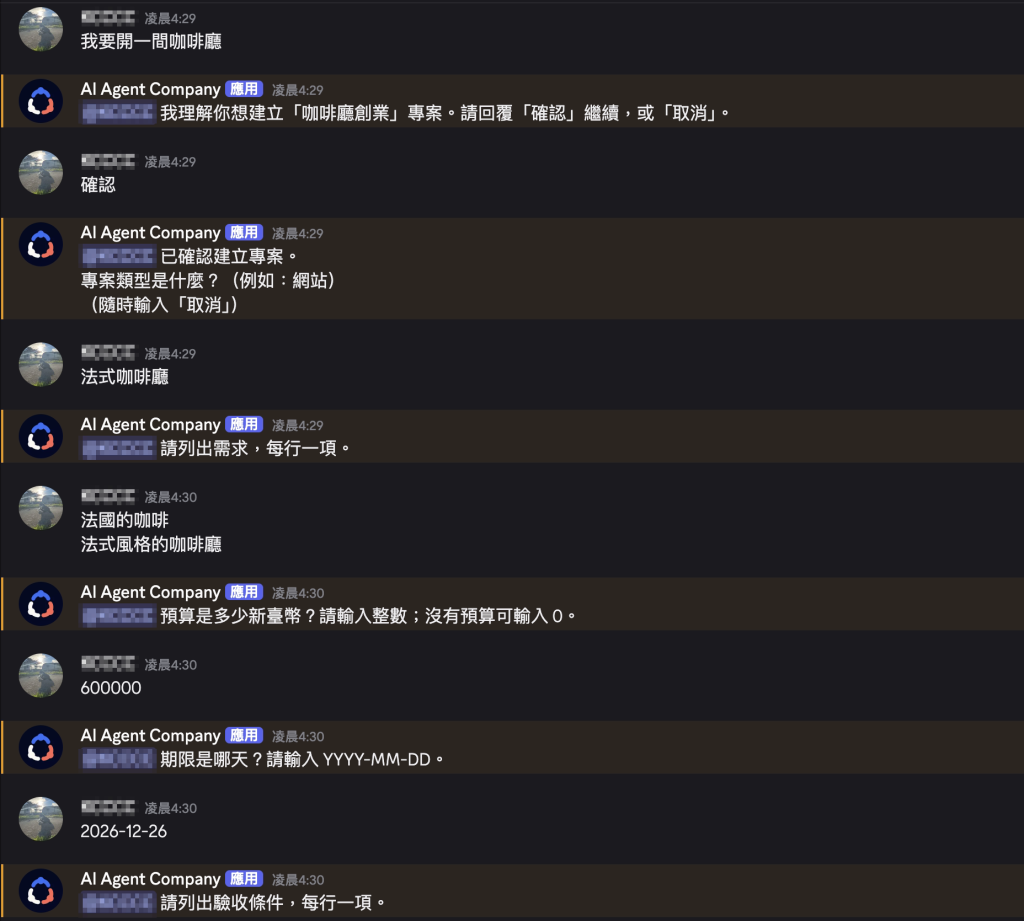
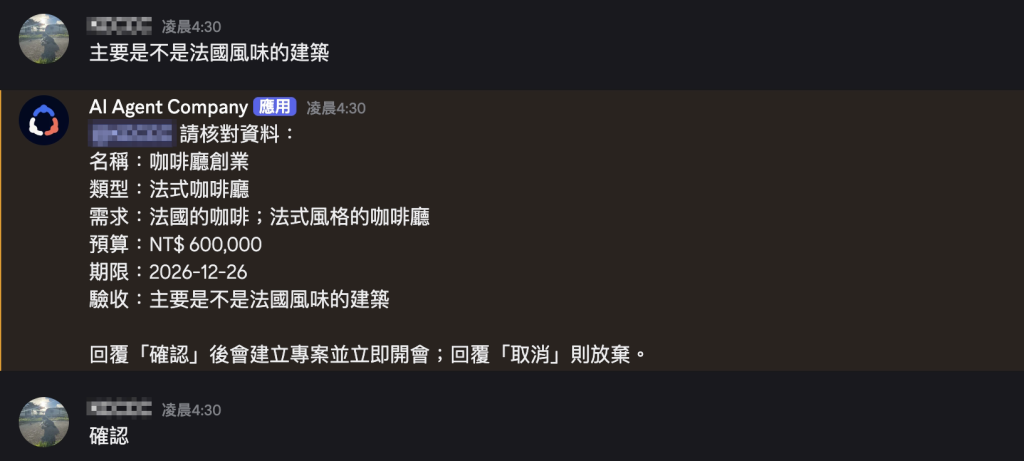
這裡沒有讓模型直接建立資料。Bot 會先顯示理解到的專案名稱,等使用者回覆「確認」後,才繼續詢問類型、需求、預算、期限和驗收條件。全部資料整理完,還要再確認一次,才會寫入 MySQL 並開始 Agent 會議。
如果模型逾時、回傳格式錯誤,或信心值不足,Bot 只會提供可用的輸入範例,不會擅自建立專案。
第一次測試「我要開一間咖啡廳」時,模型判斷這是建案需求,信心值也有 0.95,卻漏掉了 title。Pydantic 因此拒絕這份資料。後來我把 title 改成建立專案時的必要欄位,再回到 Discord 測試,Bot 已能整理出專案名稱並進入確認流程。
入口能聽懂需求之後,下一個問題出現在流程尾端。
Review 原本可以判斷草案是否通過,但只看到結果,使用者仍不知道問題出在哪裡。今天把審查內容拆成四個面向:完整度、創意、可信度和可行性。每項都是 1~5 分,還要附上判斷理由。
class ChecklistItem(BaseModel):
    score: Annotated[int, Field(strict=True, ge=1, le=5)]
    reason: ReviewReason
strict=True 可以避免模型用字串或小數代替整數,ge=1 和 le=5 則把分數限制在指定範圍。理由為空、分數超出範圍,或缺少任何一個面向,都不會進入後續計算。
目前的通過條件是四項都至少 3 分。不過 3 分只代表達到基本標準,因此低於 4 分的項目仍會被列為待改善的地方。這樣畫面就能同時回答兩件事:草案能不能通過,以及哪裡還可以補強。
四項分數由 Review Agent 提供,加權結果則由 Python 計算。這樣同一組輸入一定會得到相同結果,也比較容易寫測試。
權重會按照專案的優先目標調整。例如「成本效益」比較重視可行性,「創新」則提高創意的比重。
| 優先目標 | 完整度 | 創意 | 可信度 | 可行性 |
|---|---|---|---|---|
| 成長 | 0.30 | 0.25 | 0.15 | 0.30 |
| 成本效益 | 0.20 | 0.10 | 0.25 | 0.45 |
| 品牌影響 | 0.25 | 0.20 | 0.40 | 0.15 |
| 創新 | 0.20 | 0.45 | 0.15 | 0.20 |
計算方式很單純:先求出 1~5 分的加權平均,再換算成百分制。
weighted_score = round(
    sum(scores[key] * weights[key] for key in DIMENSIONS),
    2,
)
quality_index = round(weighted_score / 5 * 100, 1)
品質指標達 90 分會顯示「優秀」,75 分以上是「良好」,60 分以上是「需改善」,低於 60 分則標為「高風險」。這些等級和改善建議都是程式中的固定規則,不是讓模型再自由產生一次。
專案的優先目標會在會議開始時保存。即使管理員後來更改工作區設定,已開始的會議仍會使用原本的權重,避免同一份結果前後對不起來。
完成修改後,我在 Discord 重新跑過流程。使用者可以直接用自然語言說出想做的專案,確認 Bot 理解的名稱後補齊資料,接著讓 Agent 開始討論。到了 Review 階段,畫面會列出四項分數、各自的理由、整體品質指標,以及需要改善的項目。
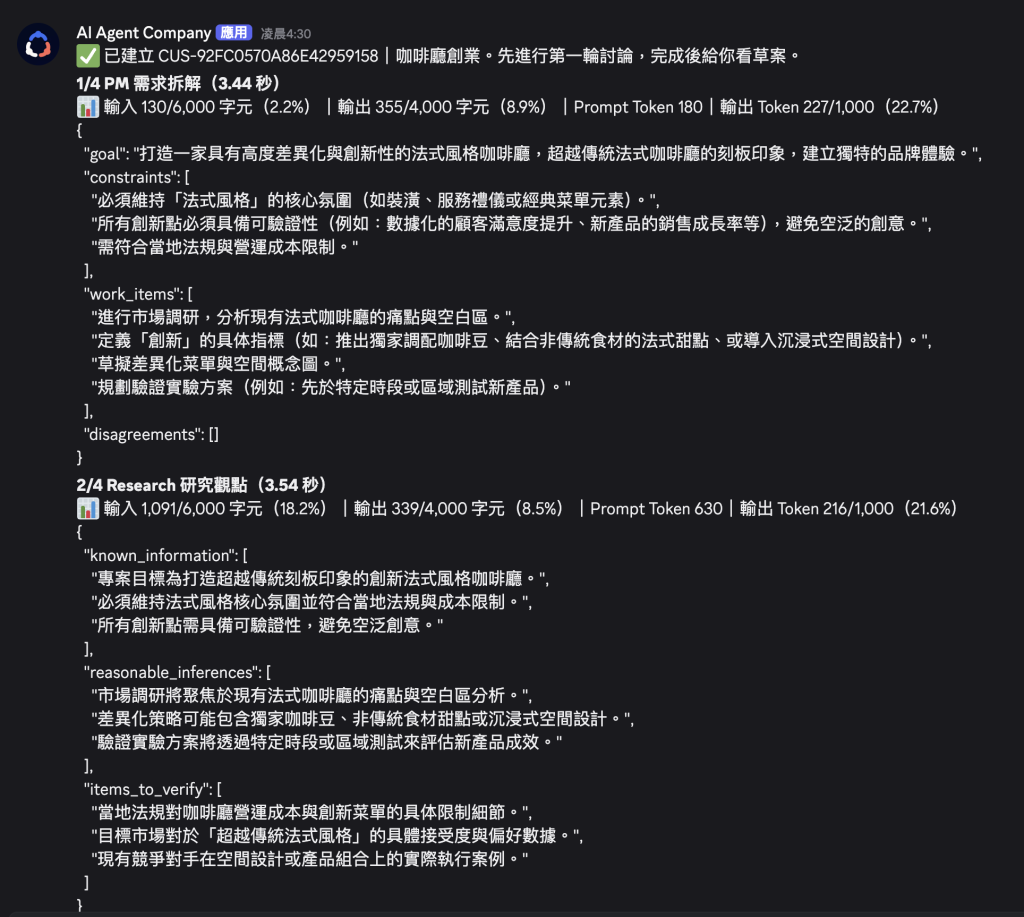
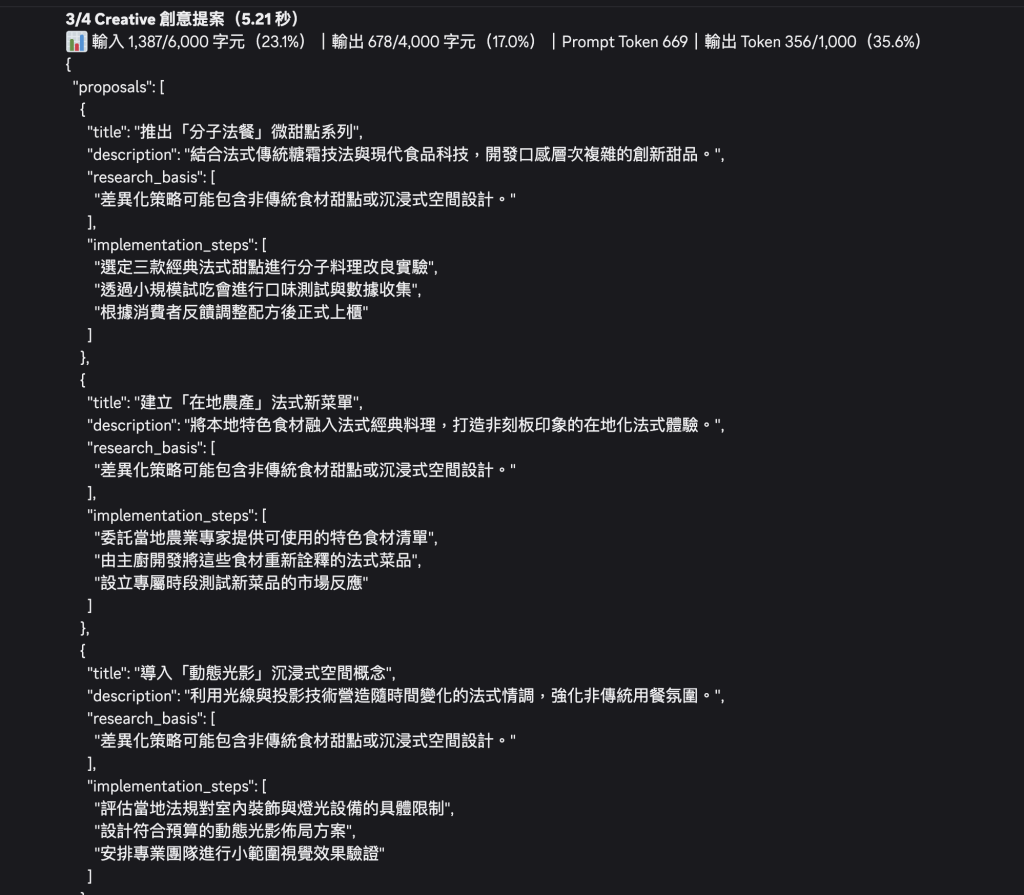
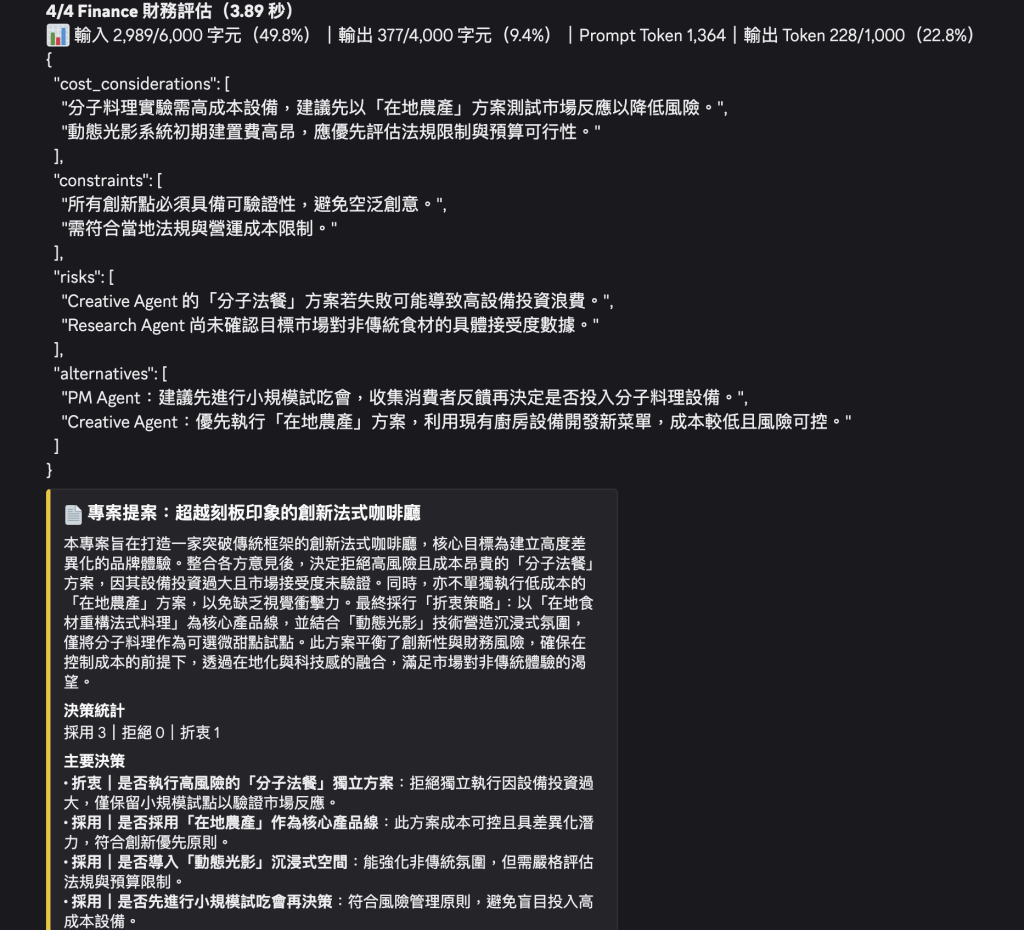
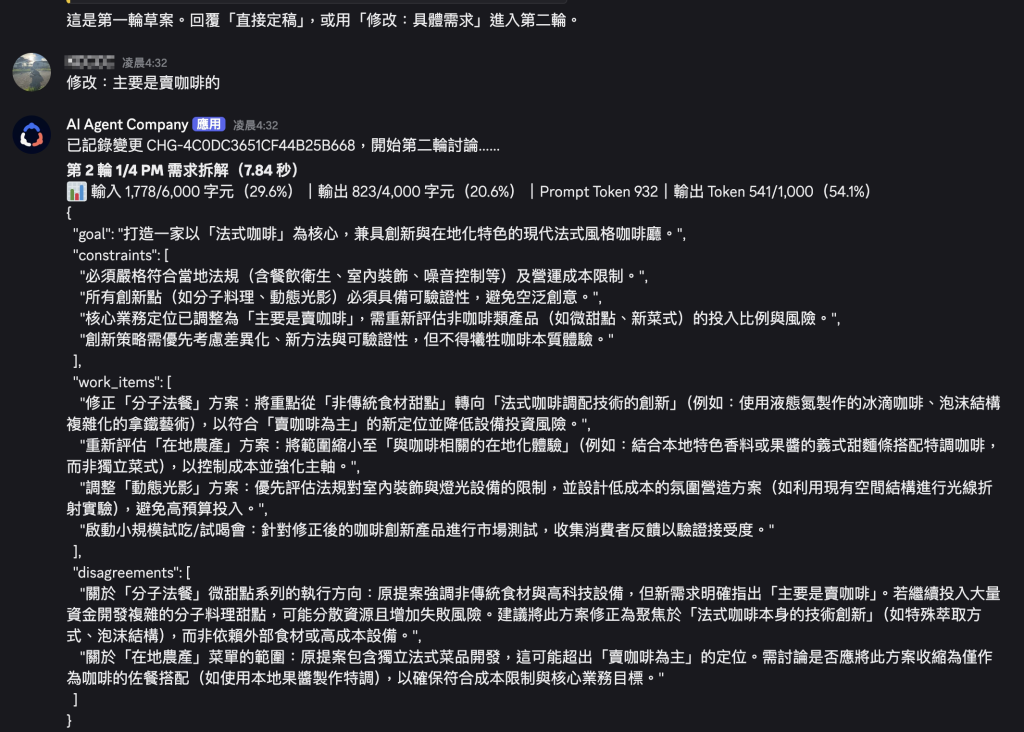
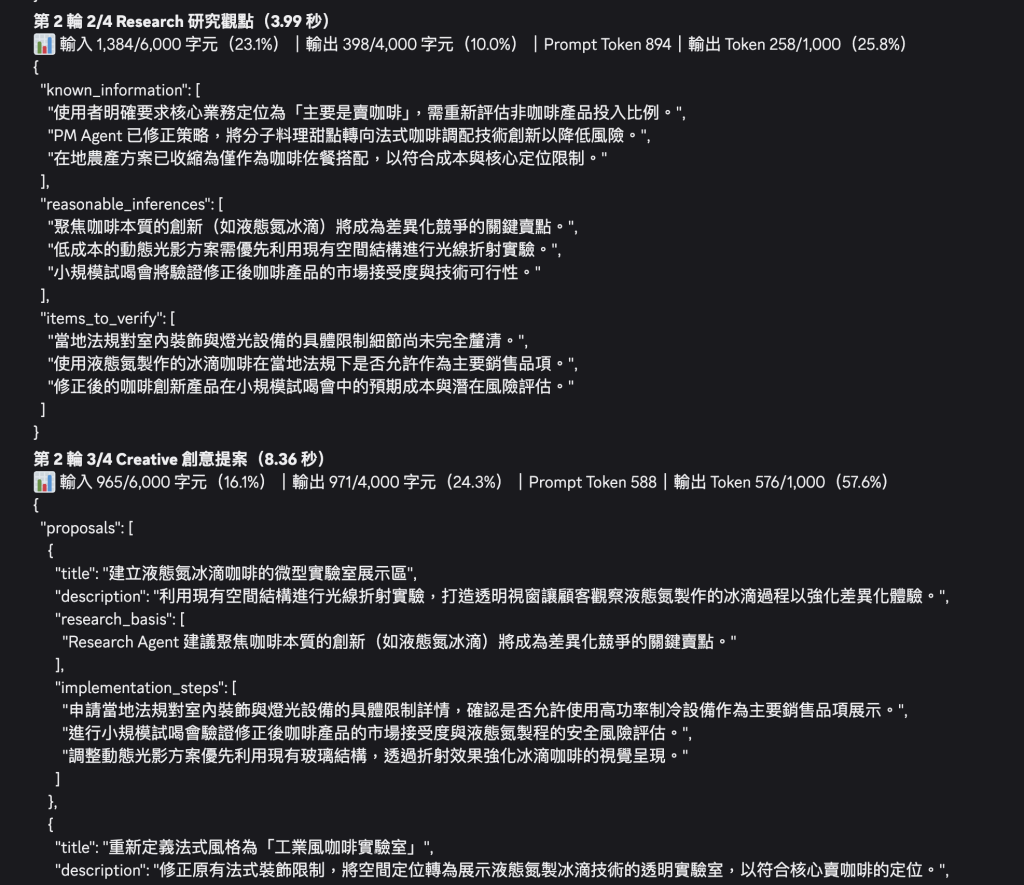
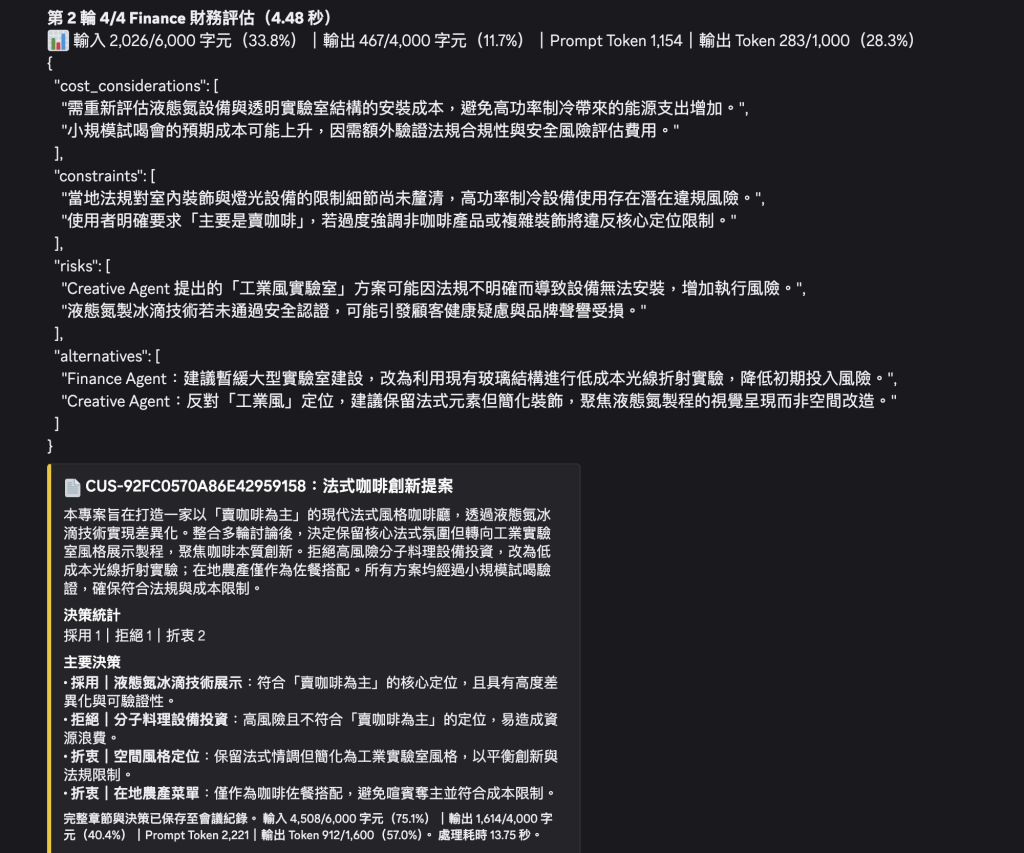
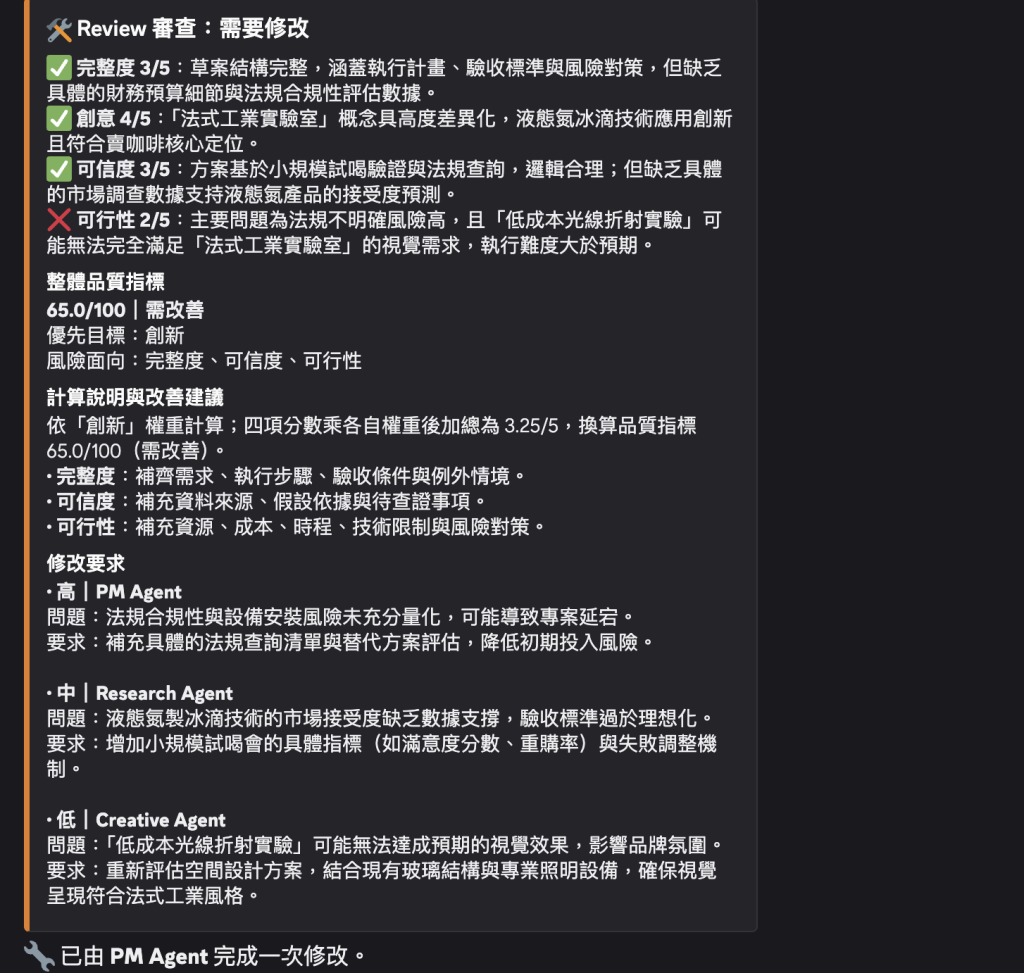
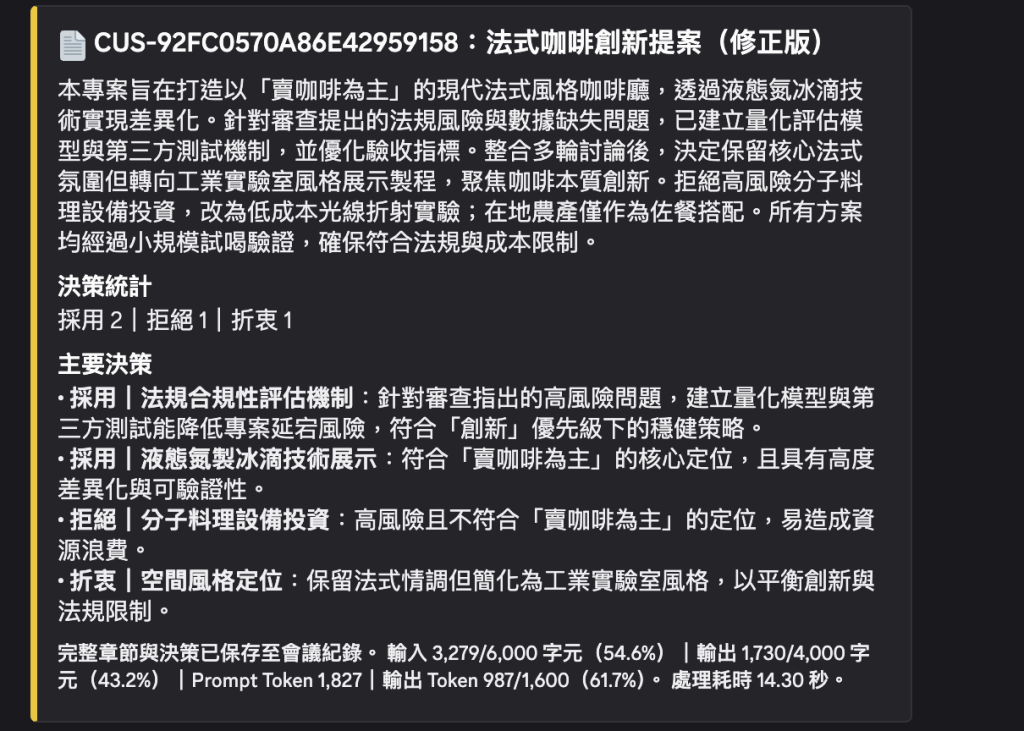
評估資料也會跟著會議寫入 MySQL,包括當時的優先目標、四項分數、權重、理由和公式版本。之後回頭查看某場會議時,不只看得到總分,也能知道那個數字是怎麼算出來的。
目前還有一個限制:如果 Review 要求修改,系統只會讓 Agent 修正一次,還不會對修改後的版本重新評分。因此畫面上的品質指標,代表送進 Review 的那份草案,而不是修改完成後的新分數。
DAY 24 把流程的頭尾接得更完整。使用者不必記住指定句型,也能從 Discord 開始建立專案;Agent 討論結束後,Review 的結果也不再只剩下一句「通過」或「不通過」。下一步就是把修改後重新評分補上,讓最後顯示的分數真正對應到定稿版本。


 iThome鐵人賽
 看影片追技術