
第十五天!我們不知不覺已經完成了 30 天鐵人賽的一半進程。從最一開始的環境建置、NumPy 矩陣運算,到 Pandas 的資料清理、分組聚合、時間序列處理,再到 Matplotlib 與 Seaborn 的圖表視覺化,以及昨天的特徵工程縮放。今天我們不講新語法,而是要進行半程綜合驗收實戰——建立一條完整的「端到端資料分析管線(End-to-End Data Pipeline)」,把前兩週所學的所有技巧串聯在單一腳本 day15_mini_project.py 中!
第一部分
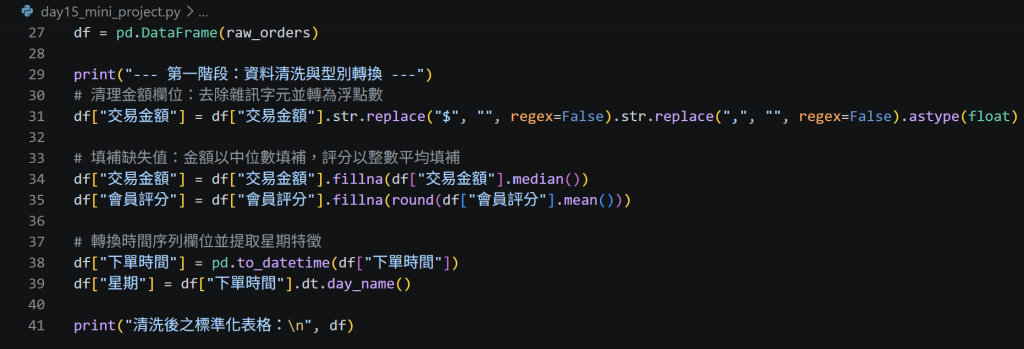
新建 day15_mini_project.py。建立一組包含缺失值、字串雜訊、時間欄位與分類標籤的電商訂單資料,並使用 Day 5~7 所學的技巧完成第一階段「清洗與型別校正」: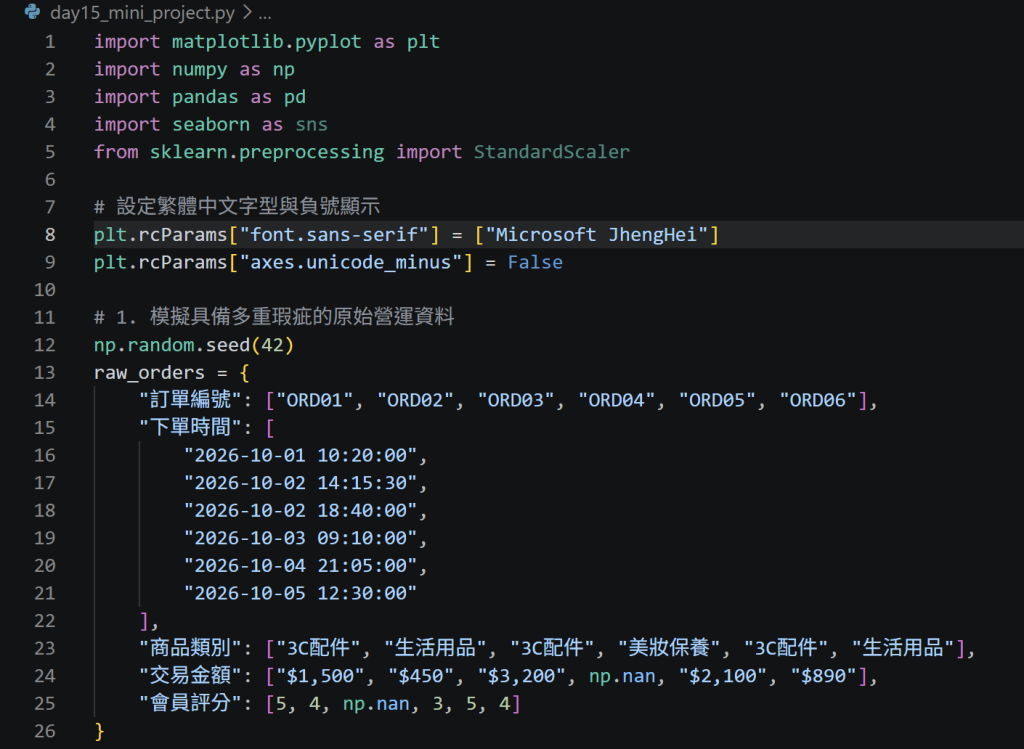
第二部分
接著進行「分組聚合與業務指標統計」,套用 Day 8 學到的 groupby 搭配 .agg(),依商品類別計算總營收、平均客單價與訂單總筆數: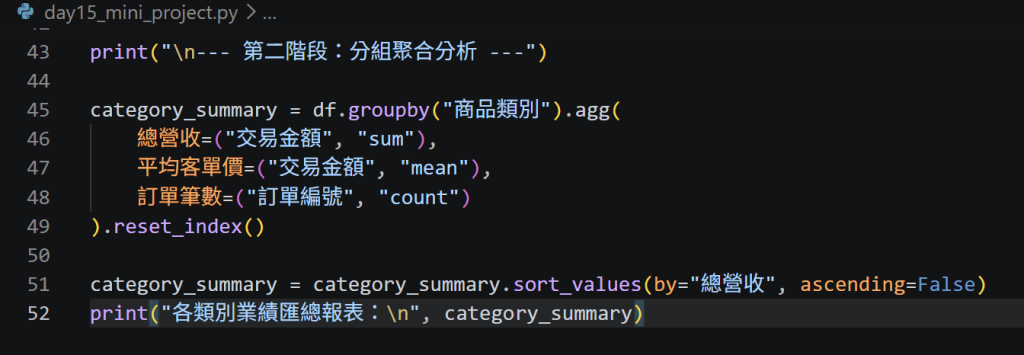
第三部分
進入「特徵工程與視覺化產出」。我們利用昨天學習的 StandardScaler 將金額標準化,並使用 Seaborn 繪製「各商品類別總營收長條圖」,在腳本中直接匯出高品質圖檔: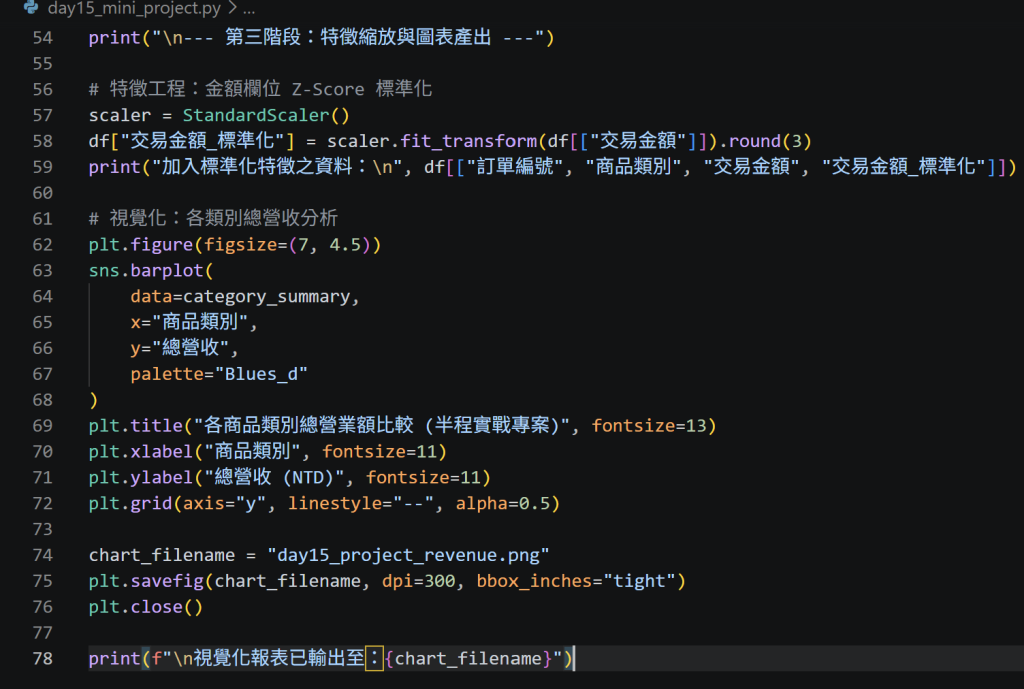
第四部分
在終端機輸入 python day15_mini_project.py 執行驗證,確認清洗流程、分組統計表與圖表生成一氣呵成。按 Ctrl + S 儲存後推送到遠端儲存庫: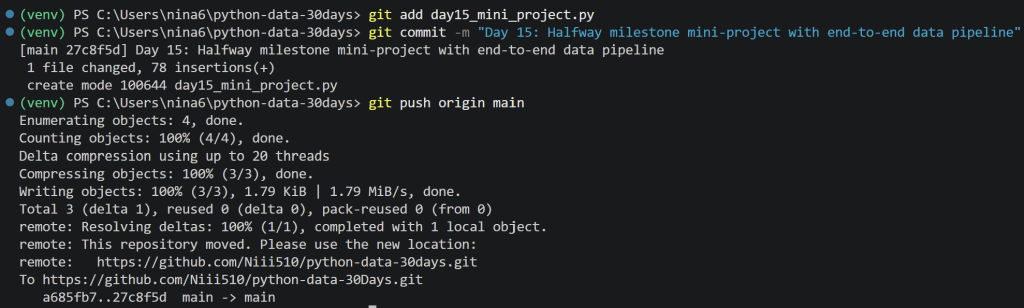
今日心得/遇到的問題
不知不覺就完成了第 15 天!今天把過去零散學習的知識模組全部串聯起來,真正體驗了一位資料分析師拿到髒數據後的完整作業流:數據清洗 ➔ 型別對齊 ➔ 聚合運算 ➔ 特徵縮放 ➔ 報表與圖表輸出。當整套 Pipeline 跑通時特別有成就感,也為接下來下半場的進階統計與模型分析打下了最穩固的底子!

 niii

 iThome鐵人賽
 看影片追技術