
第二十二天,我們要探討資料科學領域經典的資料壓縮與降維技術——主成分分析(Principal Component Analysis,簡稱 PCA)。在真實資料集或生醫檢測中,欄位往往多達十幾個甚至上百個(即「維度災難」),這不僅大幅增加運算成本,更讓我們難以直接在平面上畫出資料的全貌。PCA 透過旋轉座標軸,找出資料變異量最大的正交方向(主成分),將高維度資訊投影至低維度空間。今天我們建立純 Python 腳本 day22_pca_dimension_reduction.py,掌握特徵降維至二維平面並視覺化其解釋變異量。
第一部分
新建 day22_pca_dimension_reduction.py。首先載入包含 4 個特徵欄位的鳶尾花資料集,在進行正交投影前,必須先使用 StandardScaler 將特徵進行標準化,確保每個特徵對共變異數矩陣的貢獻不受尺度大小左右: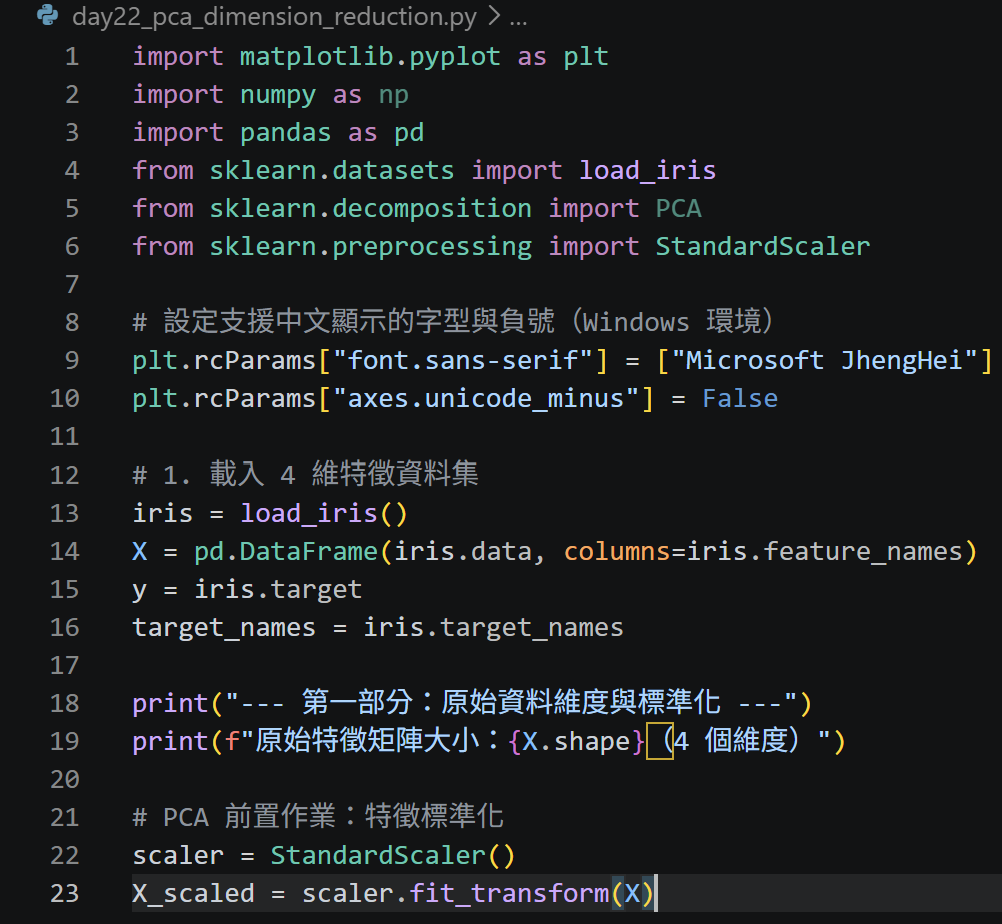
第二部分
初始化 PCA(n_components=2),將原本的 4 維特徵空間壓縮為 2 個主成分(PC1 與 PC2)。降維完成後,檢視各主成分保留的「解釋變異量比例(Explained Variance Ratio)」,評估降維過程是否保留了絕大多數的原始資訊: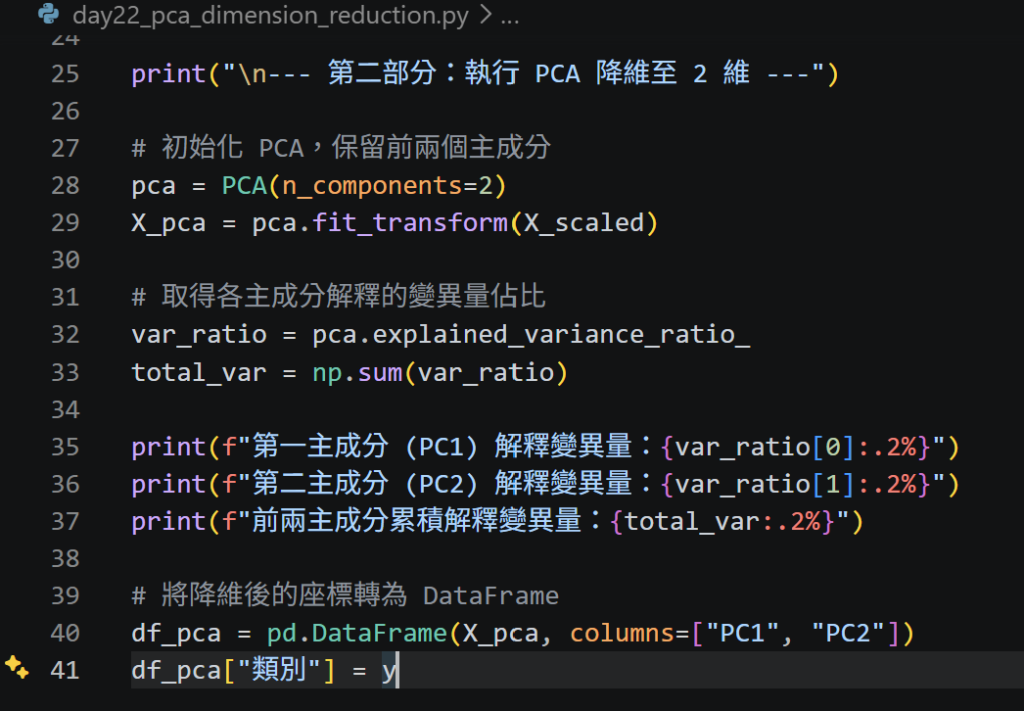
第三部分
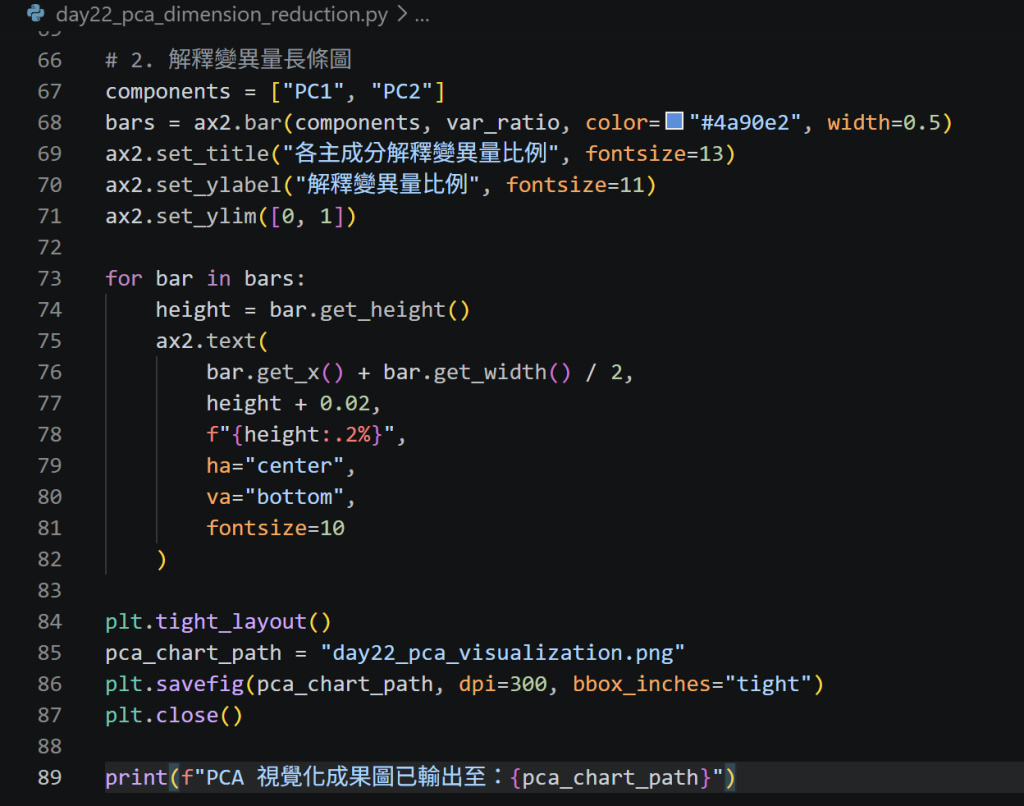
將降維後的 2 維特徵投影繪製成平面散佈圖,並根據植物品種塗上不同顏色;同時繪製累積解釋變異量長條圖,直觀檢驗高維壓縮至低維的效果: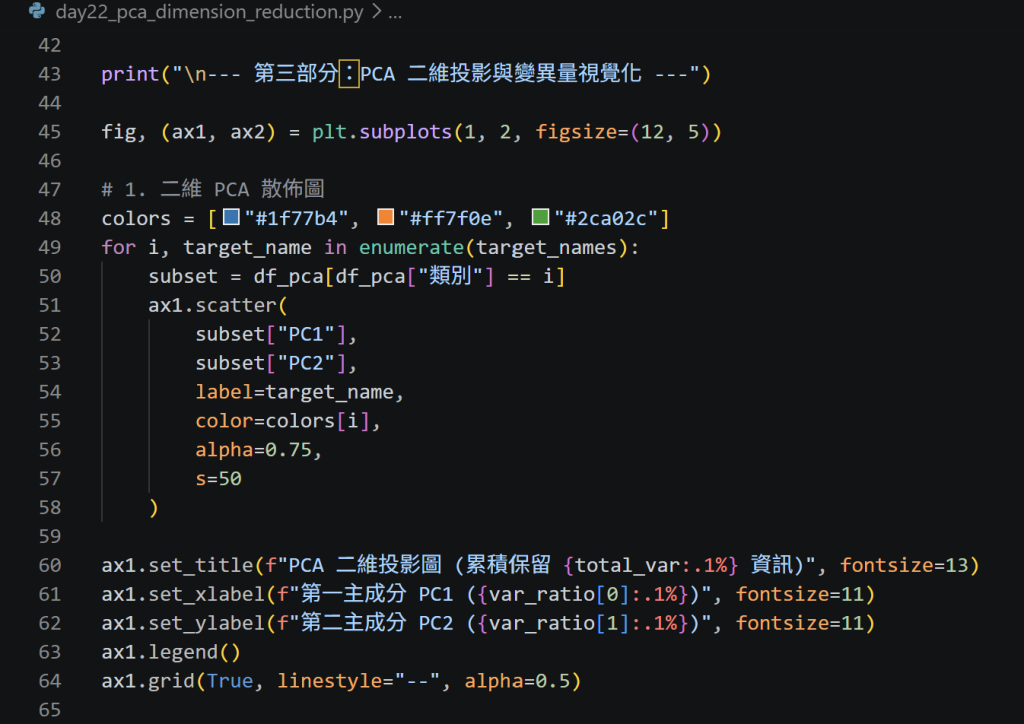
第四部分
在終端機輸入 python day22_pca_dimension_reduction.py 執行驗證,確認主成分解釋比例(PC1 與 PC2 總計保留超過 95% 資訊)順利印出,且圖片 day22_pca_visualization.png 順利產出。確認按 Ctrl + S 存檔後推送到 GitHub 進行版本控制: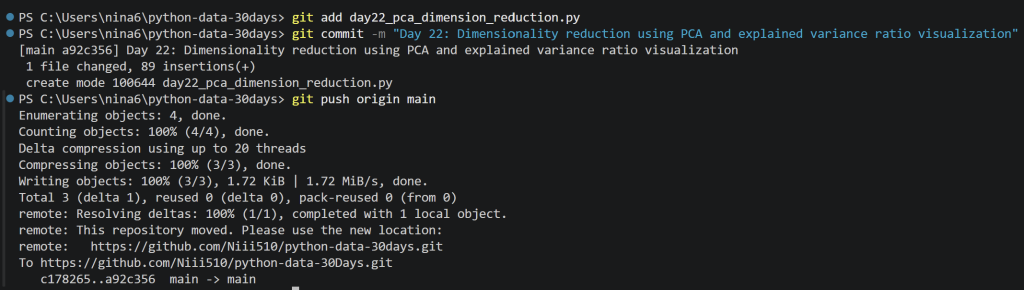
今日心得/遇到的問題
今天體驗了 PCA 的降維威力。人類的大腦與螢幕只能直觀感受二維或三維空間,但真實數據往往有數十個維度。透過 PCA,我們將 4 個特徵壓縮到僅剩 2 個主成分,卻保留了超過 95% 的原始資料變異量,而且投影到平面上後,品種之間的邊界依然清晰可辨。在做 PCA 前,務必要記得呼叫 StandardScaler,否則數值範圍最大的欄位會主導主成分軸的旋轉方向,導致降維失真。

 niii

 iThome鐵人賽
 看影片追技術