
第二十三天,我們要進入機器學習工程師最關鍵的調校利器——交叉驗證(Cross-Validation) 與 超參數網格搜尋(GridSearchCV)。在前面的篇章中,我們只用單次 train_test_split 切分訓練集與測試集,但單次切分很可能因為「運氣好(抽到簡單資料)」或「運氣差(抽到極端樣本)」而產生評估偏差。此外,模型的超參數(如隨機森林的樹木數量、決策樹的最大深度)往往需要嘗試多種排列組合才能找出最佳解。今天我們建立純 Python 腳本 day23_gridsearch_cv.py,掌握 5-Fold 交叉驗證 的評估流程,並自動搜尋出表現最優異的模型超參數組合。
第一部分
新建 day23_gridsearch_cv.py。首先載入紅酒品質分類資料集(Wine Dataset),並使用 cross_val_score 示範 5-Fold 交叉驗證的運作原理——將資料分成 5 份,輪流以 4 份訓練、1 份驗證,最後計算平均準確率與標準差: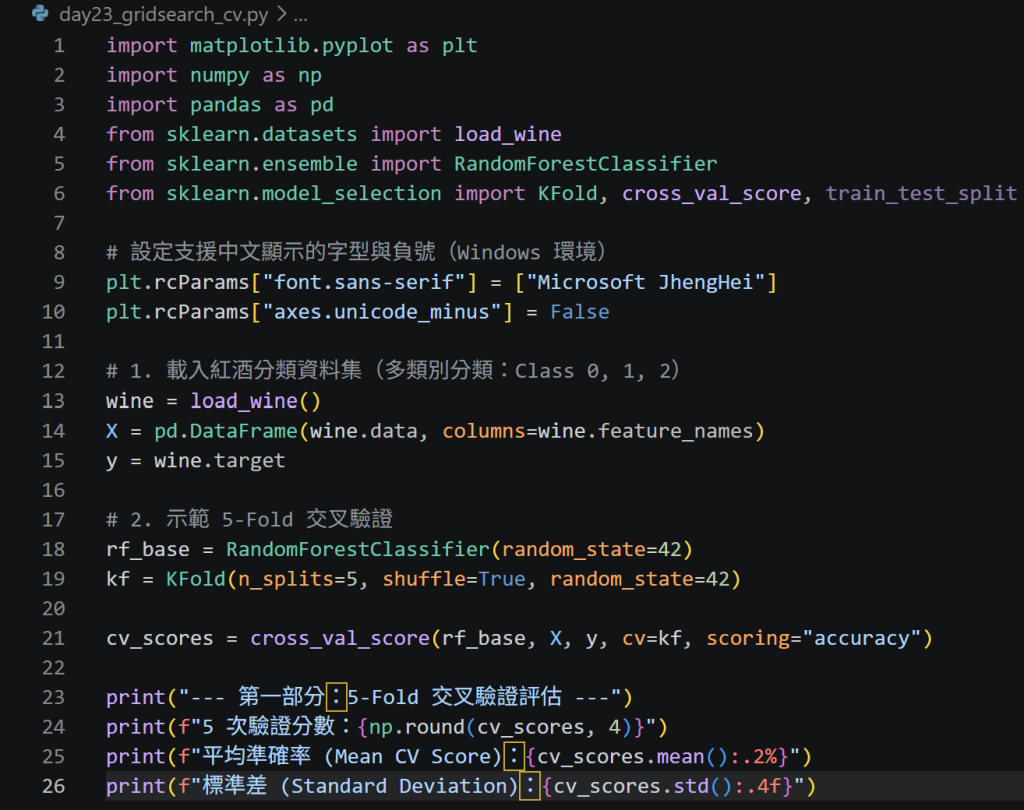
第二部分
接著進行全自動調參。我們使用 GridSearchCV,針對隨機森林定義參數網格字典(param_grid),測試不同數量的樹(n_estimators)以及最大深度(max_depth)的組合。GridSearchCV 會自動為每種組合執行 5 次交叉驗證,並選出整體泛化能力最好的參數配置: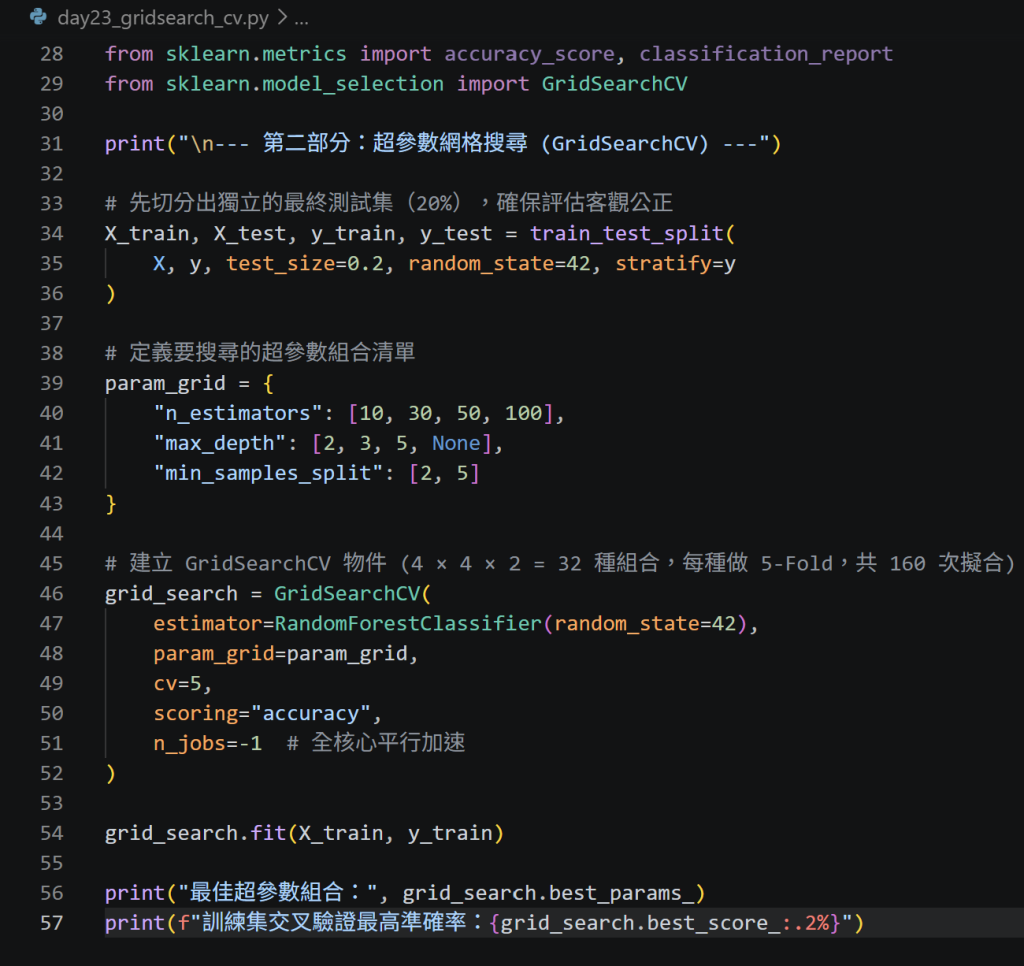
第三部分
取得最佳模型 best_estimator 後,使用從未參與過調參的獨立測試集 Xtest 驗證其最終預測表現,並將調參過程中的主要參數表現繪製成熱力圖(Heatmap)進行可視化分析: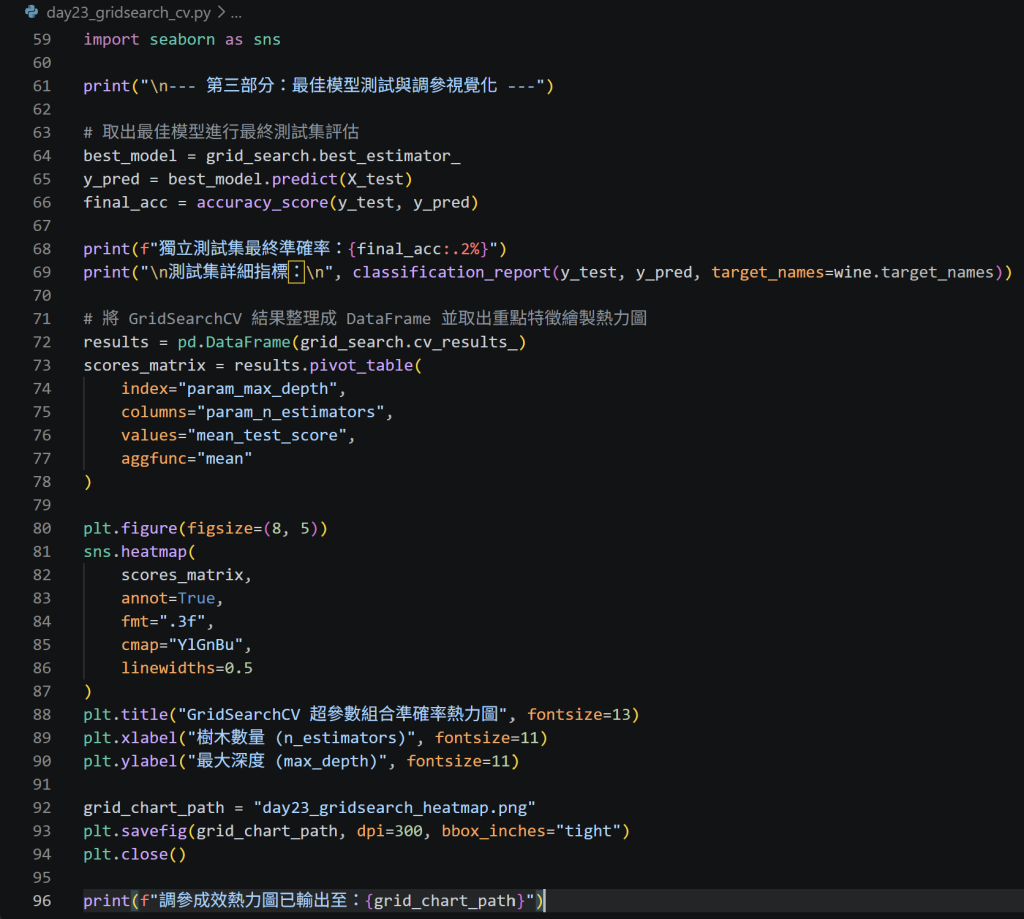
第四部分
在終端機輸入 python day23_gridsearch_cv.py 執行驗證,確認 160 次交叉驗證運算完成,終端機輸出最佳參數與最終準確率,且圖片 day23_gridsearch_heatmap.png 順利產出。確認存檔(Ctrl + S)後推送到 GitHub 進行版本控制: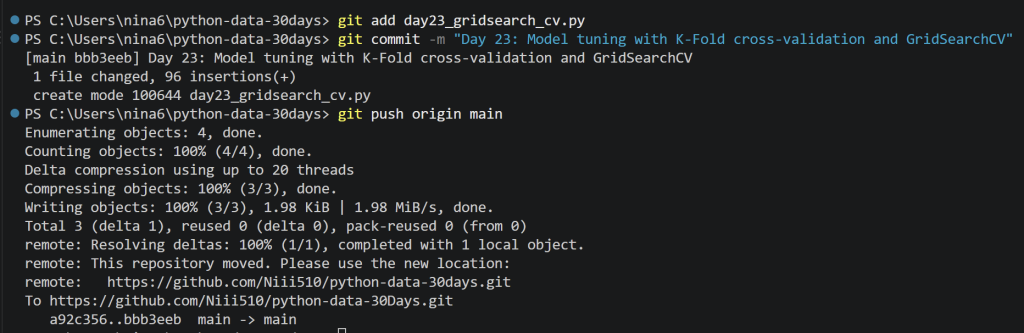
今日心得/遇到的問題
今天學會了機器學習調參最專業的標準做法。以往如果只看單次切分的成績,很容易因為剛好分到容易預測的測試資料而給予模型過高的評價;透過 K-Fold 交叉驗證,能將資料利用率最大化並取得穩定可靠的泛化指標。而 GridSearchCV 搭配 n_jobs=-1 更是大幅解放雙手,能讓電腦自動跑完全部排列組合並回傳最佳模型,搭配熱力圖更能一眼看出「深度多深、樹木多大」能帶來邊際效應最大化。

 niii

 iThome鐵人賽
 看影片追技術