
第二十四天,我們要面對現實資料科學中最具挑戰性的痛點——類別不平衡(Class Imbalance)。在信用卡盜刷偵測、罕見疾病篩檢或設備故障預測中,正樣本(少數類)往往只佔全部資料的 1% 甚至不到 0.1%。如果直接把這種資料丟給機器學習模型,模型只要「無腦全部猜多數類」,就能輕易拿到 99% 的準確率,但卻完全無法捕捉到真正的關鍵少數。今天我們建立純 Python 腳本 day24_imbalanced_data.py,掌握少數類權重調整(class_weight)以及使用 SMOTE(合成少數過取樣技術)平衡資料分佈。
第一部分
新建 day24_imbalanced_data.py。首先模擬一組高度不平衡的金融詐欺資料(正常交易佔 95%,詐欺交易僅佔 5%),並展示單純訓練邏輯斯迴歸時,召回率(Recall)過低的陷阱: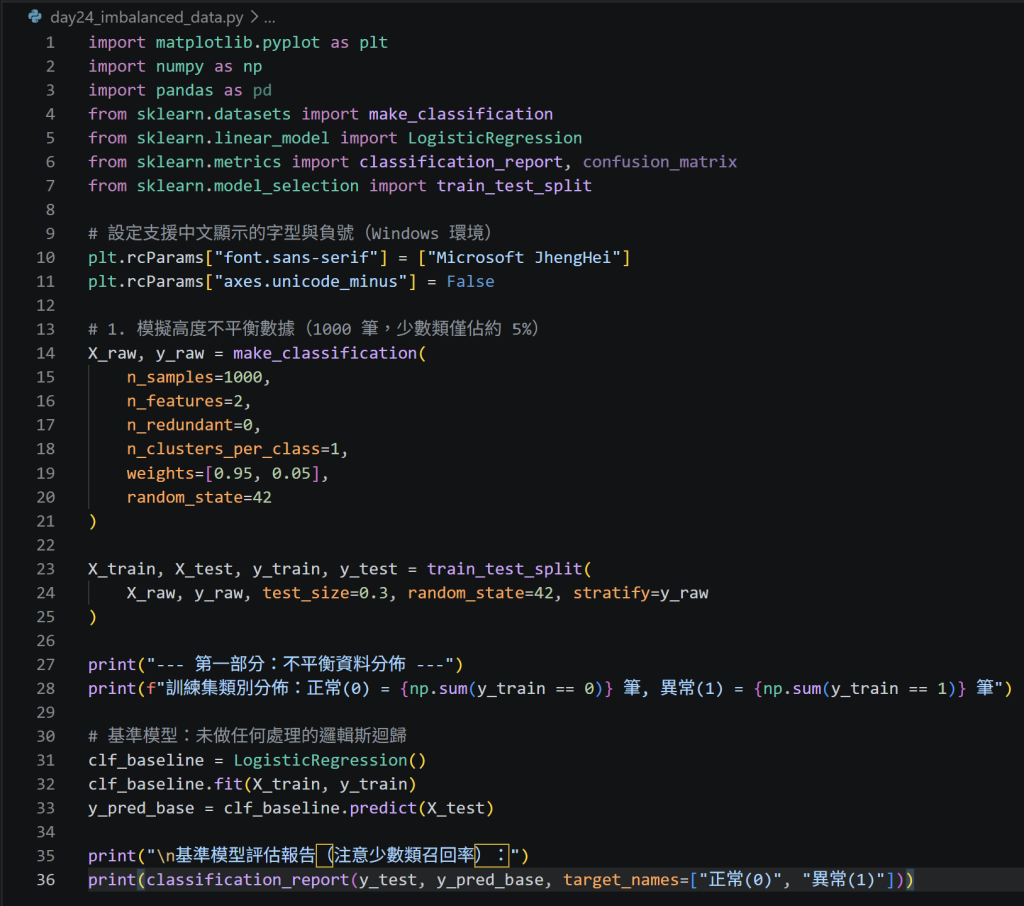
第二部分
解決不平衡的第一種快速技巧是調整演算法內建的 class_weight="balanced"。此設定會根據各類別樣本數量的反比自動給予少數類更高的懲罰權重,迫使模型在犯錯時付出更大代價: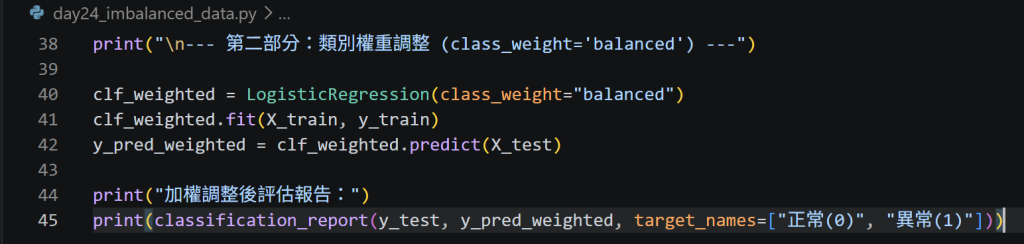
第三部分
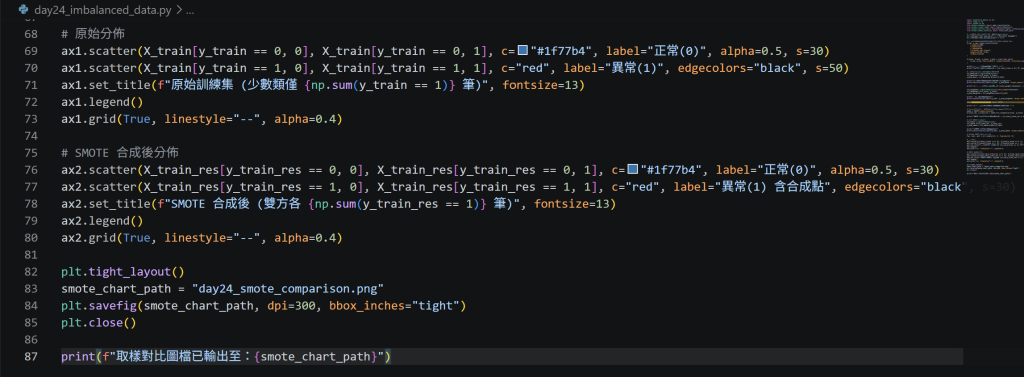
第二種也是業界最主流的進階技巧是 SMOTE(Synthetic Minority Over-sampling Technique)。它不是單純複製少數樣本,而是透過 K-Nearest Neighbors 在少數類樣本之間進行線性插值,合成出全新的少數類數據。我們使用 imblearn 執行 SMOTE 平衡訓練集,並繪製採樣前後的特徵散佈圖: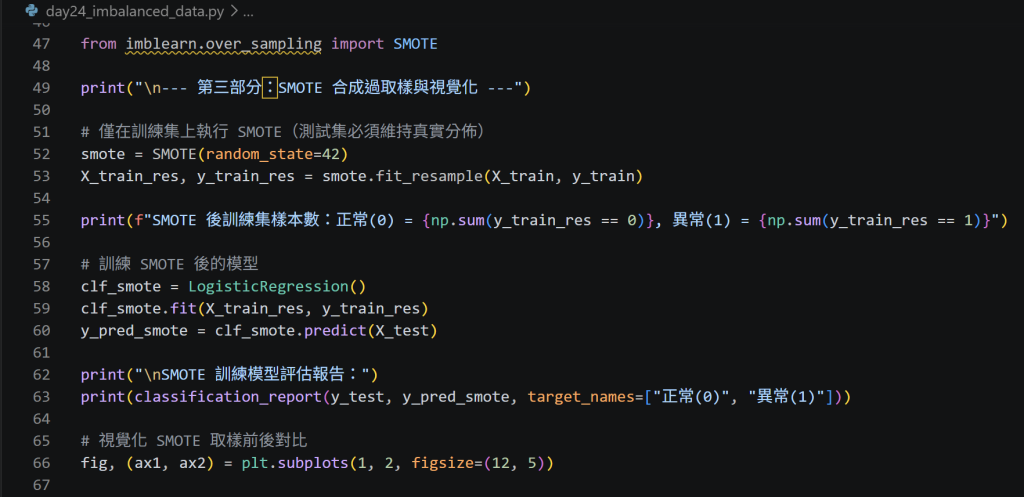
第四部分
在終端機輸入 python day24_imbalanced_data.py 執行驗證,確認基準模型、加權模型與 SMOTE 模型三者的召回率提升變化,且圖片 day24_smote_comparison.png 順利產出。按 Ctrl + S 儲存後推送到 GitHub 進行版本控制: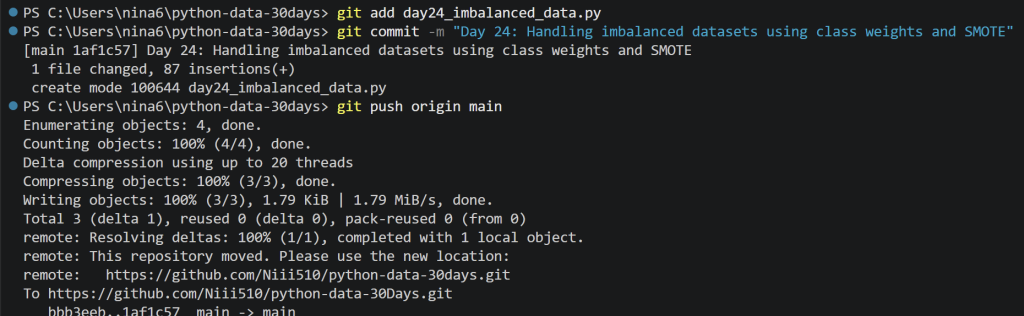
今日心得/遇到的問題
今天體會到真實世界資料處理中最關鍵的一課:在不平衡資料集中,「準確率」是最具欺騙性的指標。未處理前,基準模型的整體準確率雖然超過 95%,但針對少數異常樣本的召回率可能只有可憐的 20%~30%,這在詐欺偵測或醫療診斷中是完全不可接受的。透過 class_weight='balanced' 或 SMOTE 合成樣本,能顯著拉升對少數類的敏感度。同時要牢記一個核心原則:過取樣只能作用在訓練集(Train Set),絕對不能碰測試集(Test Set),否則會造成嚴重的資訊洩漏(Data Leakage)。

 niii

 iThome鐵人賽
 看影片追技術