
副標:同樣是半年一更,V2.6-Flash 卻把小米從「堆預訓練」帶向「強化學習自我迭代」——更小、更聰明、還多了眼睛和耳朵
大多數人看到「小米又更新模型」這種消息,直覺是劃過去——反正大模型每週都在出。但這次 V2.6-Flash 值得停下來看一眼,原因是它和半年前的 V2.5 不在同一條技術路線上:上一代是「把模型做大、把資料堆多」,這一代則是把算力的重心從預訓練挪去真實環境的強化學習。結果出現了一個反直覺的組合——參數縮水、智能翻倍、多出多模態、價格卻一分未漲。以下不列參數清單,而是沿著「它到底換了什麼方法」這條線,把這次升級講清楚。
談升級之前,有個事實比任何規格都重要:上一代主力 MiMo-V2.5-Pro 的 API 已經在 2026-10-21 正式失效。在那之前還有約一週的「軟切換」緩衝(舊名稱會自動轉發到新模型),但緩衝期過後,還在呼叫 mimo-v2.5-pro 的服務會直接報錯。
換句話說,這不是「要不要升級」的選擇題,而是「你的線上服務什麼時候會斷」的計時器。V2.5 目前只剩開源權重能自己架,官方雲端入口已經不存在。這也是為什麼它值得現在讀——關乎的是遷移,而不是獵奇。
V2.5 是一個純文字模型:能聊、能寫、能呼叫工具,但對圖片、影片、聲音完全「失明失聰」。要在上一代做視覺相關的功能,你得起一套獨立的視覺模型,再把兩邊拼起來。
V2.6-Flash 在架構裡直接嵌進了約 681M 參數的視覺編碼器(MiMo ViT)與音訊編碼器,讓文字、圖像、影片、聲音全部匯進同一條 token 流,經過混合注意力主幹處理後,統一產出文字。下圖就是這條共享輸入流的樣子:
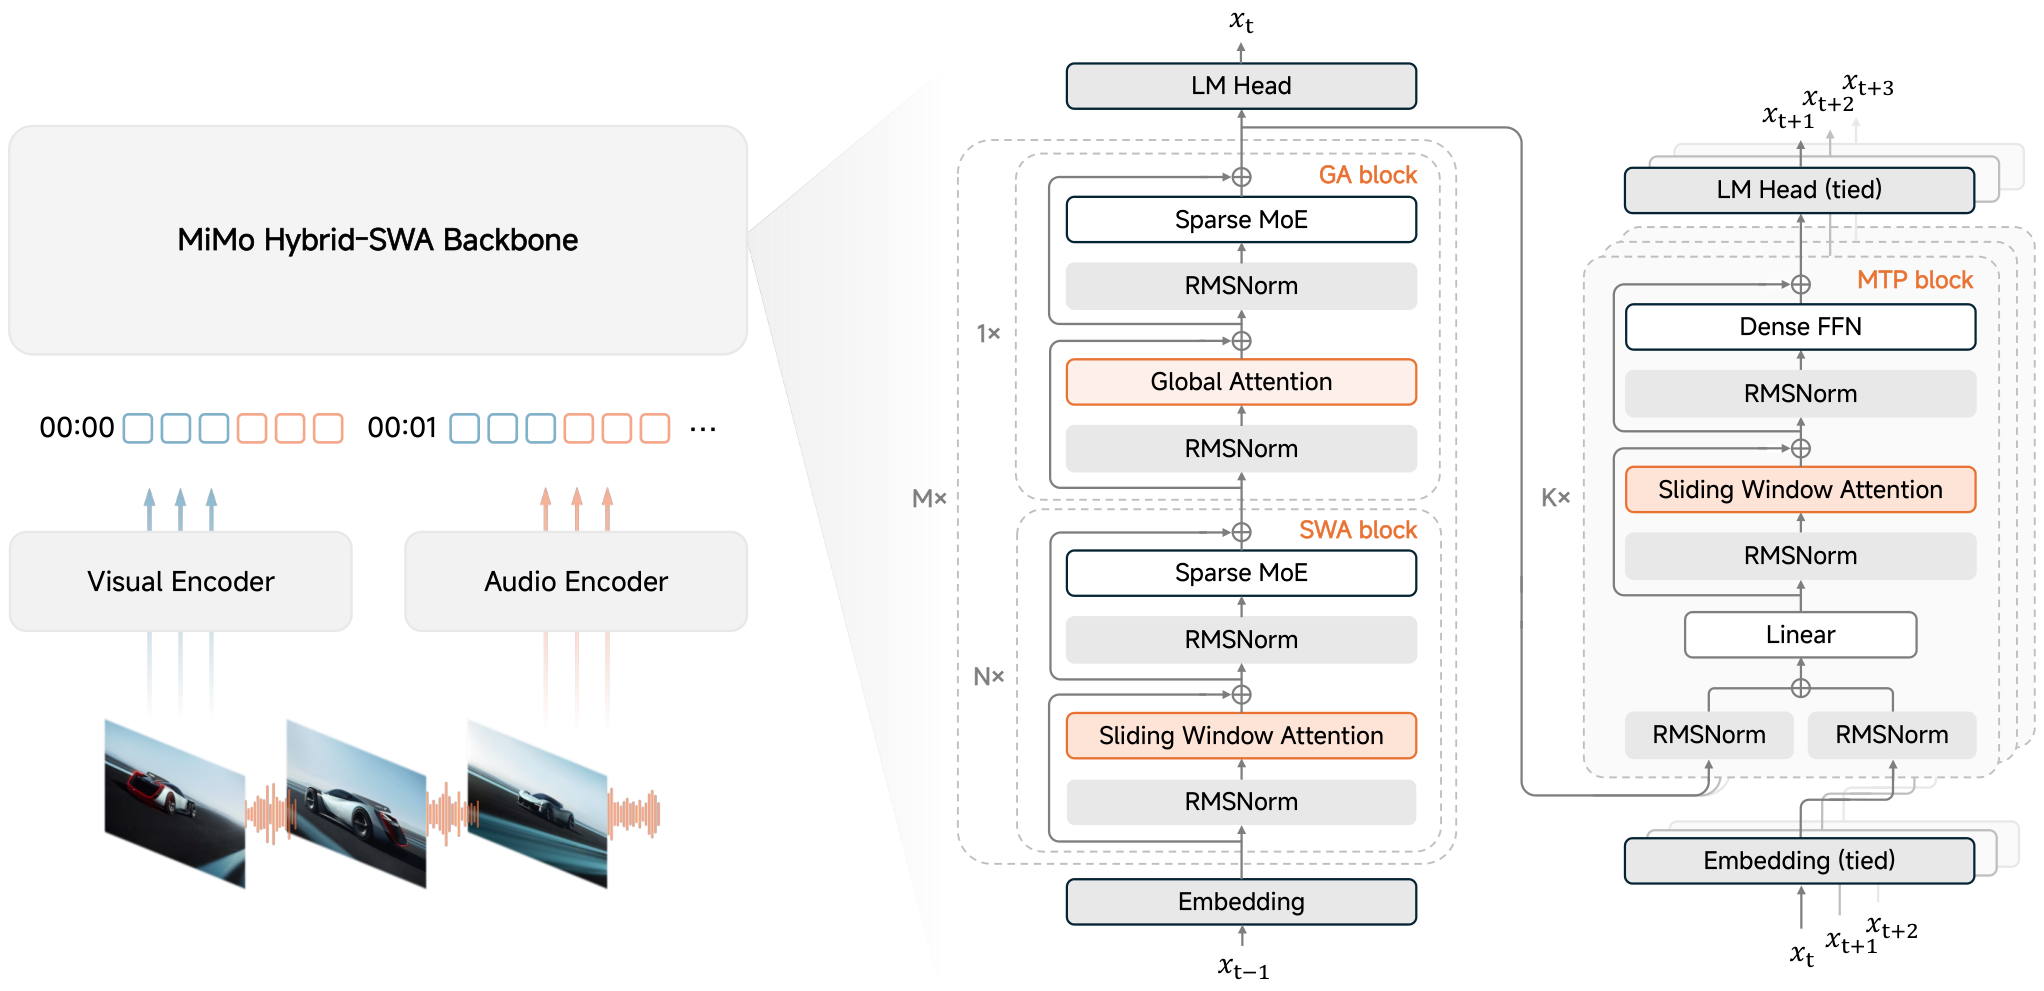
對使用者來說,意義在於你不再需要維護「視覺模型 + 語言模型」的拼接架構——上傳一張圖、一段影片或一段錄音,它就能直接理解並據此回答、寫程式、做分析。這一步是把「多模態」從外接插件變成了原生能力。
如果只看數字,V2.6-Flash 像是「縮水版」:總參數從 V2.5-Pro 的 1.02T 降到 309B,每個 token 活化的參數從 42B 降到 15B,體量小了三分之二以上。但綜合智能(Artificial Analysis 指數)卻從約 21.6 漲到約 37.9,接近翻倍。
關鍵不在參數量,而在訓練方法。這一代的核心敘事是 RSI(遞迴自我改進),小米稱之為「You Only RL Once」——以可驗證的複雜任務為基礎,一次強化學習同時跑通程式碼、通用推理、視覺、資安四類任務。Flash 這版以一個 9B 的基底模型為起點,不到 6 天、約 85 萬美元、30 步迭代、累計約 75 萬條軌跡就完成訓練。下面的曲線說明:能力是隨強化學習的累計花費往上走的,不是靠預訓練堆出來的。
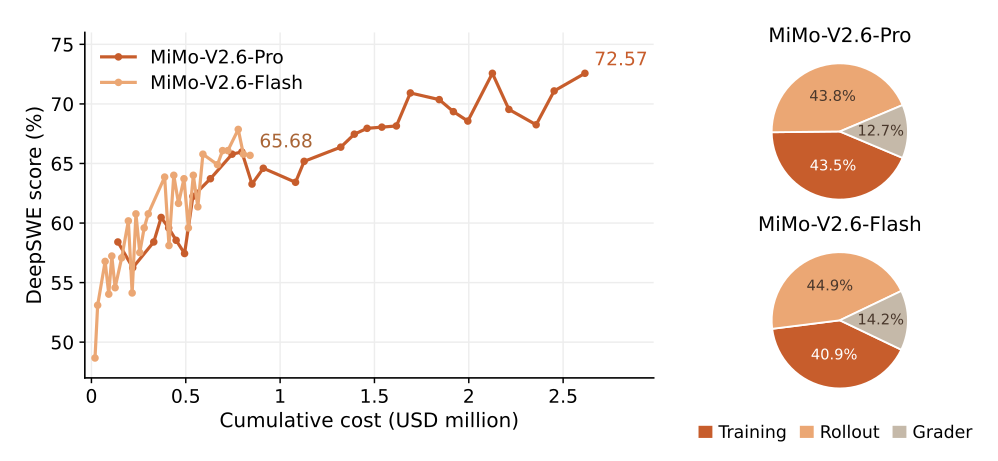
這張圖同時回答了另一個疑問:為什麼小米敢說「更小卻更聰明」。答案不是魔法,而是把原本花在預訓練資料上的算力,轉投到真實場景的強化學習循環裡。對使用者而言,模型變小還有額外好處——推理更省顯存、吞吐更高。
在大多數產品的邏輯裡,能力大躍進通常伴隨漲價。這次相反:V2.6 系列沿用 V2.5 的 API 定價,國內約輸入 ¥1 / 輸出 ¥2 每百萬 token,並提供高達 99% 的上下文快取折扣。等於用一樣的錢,換到多一截智能和多一組感官。
想橫向看這一代家族的完整型號與價格,可參考 小米 MiMo 全部模型(Crazyrouter 彙整的廠商型號頁)。
已經在跑 V2.5 的開發者:這是你最不能忽略的一群。舊 API 名字已失效,等於埋了一顆未爆彈。好消息是遷移極輕——V2.6-Flash 的 API 同時相容 OpenAI 與 Anthropic 兩種協定,通常只需改 base_url 與 model 兩個欄位,程式碼幾乎不用動,還順手升級到了多模態。
想自己架一台的人:開源權重(MIT)能私有化部署,但 309B 不是小數字。FP16 全精度約需 640GB 顯存(相當於 8 張 H100 等級);個人更實際的路是走 Q4_K_M 量化(約 180GB)或直接用官方 API。這一代在「本地能不能輕鬆跑」上並沒有比上代更友好,但多了多模態這塊能力。
只走 API 的輕量使用者:你幾乎是這次升級的最大獲益者。不用管部署、不用管顯存,介面零改動切過去,就同時拿到多模態和翻倍智能,價格還不變。
技術細節方面,V2.6-Flash 採用稀疏 MoE 設計,總參數 309B、每個 token 只喚醒 15B;上下文長度 1,048,576 tokens(1M),最大輸出 128,000 tokens(128K);輸入模態涵蓋文字、圖像、影片、音訊;授權為 MIT,權重可自部署。
Agent 類任務是這一代的強項,相對上代是大幅領先:DeepSWE v1.1 達 67.9、Terminal Bench 2.1 達 87.6、OSWorld-Verified 達 80.8、CyberGym 達 95.1。短板則在超難攻防——ExploitBench 僅 25.3,明顯弱於同代更強的 V2.6-Pro(47.9);另外輸出仍只有文字,聽得到看得到但說不出聲。
回到最實際的問題。如果你原本就在看 V2.5,那根本不是「要不要跟」,而是「舊接口已經斷了,遷移幾乎零成本」——直接平移到 V2.6-Flash 就對了,能力全面覆蓋上代、還多出多模態、價格一致。若想衝開源智能上限,再往上走 V2.6-Pro(綜合智能 46.3,另有 20 倍速的 UltraSpeed 模式);若要和頂尖閉源(Claude Fable 5.1、GPT-6 Astra)比絕對上限,那類需求目前仍該選閉源。
這次升級真正值得記住的,不是「小米又出了個更強的模型」,而是它示範了一種可能:當預訓練的紅利見頂,把算力押在強化學習的自我迭代上,反而能用更小的模型打出更高的智能。對使用者來說,這比任何參數戰都更有意義。
技術參數、基準與定價來自小米官方模型頁、發布說明及公開資料交叉核對,未做主觀評分;綜合智能指數引用 Artificial Analysis / ModelBeats 口徑。因模型迭代快,具體數字以官方最新頁面為準。

 17802032796

 iThome鐵人賽
 看影片追技術