
大表 join 小表時,我很容易直覺認為:「小表才幾千筆,直接 broadcast 就好了吧?」但 Spark 有時還是選擇 shuffle join。這時要調高門檻、加一個 hint,還是交給 AQE?如果 broadcast 等太久,是不是把等待時間拉長就能解決?
Ep24 已經看過兩種 join 如何搬資料。這次往前多問一步:Spark 怎麼知道一張表夠小?再往後想一步:即使 Spark 願意 broadcast,Driver 和 Executors 真的裝得下嗎?
這篇用同一份資料跑四個對照,把自動門檻、hint 與 AQE 的角色分開,也整理我在實務上會怎麼選擇起點。
Ep24:broadcast join 與 shuffle join 如何移動資料?
        ↓
Ep27:shuffle 工作切多細,再由 AQE 怎麼合併?
        ↓
Ep28:少數 task 暫時落後,值得多跑一份嗎?
        ↓
Ep29:小表多小才適合 broadcast?門檻與等待時間怎麼想?
        ↓
Ep30:大量小檔案,怎麼安排進 scan tasks?
本篇聚焦 Spark SQL/DataFrame 的 broadcast join 決策,以 Spark 3.4.4 為準。實驗使用有等值條件的 inner join,不把所有 join 類型都套用同一個結論。
Sort-Merge Join 會讓兩側資料依 join key 重新分流,再排序、比對。Broadcast Hash Join 則選一側當 build side,也就是用來建立查找結構的那份資料,將它送到執行 join 的 Executors,讓另一側的各個 partition 就地查找。
準備較小的一側:先 filter、只留下 join 需要的欄位
        ↓
Executors 計算這側資料,Driver 收集結果
        ↓
Driver 建立供 join 查找的 relation
        ↓ BroadcastExchange
將 relation 廣播給需要的 Executors
        ↓
各個 Executor 用它比對自己處理的大表 partition
這樣通常能省下大表為了這個 join 進行 shuffle 的成本。不過 query 若還有 aggregation 或其他操作,後面依然可能需要 shuffle。
代價也很明確:Driver 要有空間收集資料、建立 relation;執行 join 的 Executors 也要能容納並使用這份 relation。這不是把小表拆散後,每個 Executor 只拿其中一小份。多個不同的 broadcast joins 或並行查詢,還可能讓多份 relation 同時占用記憶體。
所以「值得 broadcast」需要同時滿足兩個方向:省下的 shuffle 成本有意義,而且接住這份資料的程序有足夠餘裕。
只看 row count 很容易低估大小。同樣兩千筆資料,只有整數 key,和帶著長字串、陣列或巢狀欄位,成本可以差很多。磁碟上的 Parquet 又可能經過壓縮,檔案大小也無法直接代表記憶體需求。
| 大小從哪裡來 | 它描述什麼 | 我會拿它回答什麼問題 |
|---|---|---|
optimizer 的 sizeInBytes |
規劃時依可取得的統計資訊估算 relation 大小。 | Spark 為什麼一開始願意或不願意自動 broadcast? |
| 執行期 shuffle 統計 | 實際產生的 shuffle 輸出大小。 | AQE 得到新資訊後,有沒有機會改變策略? |
BroadcastExchange 的 data size |
執行時建立的 broadcast relation 大小指標。 | 這次真正建立了多大的查找資料結構? |
| process 的記憶體用量 | 包含 relation、暫存資料、其他運算與 JVM 等成本。 | Driver/Executor 是否還有足夠空間? |
這些量也不等於網路實際傳送的 bytes。序列化、壓縮與資料結構都會改變數字;不能把某一個大小欄位直接當成整個 process 的記憶體預算。
規劃時的估算還取決於資料來源與統計資訊。遇到「這張表明明很小,Spark 卻不這麼想」時,我會先看 filter、欄位裁剪是否進入計畫,以及估算是否合理;使用 catalog table 時,再依資料來源確認是否需要更新表或欄位統計。
估算大小可以先從程式看,不必等 job 跑完。在本次實驗建立 dimension 後,對準備拿去 join、已完成 filter 與欄位選取的 DataFrame 執行:
dimension.explain(mode="cost")
找輸出的 Optimized Logical Plan,留意各節點旁的 Statistics(sizeInBytes=...)。本次小表的 32,000 bytes 換成這種格式約為 31.3 KiB。同一份計畫可能有多個估算,要對照小表進入 join 前的節點,別拿原始 scan 或最後 aggregation 的大小來比較。
explain 只顯示計畫,不會為了這次查看而執行完整查詢。拿不到可靠統計時,顯示的仍可能是粗略估算,不能當成實測大小。
本次程式為了精確列出 bytes,另外透過 JVM 內部介面讀值:
estimated_bytes = (
    dimension._jdf.queryExecution().optimizedPlan().stats().sizeInBytes()
)
print(f"Dimension estimated size: {estimated_bytes} bytes")
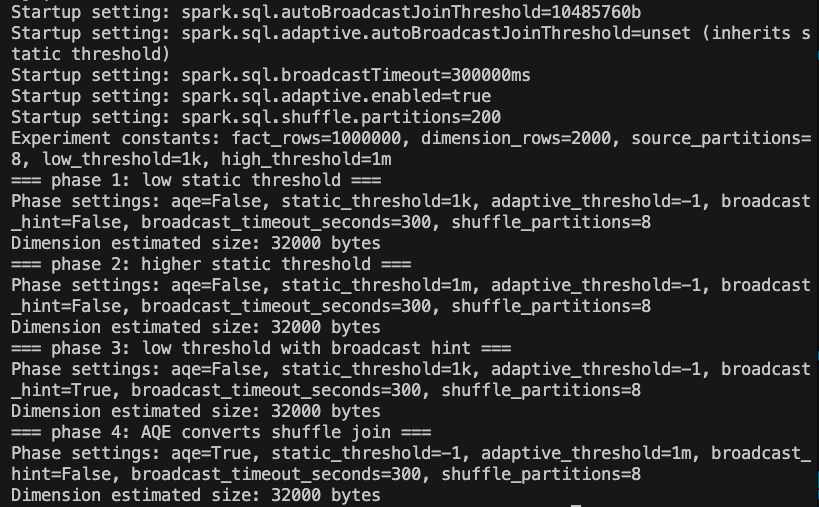
這就是終端機中 Dimension estimated size: 32000 bytes 的來源。_jdf 屬於內部介面,日常排查優先使用公開的 explain(mode="cost")。
等 action 完成後,再從執行結果找實際數字:
| 要找的資訊 | 具體操作位置 | 閱讀時注意什麼 |
|---|---|---|
| broadcast relation 大小與耗時 | Spark UI → SQL / DataFrame → 點進該次查詢,在圖中找 BroadcastExchange。 |
看 data size、number of output rows、time to collect、time to build、time to broadcast;這些是執行指標。 |
| 已產生的 shuffle 資料量 | 同一張 SQL 計畫圖,找 join 上游的 shuffle Exchange,看 shuffle bytes written;也可從關聯 Job 進 Stage details 看 Shuffle Write/Read。 |
query 可能有多個 Exchanges,要分清 join 與後續 aggregation。Stage 的 bytes 可協助對照資料路徑,不要當成 broadcast relation 大小。 |
| AQE 最後選了哪種 join | 查詢 Details 的計畫內容,或在同一個結果 DataFrame 完成 action 後呼叫 result.explain(mode="formatted")。 |
對照 Initial/Final Plan,確認 SortMergeJoin 是否變成 BroadcastHashJoin;不要只看執行前的計畫。 |
| Driver/Executor 記憶體是否吃緊 | 配合平台的程序/container 記憶體監控、JVM heap/GC 指標與 Driver/Executor logs。 | Executors 頁的 Storage Memory 主要描述儲存區塊用量,不能當成整個 process 的記憶體用量。 |
若不確定 SQL 頁哪一筆對應自己的工作,可以先從 Jobs 頁的工作描述點進 Job,再透過關聯 SQL Query 連結找到查詢。本次四個 phases 都有各自的描述。
所以我的查看順序是:執行前用 cost plan 理解估算,執行後用 SQL metrics 確認資料結構與路徑,再用程序監控評估記憶體餘裕。 SQL UI 的計畫細節未必完整列出 optimizer 統計,查估算時以 explain(mode="cost") 為起點最直接。
以下是 Apache Spark 3.4.4 的預設值;平台可能覆寫設定,使用前仍要確認 application 的有效值。
| 設定 | 預設值 | 白話來說 |
|---|---|---|
spark.sql.autoBroadcastJoinThreshold |
10485760 bytes,亦即 10 MiB |
規劃時自動選擇 broadcast 的大小門檻,依估算與 join 條件判斷。設為 -1 可停用這條自動選擇路徑。 |
spark.sql.adaptive.enabled |
true |
AQE 總開關,讓 Spark 能依執行期資訊調整計畫。 |
spark.sql.adaptive.autoBroadcastJoinThreshold |
未設定;沿用上面的自動門檻 | AQE 使用執行期統計時的 broadcast 門檻。可另外設定,-1 表示停用 AQE 的自動 broadcast 選擇。 |
spark.sql.broadcastTimeout |
300 秒 |
等待 broadcast exchange 完成的時間。 |
spark.sql.shuffle.partitions |
200 |
join、aggregation 等 shuffle 的預設 partition 數;這次實驗固定改成 8,方便比較。 |
自動門檻只決定 Spark 是否考慮這條路徑,並不預留記憶體,也不限制最後的 relation 一定小於門檻。設成 -1 時,也要留意另一條 AQE 門檻是否另有設定,以及 query 是否帶有 hint。
這裡的 auto 指「自動選擇 broadcast」,不專指 AQE。一般門檻在初始規劃時就能依估算生效,即使 AQE 關閉也能使用;adaptive 門檻才是讓 AQE 在執行途中依實際統計重新判斷。若沒有另外設定 adaptive 門檻,調整一般門檻也會連帶影響 AQE,因為後者預設沿用前者。
broadcast hint 是針對 query 表達策略偏好。 本次使用 PySpark 的 broadcast(dimension),讓 Spark 即使估算超過自動門檻,也優先考慮廣播這一側。hint 不是數值設定,沒有對應的預設門檻;沒有加 hint 時,就交由規劃器判斷。它仍受 join 類型支援限制,也不會替我確認資料一定裝得下。
AQE 則多了一次重新判斷的機會:最初可能安排 Sort-Merge Join,等 shuffle 產生實際統計後,發現一側夠小,再轉成 Broadcast Hash Join。這能省去後續部分工作,但已經寫出的 shuffle 不會因此消失。
自動門檻決定何時考慮 broadcast,hint 表達這次 query 的偏好,AQE 用執行期資訊重新判斷。三者都需要 Driver 和 Executors 真正有空間接住資料。
我會先保留 10 MiB 的自動門檻、300 秒等待時間,以及預設開啟的 AQE。這是一個可回退的起點,並不保證適合所有 workload。
接著依序確認:
data size 就當成安全餘額。全域調高門檻會影響其他 joins,hint 則可能在小表成長後仍持續要求 broadcast。兩者都需要後續追蹤,沒有「設一次就永遠安全」的數字。
要先找時間花在哪裡。BroadcastExchange 會列出收集資料、建立 relation 與廣播的耗時;上游計算慢、Driver GC 或傳輸問題,都可能讓等待變長。
若確認 relation 大小合理、資源足夠,只是正常的上游計算確實需要更久,才值得測試比預設 300 秒更長的等待。若是資料太大或已經 OOM,增加 timeout 不會讓資料縮小,也不能保證逾時後自動改回 Sort-Merge Join。
這次實驗沒有刻意製造 timeout 或 OOM;我們用成功執行的四個案例,驗證策略怎麼改變。
環境是兩個 Standalone Executors,各有 2 cores、512 MiB heap,共四個 task slots。資料由程式產生:大表 1,000,000 筆、小表 2,000 筆,各有八個 source partitions,以均勻的 product_id 做 inner join。
小表帶著 64 字元的 SHA-256 字串欄位 segment。最後除了計算筆數與大表欄位加總,也加總 segment 的長度,讓查詢真的需要這個欄位,避免只做 count 時被 optimizer 裁掉。
| Phase | AQE | 規劃時門檻 | AQE 門檻 | broadcast hint | 初始 → 最終 join |
|---|---|---|---|---|---|
| 1:低門檻 | 關 | 1k |
-1 |
無 | SMJ → SMJ |
| 2:提高門檻 | 關 | 1m |
-1 |
無 | BHJ → BHJ |
| 3:低門檻加 hint | 關 | 1k |
-1 |
有 | BHJ → BHJ |
| 4:交給 AQE | 開 | -1 |
1m |
無 | SMJ → BHJ |
SMJ 是 Sort-Merge Join,BHJ 是 Broadcast Hash Join。這裡的 1k、1m 分別代表 1 KiB、1 MiB,刻意比預設 10 MiB 小,用來讓同一份小表跨過門檻;不是 production 建議值。四次的 timeout 都保留 300 秒。
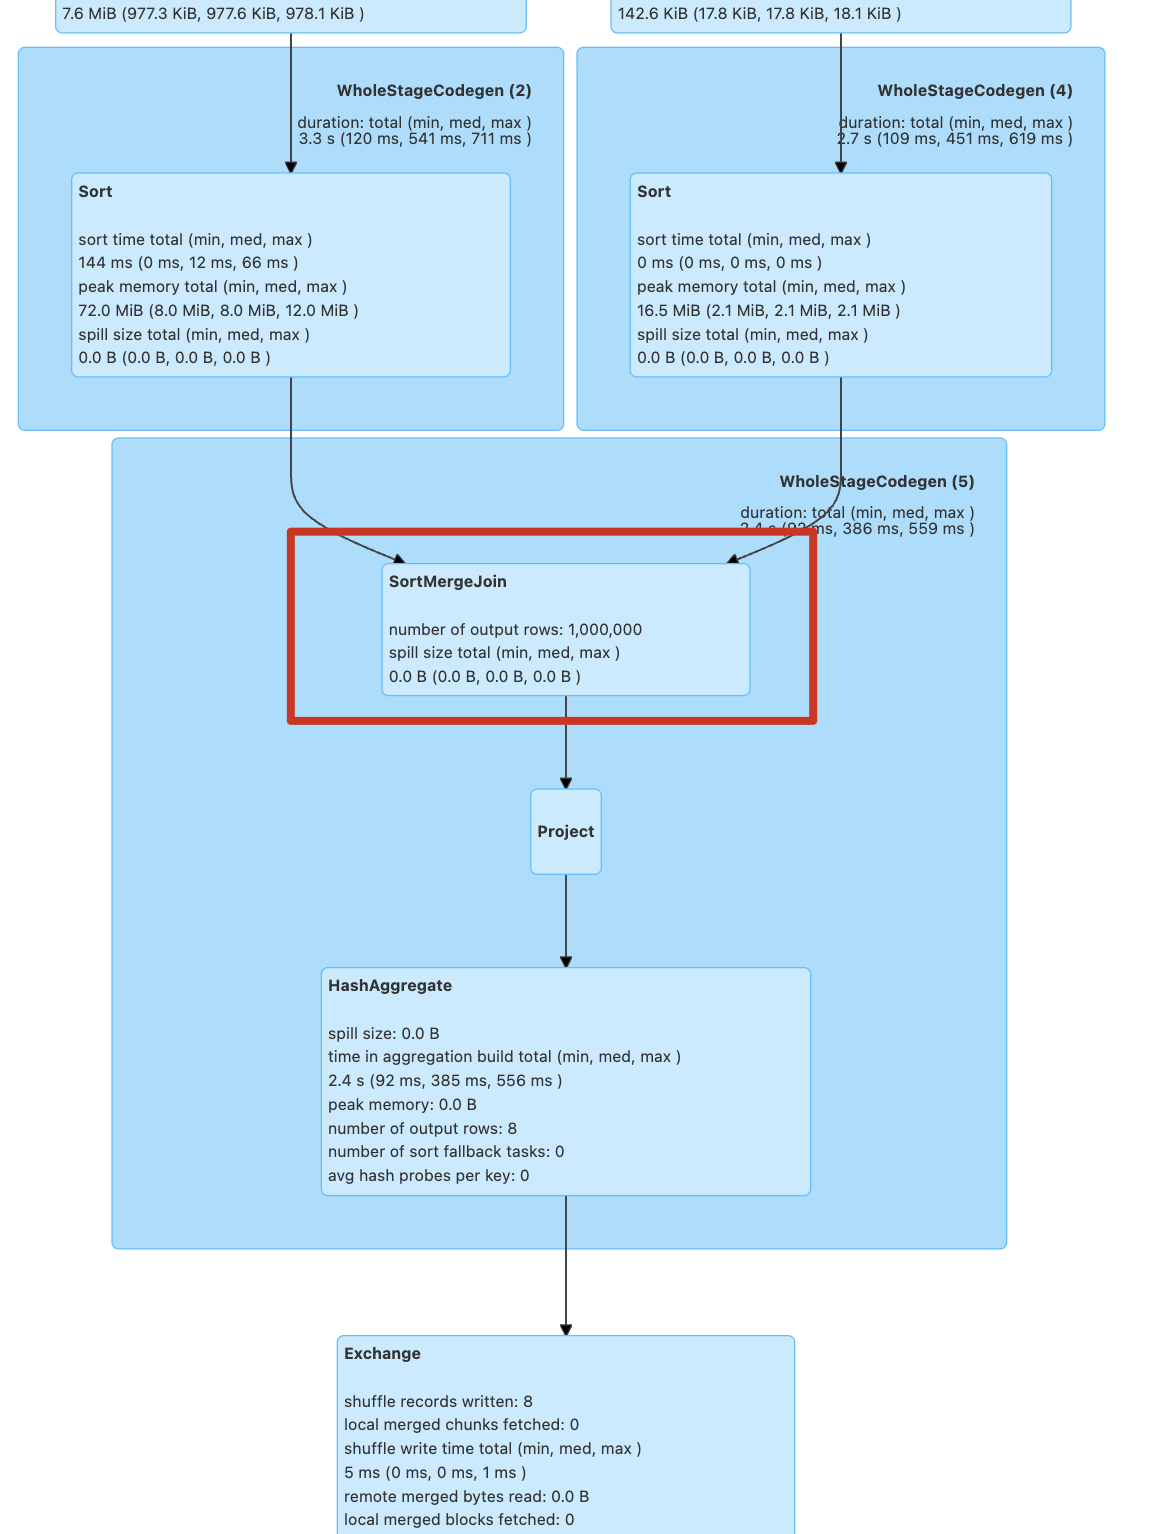
小表的估算大小是 32,000 bytes。Phase 1 的 1 KiB 門檻容不下這個估算,因此這次採用 Sort-Merge Join,圖中能看到兩側排序後再 join。
Phase 2 只把規劃時門檻提高到 1 MiB,估算落在門檻內,Spark 一開始就選擇 Broadcast Hash Join。右側 BroadcastExchange 顯示收集耗時 343 ms、建立 21 ms、廣播 6 ms,小表輸出 2,000 筆。
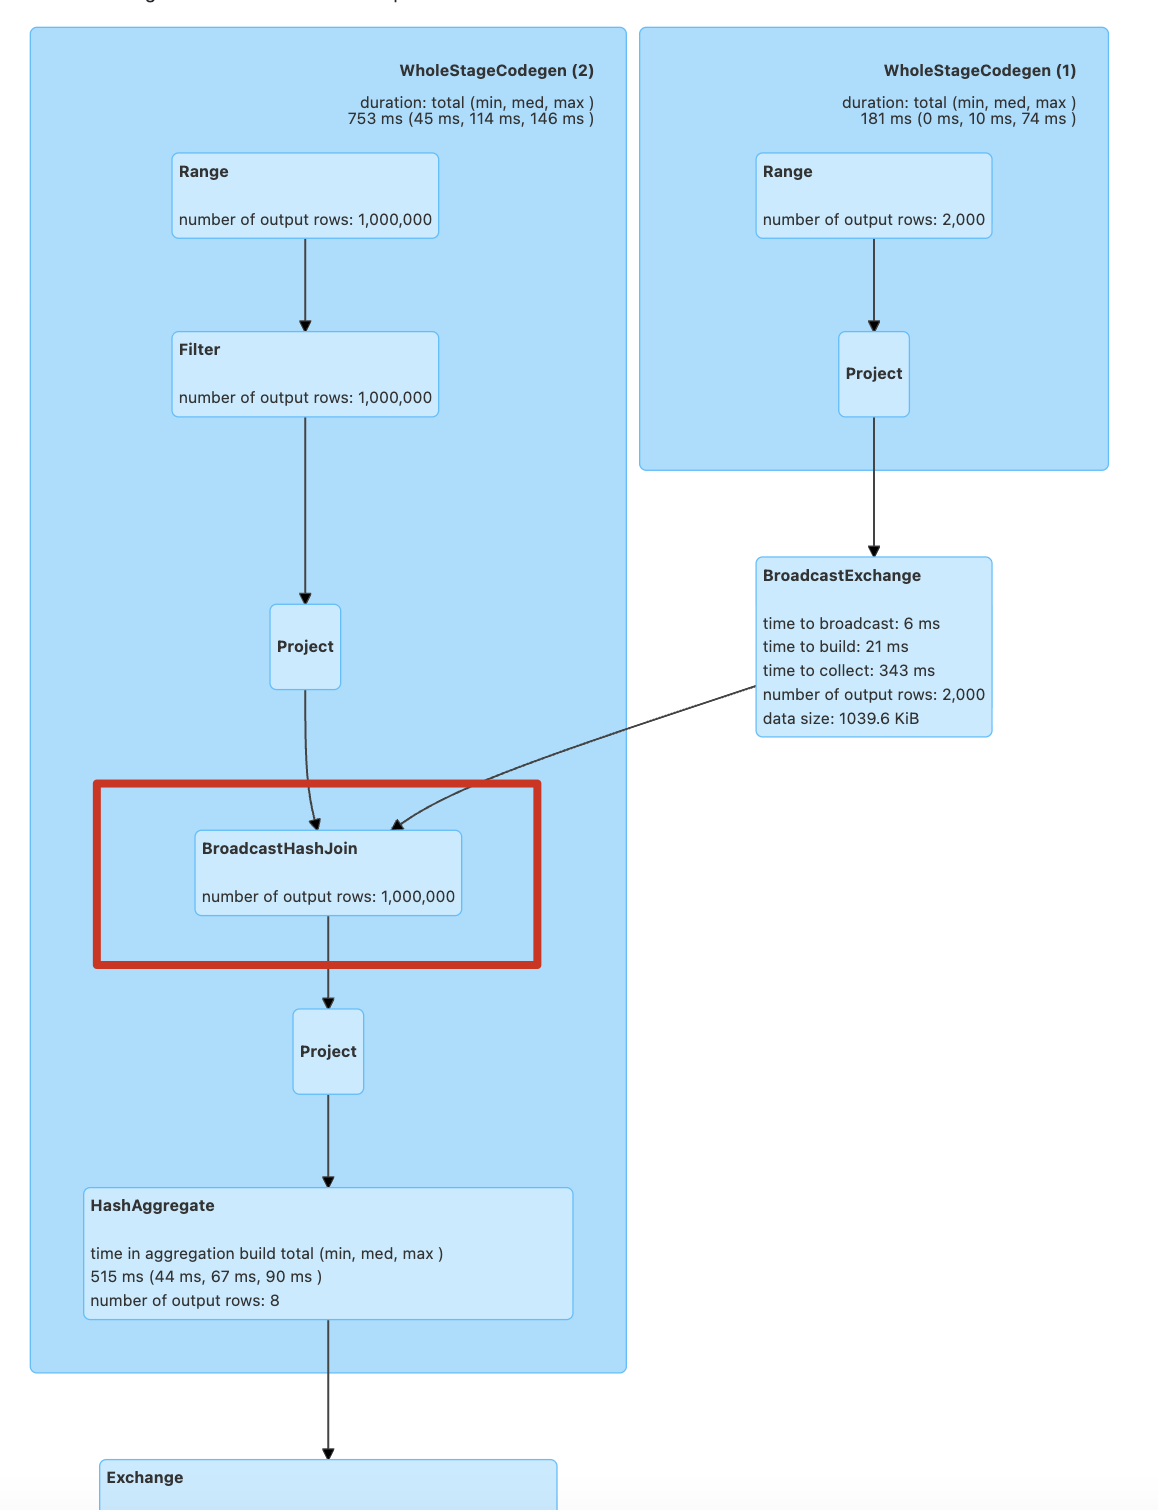
這裡最值得停一下的是 data size: 1039.6 KiB:它已經略大於設定的 1 MiB 門檻,卻成功完成 broadcast。原因在於選擇策略時比較的是估算,而這個 metric 描述執行時建立的 relation,兩者的計算方式不同。這也不是說 process 的總記憶體只用了這麼多。
Phase 3 把門檻降回 1 KiB,但加上 broadcast hint,初始計畫依然採用 Broadcast Hash Join。這次驗證的是 hint 能越過自動門檻;它沒有消除建立與傳送小表的成本。
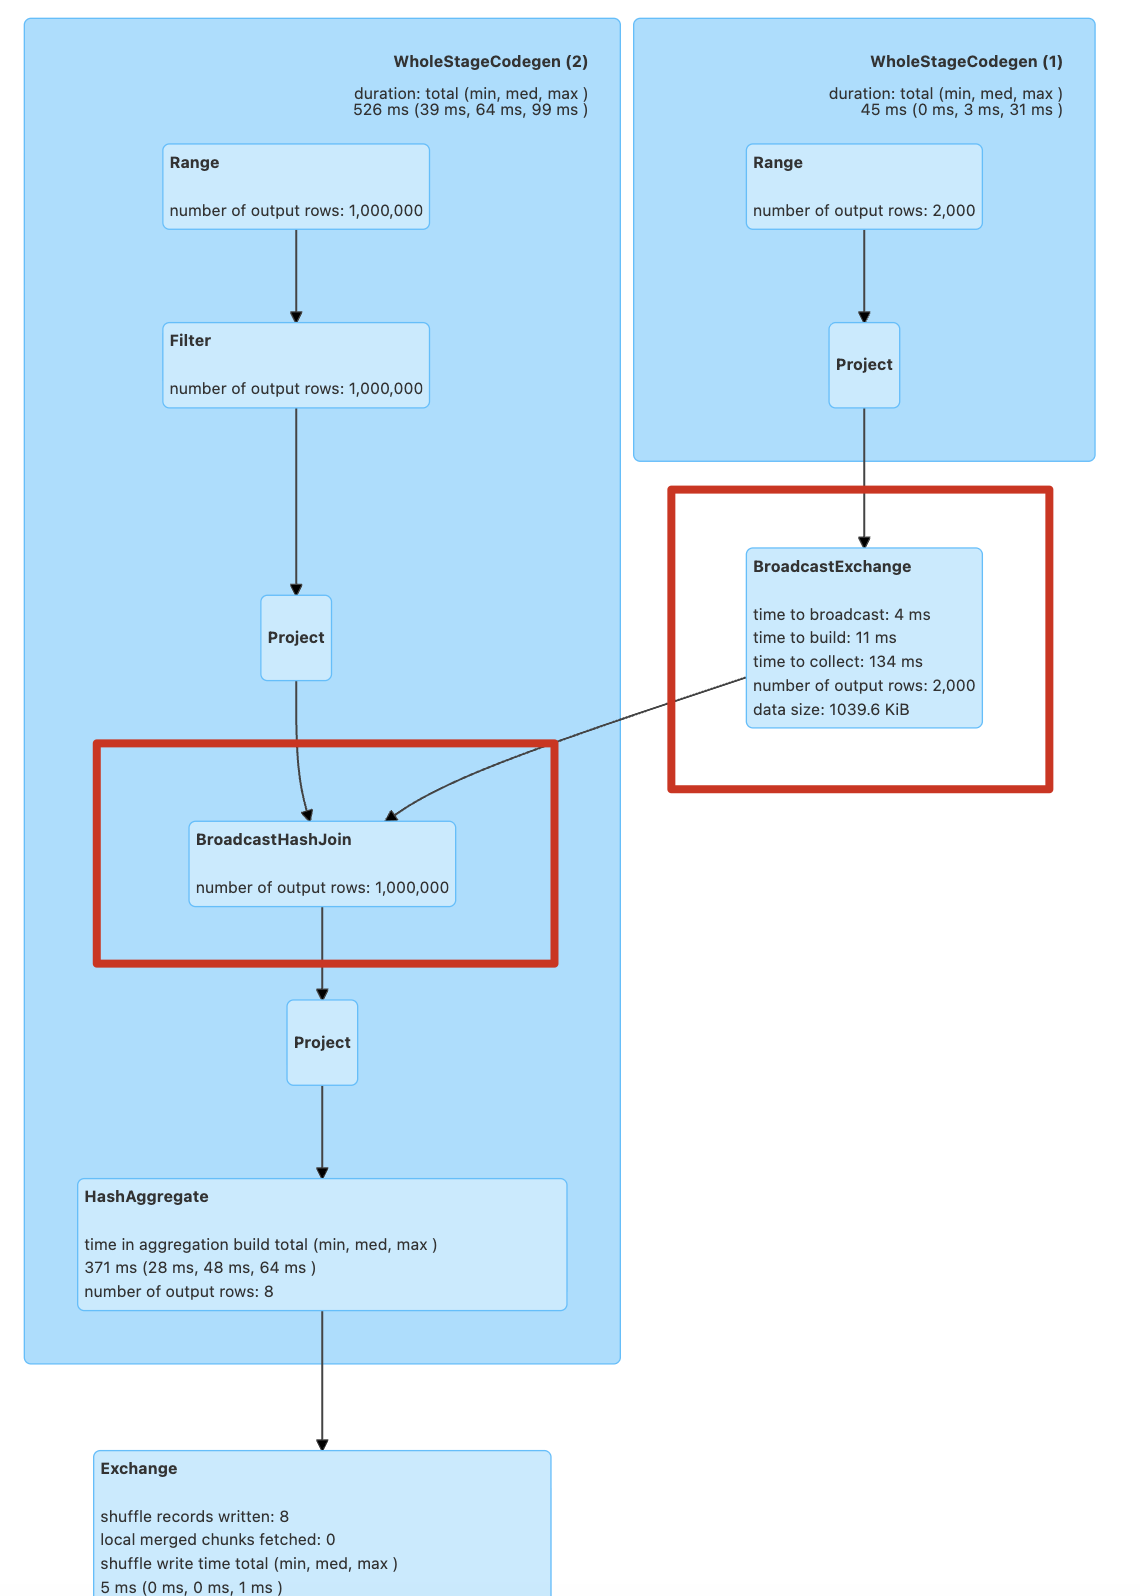
Phase 4 停用規劃時的自動 broadcast,另將 AQE 門檻設成 1 MiB。程式記錄的初始策略是 Sort-Merge Join,執行後變成 Broadcast Hash Join。
圖中還能看到兩側的 AQEShuffleRead,以及 build side 後面的 BroadcastExchange。這條路徑說明:Spark 先做出 shuffle,再根據執行期資訊改變 join,最後仍要收集並廣播小表。
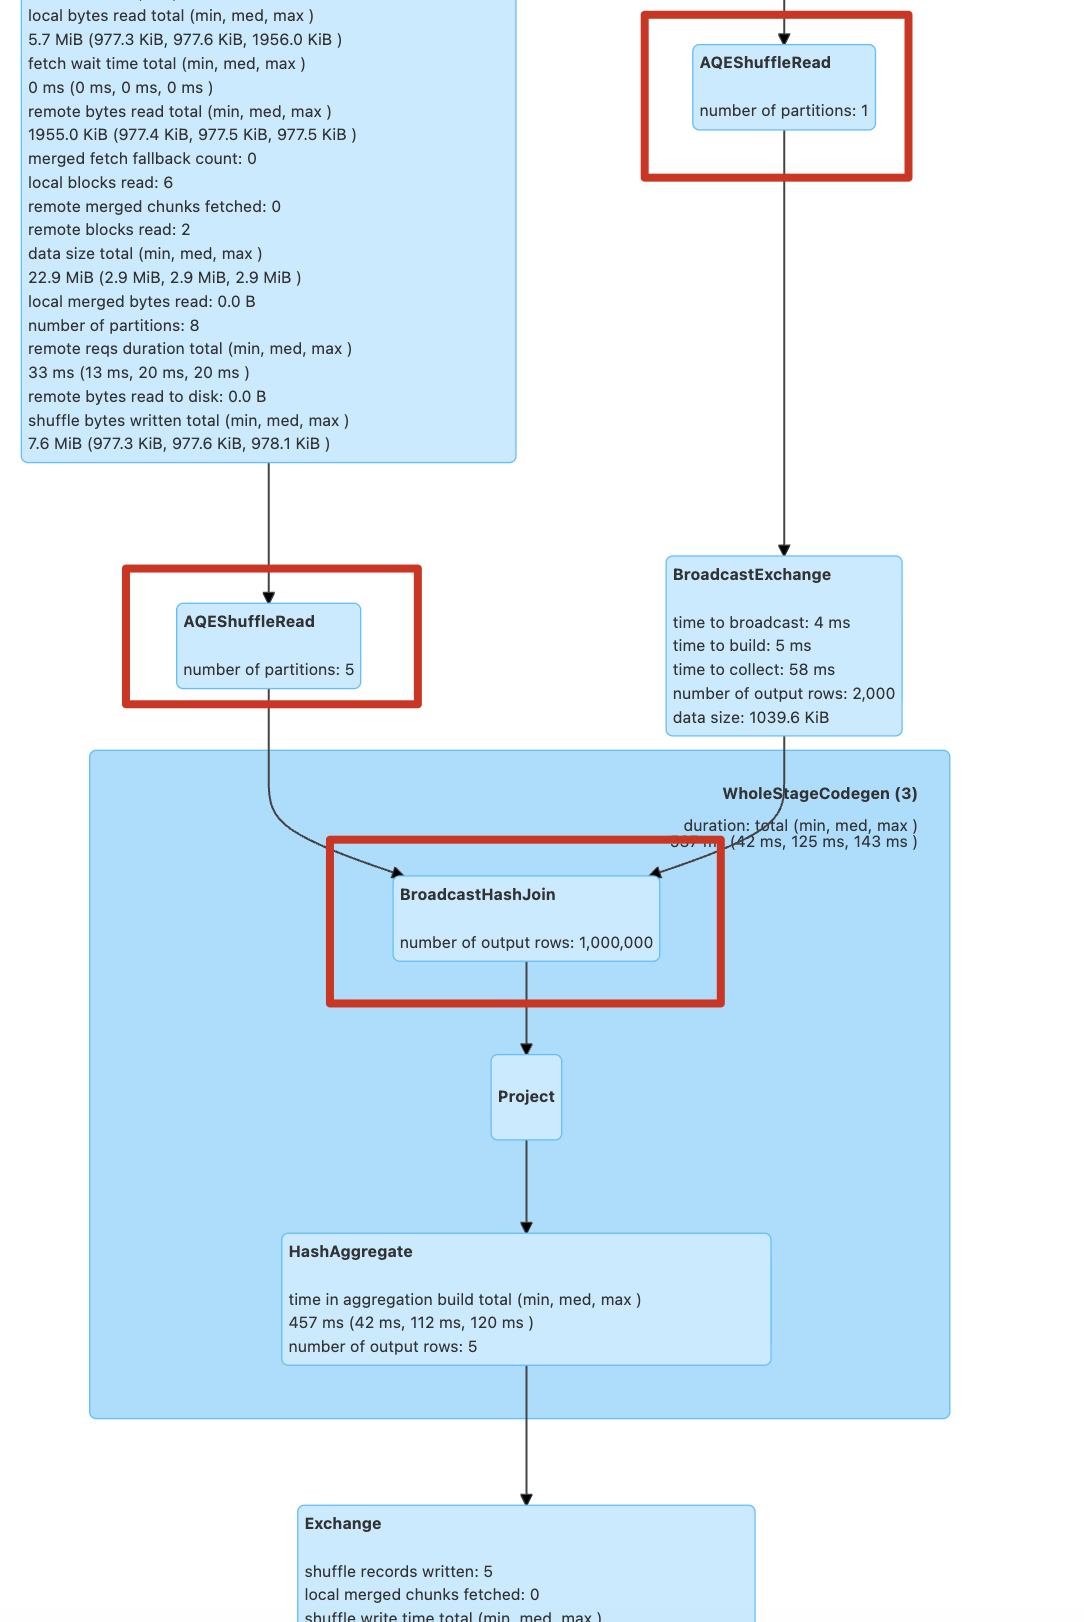
AQE 增加了調整彈性,但若一開始就有準確資訊、能安全選用 broadcast,通常更有機會省下原本可避免的 shuffle。實際是否轉換,仍受 join 條件、執行期統計與其他規劃規則影響。
四個 phases 的結果都是 joined_rows=1000000、event_sum=47999055、segment_chars=64000000,初始與最終策略也符合各次設定。
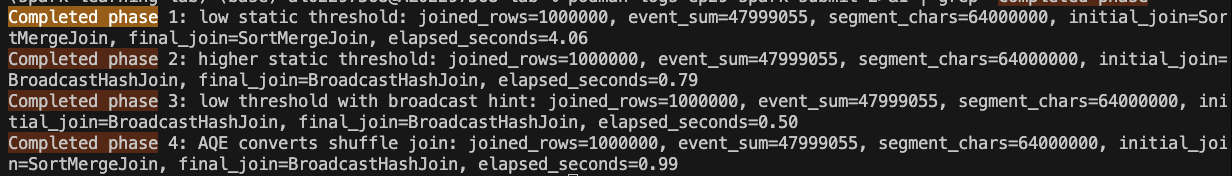
這些是連續執行的小型對照,第一個 phase 還包含啟動與暖機成本,因此不把耗時差異解讀成加速比例。這次確認的是設定如何改變資料處理路徑。
這次我學到,「這張表很小」需要補上大小的來源。規劃時估算 32,000 bytes,執行時建立的 broadcast relation 卻是 1,039.6 KiB;兩個數字各自有用,也都無法單獨回答 Driver 和 Executors 是否安全。
我也把幾個開關的角色分清楚了:門檻讓 Spark 自動考慮 broadcast,hint 表達特定 query 的偏好,AQE 則等實際統計出來再調整。timeout 留給它完成工作的時間,並不改變這份工作的大小。
實務上,我會先 filter、裁剪欄位、確認估算與實際 relation,再檢查記憶體和並行工作。從預設值出發,有證據才局部調整,比先把門檻與等待時間一起拉高,更容易知道自己解決了哪個問題。
下一篇回到讀檔:如果資料分散在大量小檔案裡,Spark 要怎麼把它們安排進 scan tasks?調整每個 task 的讀取份量,和真的把小檔案合併起來,又有什麼差別?
🚀 GitHub:
Ep29|小表要多小,才值得送到每個 Executor?聊聊 Spark broadcast
🚀 spark-learning-lab 系列文章與實作:
https://github.com/jeffery5bai/spark-learning-lab
Apache Spark 3.4.4 — SQL Performance Tuning(broadcast 門檻、timeout、join hints 與 AQE):
https://archive.apache.org/dist/spark/docs/3.4.4/sql-performance-tuning.html

 jeffery5bai

 iThome鐵人賽
 看影片追技術