
Ep25 看過小檔案帶來的麻煩:資料總量不大,Spark 卻忙著啟動一堆短 task。如果這些檔案暫時不能重寫,有沒有辦法讓一個 task 多讀幾個,少付一點啟動與排程成本?
可以,Spark 本來就有把讀檔工作打包的機制。它不會永遠讓「一個檔案等於一個 task」,而是根據檔案大小、開檔成本與期望平行度,安排每個 scan task 要讀哪些資料。
這篇固定同一批小檔案,調整三個讀取設定,再和真正合併檔案的結果比較。我想弄清楚的是:調設定能省下什麼,哪些成本仍然得回到資料 layout 處理?
Ep25:小檔案為什麼讓 Spark 忙著啟 task?
        ↓
Ep27:shuffle 工作切多細,再交給 AQE 合併?
Ep28:少數 task 暫時落後,要不要多跑一份?
Ep29:小表多小才適合 broadcast?
        ↓
Ep30:既有小檔案怎麼打包成讀取工作?
調整 read planning,並和實際合併檔案分開看
本篇以 Spark 3.4.4 的 Parquet 檔案掃描為例。不同資料來源、table format 與版本,可能有自己的規劃方式,套用前仍要確認實際計畫。
讀取一批檔案,大致會經過這條路:
列出檔案,依查詢條件選出需要讀取的部分
        ↓
取得檔案大小,考慮每次開檔的估算成本
        ↓
決定讀取工作的容量,必要時切分可分割的大檔
        ↓
把 file splits 打包成 scan partitions
        ↓
每個 scan partition 交給一個 task 處理
        ↓
tasks 依可用 task slots 分批執行
file split 是規劃中的一段檔案資料;小檔可以整個放進一份工作,可分割的大檔則可能拆成多段。scan partition 是最後交給 task 的讀取清單,可以包含來自多個檔案的 splits。
因此,一個 task 可以讀多個檔案,一個大檔也可能由多個 tasks 處理。task slots 決定同時能跑多少工作,和磁碟上有幾個檔案是不同的數字。
把多個小檔排給同一個 task,能減少部分 task 啟動與排程成本,但這些檔案仍存在,也仍要被列舉與開啟。真正減少檔案數,需要透過 compaction,也就是把資料重寫成較少的檔案。
以下預設值以 Apache Spark 3.4.4 為準。平台可能覆寫它們,使用前要看 application 的有效值。
| 設定 | 預設值 | 白話來說 |
|---|---|---|
spark.sql.files.maxPartitionBytes |
134217728 bytes,即 128 MiB |
檔案掃描規劃時,每份工作的容量上限。實際採用的容量可能更小,也不是 task 的 heap 上限。 |
spark.sql.files.openCostInBytes |
4194304 bytes,即 4 MiB |
把開檔耗時換算成「同樣時間大約能掃描多少 bytes」,用來估算打包成本。 |
spark.sql.files.minPartitionNum |
未設定;沿用 leaf-node 預設平行度,通常來自 SparkContext 的 default parallelism | 希望至少保有多少 scan partitions,是建議值,並不保證恰好切成指定數量。 |
這組設定作用在檔案讀取規劃。Ep27 談的 shuffle partition 與 AQE 合併,則是在下游資料重新分流後安排工作,兩者要分開看。
我原本容易只用「總檔案 bytes ÷ 128 MiB」猜 task 數。但 Spark 還把開檔成本算進去。這次 160 個小檔,實體大小約 11.1 MiB;若每個檔案的估算開檔成本是 4 MiB,規劃時就會再考慮約 160 × 4 = 640 MiB 的等價成本。
這 640 MiB 沒有真的被寫進檔案,也不代表 Executor 要多配置 640 MiB 記憶體。它只是讓 planner 知道:讀很多小檔,不能只計算資料 bytes。
Spark 3.4.4 在本次檔案掃描路徑中,會用下列關係決定容量:
估算總工作量 = 所有檔案大小總和 + 檔案數 × 開檔成本

每份讀取容量 = min(
    設定的容量上限,
    max(開檔成本, 估算總工作量 ÷ 期望 partition 數)
)
之後才依檔案大小排序、逐一打包 file splits。實際數量還受打包邊界影響,不能只靠一次除法推得精確的 task 數。
這也說明三個設定為什麼會互相影響。提高開檔成本,可能讓一個 task 少裝幾個檔案,也可能同時推高計算出的讀取容量;提高期望 partition 數,則可能讓容量縮小,保留更多工作份數。不能把任何一個設定簡化成「越大就一定越快」。
file packing 是在安排工作清單:每份資料有多大、開啟它要花多少成本,以及希望保留多少平行度,都會影響最後怎麼分工。
我會先保留 128 MiB 的容量上限、4 MiB 的開檔成本,讓最低 partition 數沿用環境預設,再確認瓶頸在哪裡。
| 工作現場的情況 | 我會先採取的方向 |
|---|---|
| scan tasks 很多、每個資料量很少,而且之前刻意調小過容量 | 先回到預設容量測試,觀察能否減少零碎工作;不急著把上限一路放大。 |
| scan tasks 太少、單份工作很重,cluster 還有閒置 slots | 測試較小容量或較高的期望 partition 數,確認吞吐量與單 task 壓力是否改善。 |
| 儲存系統開檔延遲高,多檔 task 明顯拖長 | 量測開檔與掃描成本,再測試開檔成本估算;提高它可能增加 tasks,要一起評估排程與儲存系統負載。 |
| 很長時間都花在列舉檔案、metadata 或大量開檔 | 優先改善 pruning、上游輸出與 compaction,讀取打包無法消除這些檔案。 |
測試時固定資料與 query,每次只改一個設定,再看 scan task 數、每個 task 的 Input、duration、timeline 與整體耗時。scan tasks 比 slots 多,原本就很常見;目標是讓工作份量合理,無須硬把兩個數字調成相等。
compaction 也有重寫資料的成本,應依查詢頻率、檔案成長速度與 table format 的維護方式安排。這次使用本機 Podman volume,沒有模擬 object storage 的開檔延遲,因此不能拿實驗耗時替遠端儲存校準成本。
實驗有兩個 Standalone Executors,各有 2 cores、512 MiB heap,共四個 task slots。資料是 160,000 筆 events,包含 id、value 與隨 id 改變的 64 字元字串 payload。
先寫成 160 個 Parquet 小檔,再將同一份資料重寫成 8 個檔案,作為 compaction 對照。五次都計算筆數、id 與 value 加總,以及 payload 長度加總,確保查詢需要實際讀取三個欄位。
| Phase | 檔案數 | 容量上限 | 開檔成本 | 期望 partition 數 | 實際 scan tasks |
|---|---|---|---|---|---|
| 1:刻意縮小容量 | 160 | 1m |
4m |
4 | 160 |
| 2:恢復預設容量 | 160 | 128m |
4m |
4 | 5 |
| 3:提高開檔成本 | 160 | 128m |
16m |
4 | 20 |
| 4:提高期望平行度 | 160 | 128m |
4m |
32 | 32 |
| 5:真正合併檔案 | 8 | 128m |
4m |
4 | 4 |
表中的 m 代表 MiB。Phase 2 是共同基準,Phase 1、3、4 分別只改一個讀取設定;Phase 5 保留 Phase 2 的設定,只改檔案 layout。
期望 partition 數是實驗明確設定的 4 或 32,並非宣稱預設值是 4。另將 spark.sql.adaptive.enabled 由 Spark 3.4.4 預設的 true 改成 false,只為維持後續彙總 Stage 的形狀,方便比較。
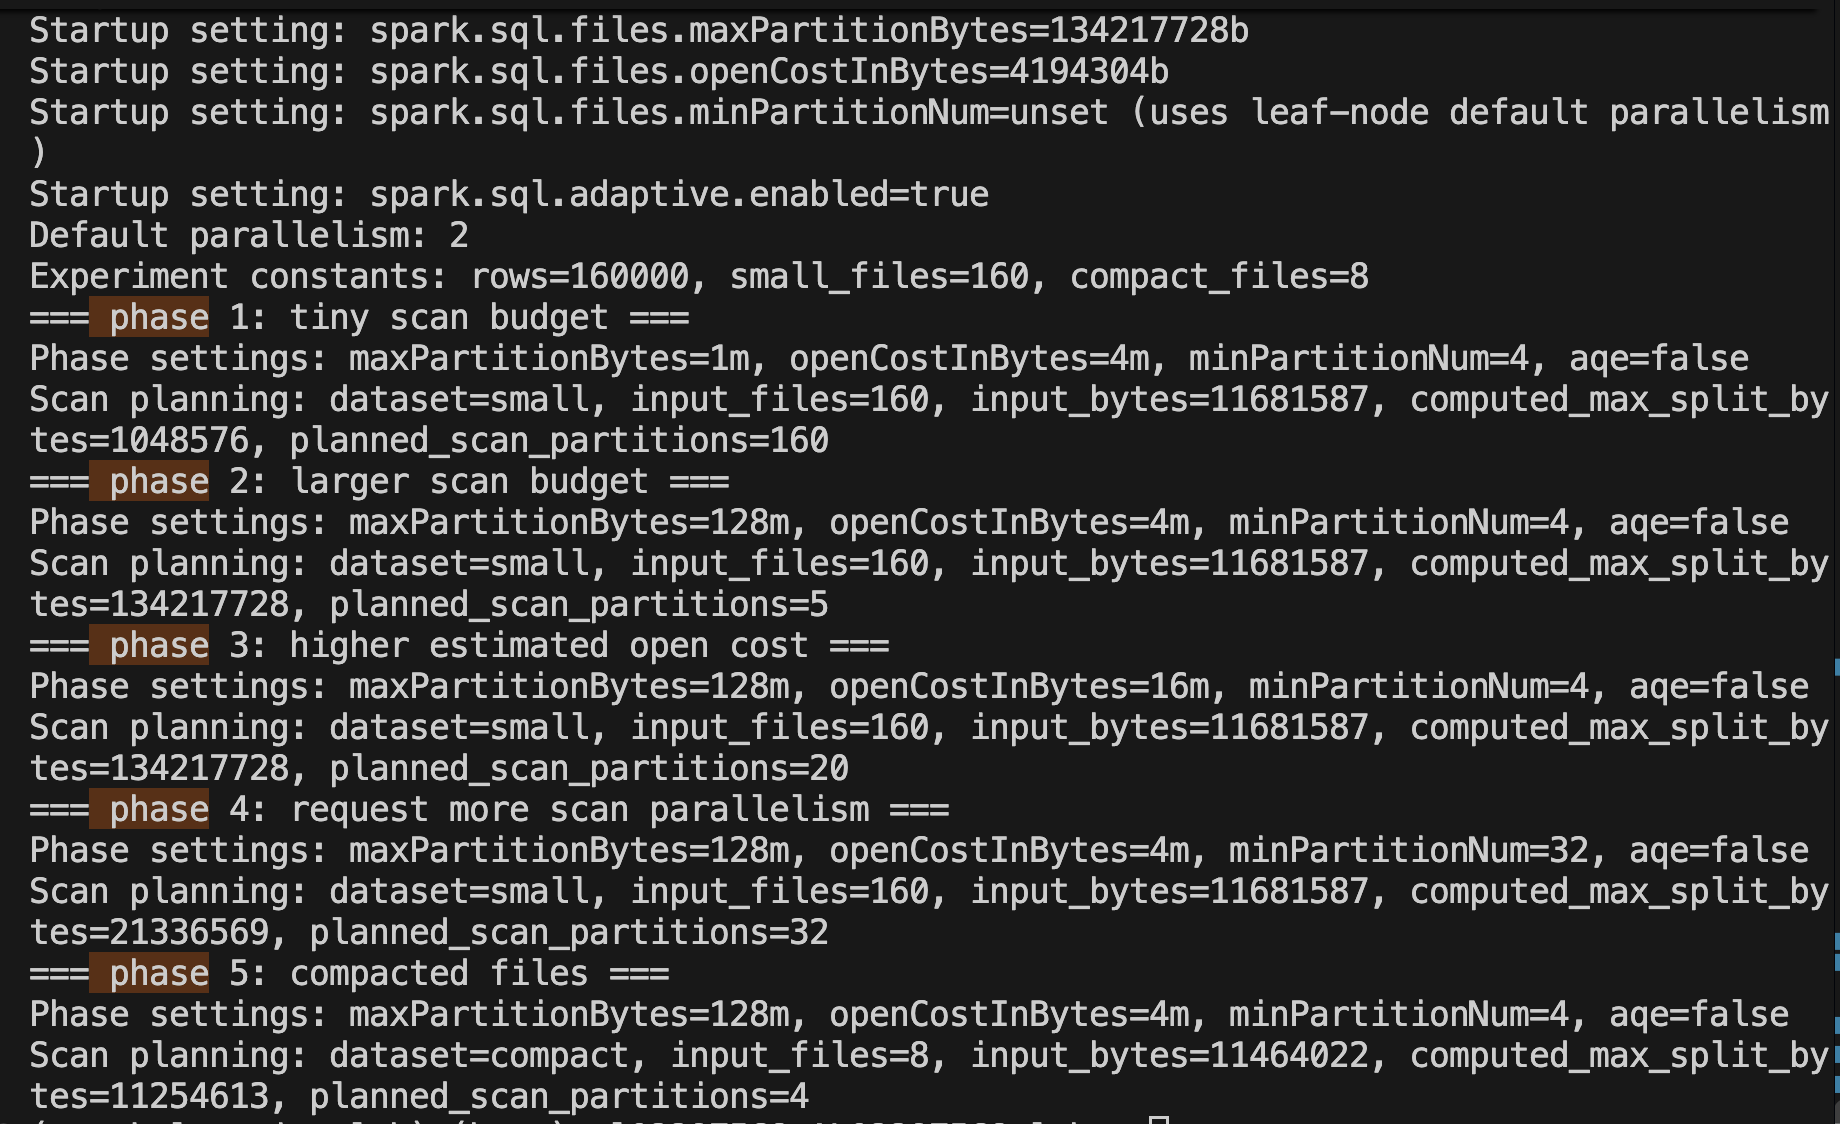
Phase 1 把容量上限刻意設成 1 MiB,比單檔的 4 MiB 開檔成本還小。這次每個小檔各自形成一份工作,Stage 0 有 160 個 scan tasks;後面的 Stage 1 只有一個 task,負責合併加總結果。
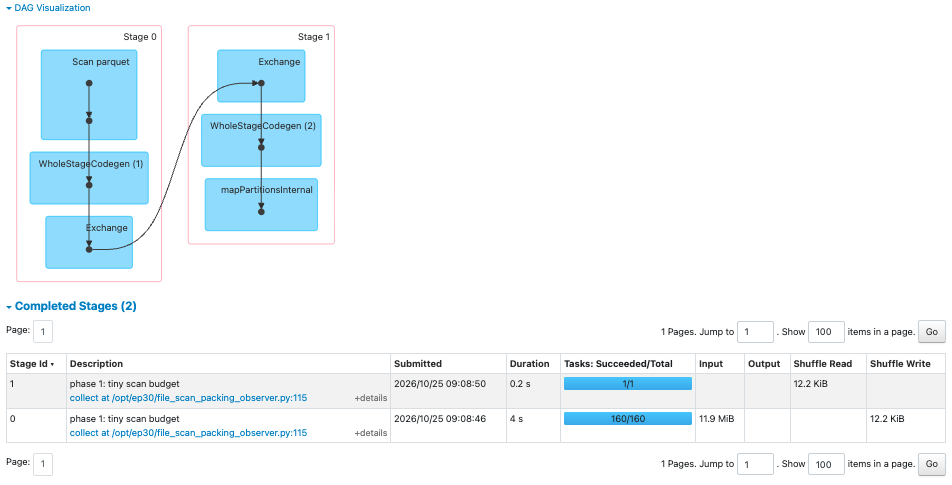
Phase 2 只把容量上限恢復成預設的 128 MiB,scan tasks 就變成 5 個。兩次 scan Stage 的 Input 都是約 11.9 MiB,讀的仍是同一批資料。
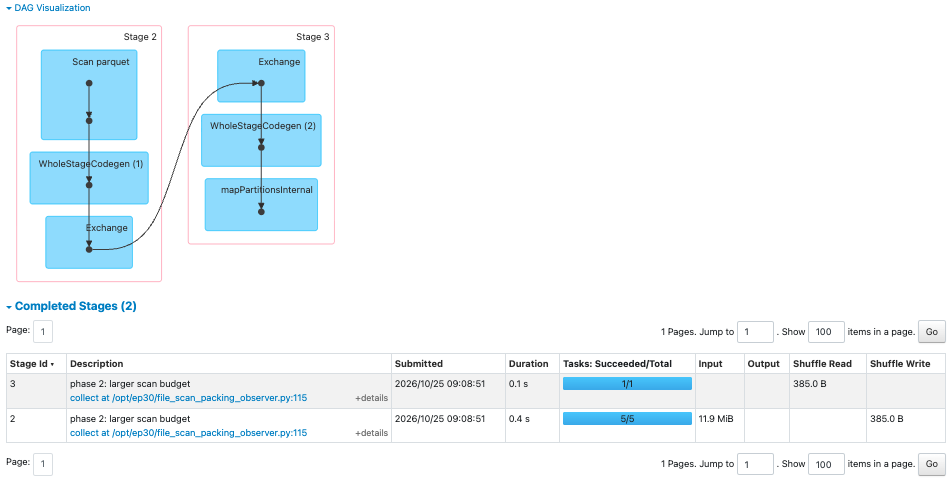
這個差異讓我看到:少啟動一些 tasks,不需要先改寫檔案。1 MiB 是為了重現零碎工作的刻意設定,不能當成 production 建議值。
Phase 3 相對 Phase 2,只把開檔成本從 4 MiB 提高到 16 MiB。在這組條件中,計算出的容量仍被 128 MiB 上限限制,但每個檔案占用的估算成本增加,所以 scan tasks 從 5 變成 20。
Phase 4 則保留 4 MiB 開檔成本,把期望 partition 數從 4 提高到 32。計算出的讀取容量降到約 20.3 MiB,最後形成 32 個 scan tasks。這次剛好得到 32,仍不代表這項設定保證精確切成指定數量。
兩個對照都在提醒我:task 數變多可能是規劃器對成本與平行度的回應,要回到有效設定與資料形狀解讀。
Phase 5 使用和 Phase 2 相同的讀取設定,改讀 8 個合併後的檔案,最後得到 4 個 scan tasks。SQL 頁的兩張圖能把差異說清楚。
Phase 2 雖然只用 5 個 scan tasks,Scan parquet 仍顯示讀取 160 個檔案,檔案大小約 11.1 MiB:
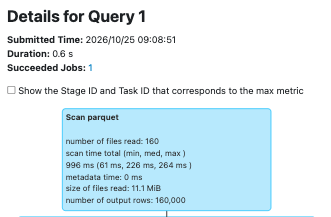
Phase 5 才真正降成 8 個檔案、約 10.9 MiB,同樣輸出 160,000 筆:
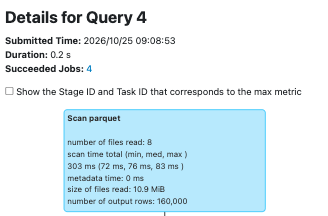
檔案大小略有變化,可能來自重寫後的壓縮與檔案結構;SQL 的檔案大小與 Stage 的 Input bytes 也有不同的統計口徑,不必期待完全相等。
五次結果皆為 160,000 筆,id_sum=12799920000、value_sum=7678825、payload_chars=10240000。這次是連續執行的小型實驗,包含啟動、暖機與可能的檔案系統快取影響,不把耗時差異換算成通用加速倍數。
把 160 個檔案交給 5 個 tasks,改變的是分工;把 160 個檔案重寫成 8 個,才真正改變了檔案 layout。兩種方法可以搭配,也各有自己的成本。
在本集程式中,events 是剛讀入 Parquet、尚未另外調整 partitions 的 DataFrame。可以在建立它後,確認有效設定、發現的檔案數與規劃出的 scan partitions:
print(spark.conf.get("spark.sql.files.maxPartitionBytes"))
print(spark.conf.get("spark.sql.files.openCostInBytes"))
print(spark.conf.get("spark.sql.files.minPartitionNum"))
print(f"Discovered files: {len(events.inputFiles())}")
print(f"Planned scan partitions: {events.rdd.getNumPartitions()}")
events.explain(mode="formatted")
這能查看讀取規劃,無須先用 count() 掃完整份資料。不過檔案列舉與 metadata 存取本身仍可能花時間。inputFiles() 是 DataFrame 提供的檔案清單,本次簡單 scan 可直接對照;複雜 query 若有 pruning,實際讀了哪些仍應以執行證據確認。
| 想確認的事情 | 操作位置 |
|---|---|
| 這次 query 真的讀了幾個檔案 | Spark UI → SQL / DataFrame → 該次查詢 → Scan parquet,看 number of files read、size of files read 與 number of output rows。 |
| 哪些 tasks 在讀檔 | Jobs → 對應 Job → Completed Stages,找 DAG 中含 Scan、且有 Input 的 Stage;本次最後的一個彙總 task 要另外計算。 |
| 工作是不是太碎或太重 | 點進 scan Stage details,比對 task 的 Input、duration 與 timeline;再結合可用 slots,觀察是否大量短工作分批等待。 |
調整設定後,重新建立讀取的 DataFrame 並執行相同 query,再比較這些證據。已建立的讀取計畫不應被當成一定會隨設定自動重建;同時也要確認沒有直接讀到之前的 cache。
這次我學到,小檔案數和 scan task 數之間,還隔著 Spark 的讀取規劃。同樣 160 個檔案,在不同容量、開檔成本與期望平行度下,可以形成 160、5、20 或 32 份工作。要判斷切得合不合理,需要一起看每份工作的成本與可用資源。
我也更清楚調設定的邊界。read packing 能減少部分排程成本,檔案仍然需要被找到、開啟與讀取;compaction 則付出重寫成本,真正減少之後要處理的檔案。遇到長期累積的小檔案問題,我會把讀取端的調整和上游資料 layout 一起規劃。
走到這一課,Ep27 到 Ep30 的共同方法也更清楚了:先理解 Spark 正在做什麼,再決定設定要改變哪一步,最後用計畫與執行結果確認。對我來說,比記住一組「最佳參數」更有用的,是能說明這次為什麼值得調、付出了什麼成本,以及什麼時候該回頭改資料或程式。
🚀 GitHub:
Ep30|小檔案很多,怎麼讓 Spark 少跑幾趟?聊聊 Spark 的讀檔分工
🚀 spark-learning-lab 系列文章與實作:
https://github.com/jeffery5bai/spark-learning-lab
Apache Spark 3.4.4 — SQL Performance Tuning(檔案讀取設定與預設值):
https://archive.apache.org/dist/spark/docs/3.4.4/sql-performance-tuning.html
Apache Spark 3.4.4 — FilePartition 原始碼(讀取容量計算與 file packing):
https://raw.githubusercontent.com/apache/spark/v3.4.4/sql/core/src/main/scala/org/apache/spark/sql/execution/datasources/FilePartition.scala

 jeffery5bai

 iThome鐵人賽
 看影片追技術