
一、前言
在前幾天的學習中,我已經完成個人健康習慣追蹤系統的基本功能,包括健康紀錄輸入、資料保存、歷史紀錄查詢、統計分析、圖表呈現與習慣完成率計算,也開始學習如何透過測試案例檢查程式是否正常運作。
然而,當系統逐漸累積更多健康紀錄時,資料保存與查詢的穩定性也會變得更加重要。
例如,使用者可能不小心重複新增同一天的紀錄,或是在讀取 CSV 時遇到格式錯誤。如果系統沒有妥善處理這些問題,就可能造成資料重複、統計結果不準確,甚至無法正常開啟網頁。
因此,今天將進一步改善資料保存與查詢功能,學習如何檢查檔案是否存在、避免重複紀錄、處理異常資料,並讓歷史紀錄的查詢更加方便。
二、學習目標
了解 CSV 資料保存的限制與常見問題。
使用 pathlib 管理資料檔案路徑。
使用 try...except 處理資料讀取與寫入錯誤。
建立重複日期檢查機制。
使用 Pandas 進行日期範圍查詢。
改善健康紀錄保存與查詢的穩定性。
三、認識資料保存的常見問題
目前系統使用 health_records.csv 保存健康紀錄。CSV 是一種常見的純文字表格格式,容易閱讀,也能透過 Pandas 進行資料分析。
不過,使用 CSV 保存資料時,仍然可能遇到一些問題。
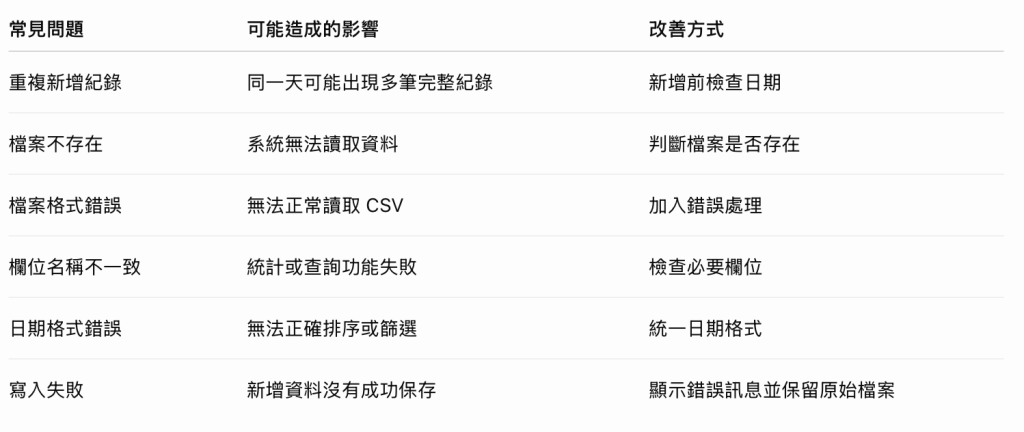
此外,CSV 不具備資料庫交易與多使用者同步控制等功能。如果未來系統需要支援大量資料、多人同時使用,或更複雜的修改與刪除操作,就可以考慮改用 SQLite 等資料庫。
四、使用 pathlib 管理資料檔案
在 Python 中,可以使用 pathlib 管理檔案路徑。
例如:
from pathlib import Path
FILE_PATH = Path("health_records.csv")
if FILE_PATH.exists():
print("健康紀錄檔案已存在。")
else:
print("目前尚無健康紀錄檔案。")
這段程式會先檢查 health_records.csv 是否存在,再決定後續的處理方式。
相較於直接假設檔案一定存在,先進行檢查可以避免讀取不存在的檔案時發生錯誤。
如果未來想將資料統一存放在專案中的 data 資料夾,也可以使用:
from pathlib import Path
DATA_DIR = Path("data")
DATA_DIR.mkdir(parents=True, exist_ok=True)
FILE_PATH = DATA_DIR / "health_records.csv"
print(FILE_PATH)
mkdir() 可以建立資料夾,而 exist_ok=True 表示如果資料夾已經存在,就不會因此產生錯誤。
但如果改變資料檔案的位置,既有功能也必須一起更新,否則系統可能會讀取到不同位置的檔案。
五、建立穩定的資料讀取與保存函式
為了避免在不同功能中重複撰寫讀取與保存程式碼,可以將這些操作整理成獨立的函式。
以下範例使用 Pandas 讀取 CSV,並在讀取失敗時提供清楚的錯誤訊息。
from pathlib import Path
import pandas as pd
FILE_PATH = Path("health_records.csv")
COLUMNS = [
"date",
"water_ml",
"sleep_hours",
"exercise_minutes",
"vegetables_fruits",
"notes"
]
def load_health_records():
if not FILE_PATH.exists():
return pd.DataFrame(columns=COLUMNS)
try:
    records = pd.read_csv(FILE_PATH)

    missing_columns = [
        column
        for column in COLUMNS
        if column not in records.columns
    ]

    if missing_columns:
        raise ValueError(
            "缺少必要欄位:" + ", ".join(missing_columns)
        )

    return records

except (OSError, pd.errors.ParserError, UnicodeDecodeError, ValueError) as error:
    raise RuntimeError(
        f"讀取健康紀錄失敗:{error}"
    ) from error
這個函式有幾個重點:
如果檔案不存在,就回傳具有正確欄位的空白資料表。
如果檔案存在,就嘗試讀取資料。
讀取後檢查必要欄位是否完整。
如果發生錯誤,就將原因整理成較容易理解的訊息。
這裡選擇在發生錯誤時明確回報,而不是默默回傳空白資料表,因為把真正的讀取錯誤當成「沒有資料」,可能讓使用者誤以為原本的紀錄全部消失。
接著,可以建立保存函式:
def save_health_records(records):
try:
records.to_csv(
FILE_PATH,
index=False,
encoding="utf-8-sig"
)
return True
except (OSError, ValueError) as error:
    raise RuntimeError(
        f"保存健康紀錄失敗:{error}"
    ) from error
to_csv() 會將資料表寫入 CSV 檔案。使用 index=False 可以避免將 Pandas 的索引額外保存成一個欄位,而 utf-8-sig 則有助於讓部分試算表軟體正確辨識中文編碼。
要注意,這個函式會寫入整份資料表,因此應該先確認傳入的資料正確,再呼叫保存函式。
六、避免重複新增同一天的健康紀錄
目前的系統可能允許同一天新增多筆完整健康紀錄,進而影響平均值、運動天數與完成率等統計。
如果本專案採用「每天只保存一筆完整健康紀錄」的規則,就可以在新增前檢查日期是否已存在。
def add_health_record(record):
records = load_health_records()
record_date = pd.to_datetime(
    record["date"],
    errors="coerce"
)

if pd.isna(record_date):
    raise ValueError("紀錄日期格式不正確。")

normalized_date = record_date.strftime("%Y-%m-%d")

existing_dates = pd.to_datetime(
    records["date"],
    errors="coerce"
).dt.strftime("%Y-%m-%d")

if existing_dates.eq(normalized_date).any():
    raise ValueError(
        "這個日期已經有健康紀錄,請先修改既有紀錄。"
    )

new_record = record.copy()
new_record["date"] = normalized_date

updated_records = pd.concat(
    [
        records,
        pd.DataFrame([new_record])
    ],
    ignore_index=True
)

save_health_records(updated_records)

return updated_records
這個函式會依序執行以下步驟:
讀取目前保存的健康紀錄。
檢查新增日期是否有效。
比對既有紀錄的日期。
如果日期已存在,就拒絕重複新增。
如果日期尚未存在,就加入新紀錄並保存。
需要注意,這個範例假設每一天只會有一筆完整紀錄。如果未來想記錄一天內多次喝水、不同運動時段,或多次睡眠紀錄,就應該重新設計資料結構,而不是單純限制日期只能出現一次。
另外,如果先前已經存在重複日期,這個函式不會自動刪除舊資料。若要整理舊資料,應先備份 CSV,再決定要保留哪一筆紀錄。
七、改善歷史紀錄查詢功能
除了保存資料之外,讓使用者能快速找到特定日期的紀錄,也是一項重要功能。
例如,使用者可能只想查看某一週的健康紀錄,而不是每次都瀏覽整份資料表。
以下範例示範如何利用 Streamlit 的日期選擇器與 Pandas 進行篩選。
import streamlit as st
import pandas as pd
st.title("健康紀錄查詢")
try:
records = load_health_records()
except RuntimeError as error:
st.error(str(error))
st.stop()
if records.empty:
st.info("目前尚無健康紀錄。")
st.stop()
records["date"] = pd.to_datetime(
records["date"],
errors="coerce"
)
records = records.dropna(subset=["date"])
if records.empty:
st.info("目前沒有有效的日期資料。")
st.stop()
min_date = records["date"].min().date()
max_date = records["date"].max().date()
start_date = st.date_input(
"開始日期",
value=min_date
)
end_date = st.date_input(
"結束日期",
value=max_date
)
if start_date > end_date:
st.error("開始日期不可晚於結束日期。")
else:
filtered_records = records[
records["date"].dt.date.between(
start_date,
end_date
)
].sort_values("date", ascending=False)
if filtered_records.empty:
    st.info("這個日期區間沒有健康紀錄。")
else:
    st.dataframe(
        filtered_records,
        use_container_width=True,
        hide_index=True
    )
這段程式會讓使用者選擇開始日期與結束日期,再顯示符合條件的紀錄。
其中,between() 可以檢查每筆日期是否位於指定範圍內,而 sort_values() 則可以將最新的紀錄排在前面。
透過日期範圍查詢,使用者就能更方便地查看某段期間的喝水量、睡眠時間與運動情況。
八、實際執行與測試
完成相關程式碼後,應該使用測試資料確認保存與查詢功能是否正常。
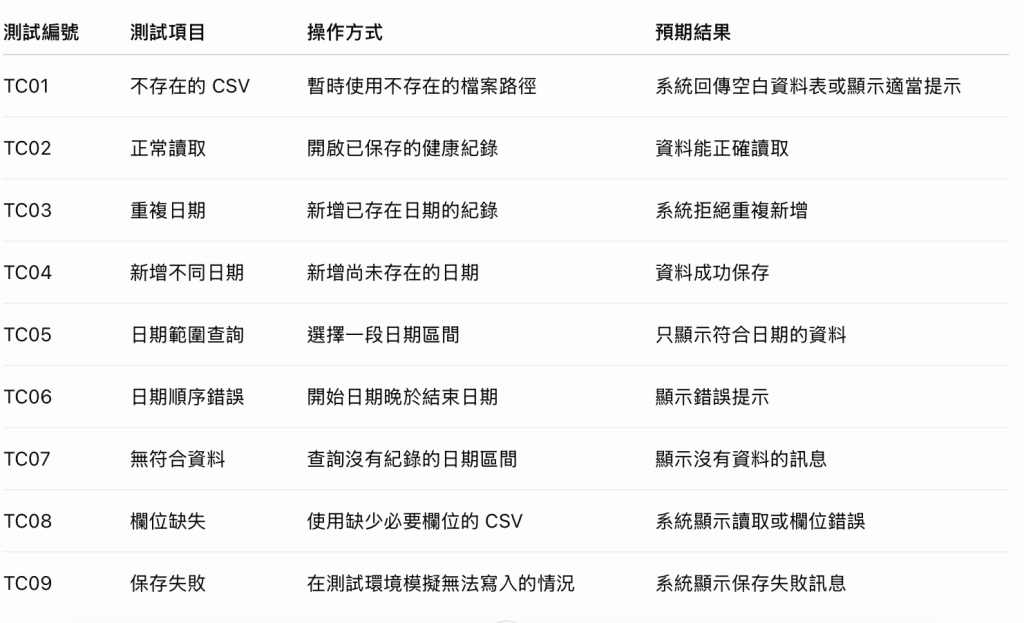
測試時,建議先備份原本的 health_records.csv,再使用另外建立的測試檔案進行新增、查詢與錯誤測試。
如果想將本日函式整合至既有的 app.py,必須注意不要直接把獨立範例全部貼在同一個檔案中,否則可能出現重複的匯入、頁面標題或表單。應將共用的讀取與保存函式集中管理,再由各個頁面呼叫。
九、今日成果與學習心得
今天完成了資料保存與查詢穩定性的改善規劃,學習使用 pathlib 管理檔案路徑,透過例外處理回報讀取與寫入錯誤,並建立日期檢查與範圍查詢功能。
透過這次學習,我了解到系統穩定性不只取決於程式能否執行,也取決於資料是否能正確保存,以及錯誤發生時系統能否清楚回應。
例如,避免重複日期可以降低統計失真的風險;日期範圍查詢可以提升使用便利性;讀取失敗時提供明確訊息,也能讓使用者知道問題可能出在哪裡。
同時,我也了解到 CSV 適合目前的小型學習專案,但隨著資料量與功能增加,可能需要更完整的資料管理方式。未來若要支援更複雜的資料修改、刪除與查詢,就可以考慮使用 SQLite,並為每筆紀錄設計獨立識別碼。
十、下一步學習方向
第二十五天的主題是「整合核心功能——完成健康習慣追蹤系統初版」。
下一階段將把目前學習過的健康紀錄輸入、資料保存、歷史查詢、資料管理、統計分析、圖表呈現與目標完成率整合起來,逐步建立一個可以實際操作的系統初版,並為後續的測試與成果展示做準備。

 corn0414

 iThome鐵人賽
 看影片追技術