
手上有 DOI,出版社的頁面卻要求登入,而你只是想看一下研究方法那一節。其實很多時候網路上就有合法的免費版本:作者所屬大學的典藏庫、預印本、PubMed Central。手動找的話要試四、五個網站;用程式找的話,只要依合理的順序呼叫幾個公開 API 就行。
下面的順序來自桌面應用程式 osFoundry 的 Paper 工作區裡的 View 按鈕,它的後端會依序嘗試每個來源,直到有一個回傳真正的 PDF 為止(論文寫作與研究工作區頁面有周邊的畫面)。範例使用兩個真實的 DOI,主題相同:手機放在桌上會不會影響專注力。
10.1037/tmb0000123,2024 年的統合分析(Hartanto et al.)10.1086/691462,被大量引用的 2017 年「Brain Drain」研究(Ward et al.)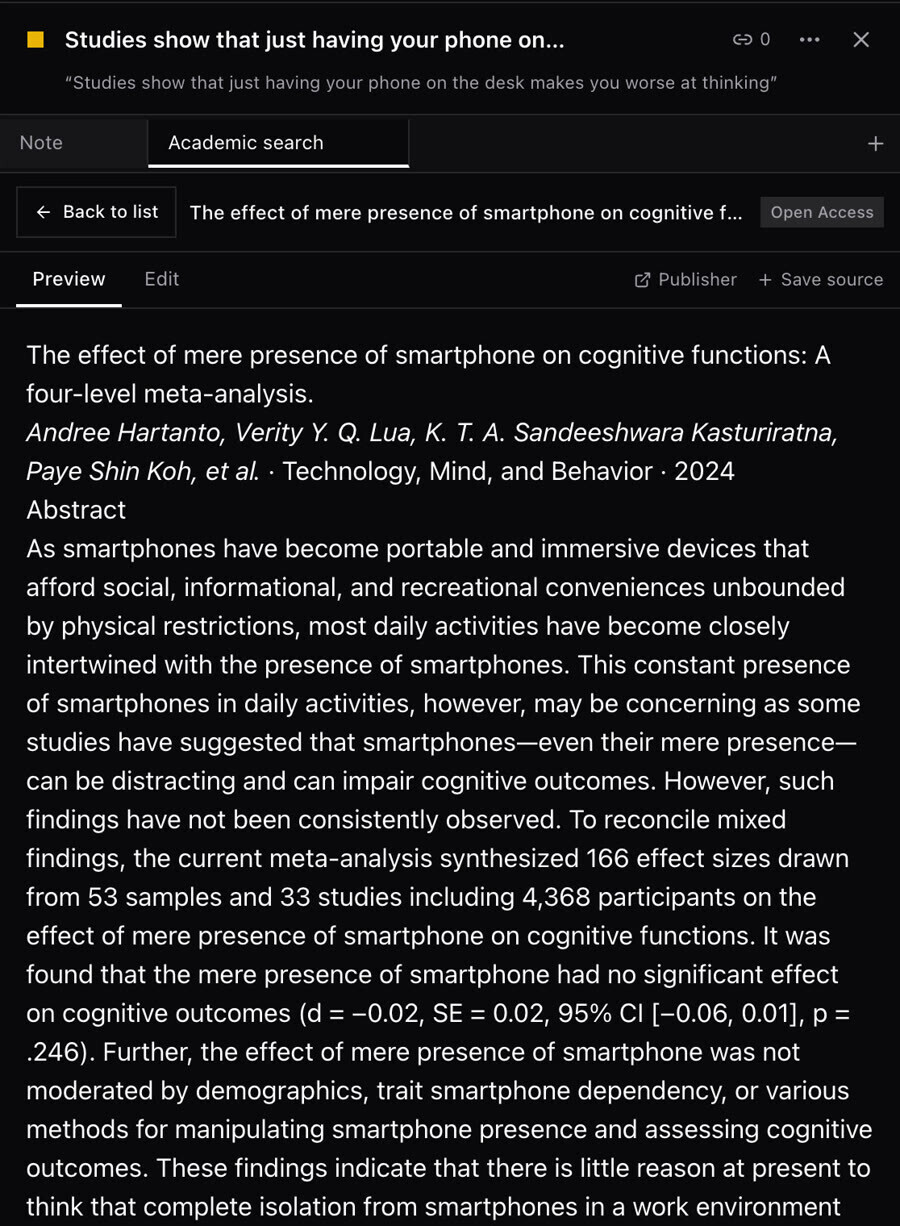
OpenAlex 會列出論文被放在哪些地方,以及每個地方有沒有直接的 PDF:
curl -s "https://api.openalex.org/works/doi:10.1037/tmb0000123?select=open_access,best_oa_location,locations"
統合分析這篇會回傳三個位置:出版社的 PDF 連結、James Cook University 典藏庫裡的 PDF,以及 Singapore Management University 圖書館的介紹頁面。
Brain Drain 這篇用同樣的請求,會看到 "is_oa": true 和 "oa_status": "green",但每個 pdf_url 都是 null。唯一的公開版本是典藏庫的介紹頁面。所以 is_oa 只代表某處有免費版本,不代表你下載得到。要看每個位置的 pdf_url。
沒有 API 金鑰的話,OpenAlex 的請求會和同一個 IP 位址的所有人共用一小份免費的每日額度,回應裡的 meta.notice 也會這樣告訴你。申請免費金鑰(在查詢加上 api_key=)就有自己的額度;如果設定了 OPENALEX_API_KEY,應用程式會讀取它。
pdf_url 也只是一個承諾。出版社常常用 200 狀態碼加上 HTML 內容,回傳 cookie 牆、機器人檢查或登入頁面。應用程式的 Rust 程式碼只在內容以 PDF 的 magic number 開頭時才接受下載:
if !fetched.bytes.starts_with(b"%PDF-") {
    self.tried.push(format!("{source}: link was a web page, not a PDF"));
    return None;
}
同樣的做法用 Python 寫,只需要標準函式庫:
import json
import urllib.error
import urllib.request

UA = {"User-Agent": "paper-finder/1.0"}

def get(url):
    with urllib.request.urlopen(urllib.request.Request(url, headers=UA), timeout=30) as r:
        return r.read()

def pdf_links(doi):
    try:
        work = json.loads(get(f"https://api.openalex.org/works/doi:{doi}"
                              "?select=best_oa_location,locations"))
    except urllib.error.HTTPError as e:
        if e.code == 404:
            return []
        raise
    links = []
    for loc in [work.get("best_oa_location")] + work.get("locations", []):
        url = (loc or {}).get("pdf_url")
        if url and url not in links:
            links.append(url)
    return links

def first_real_pdf(doi):
    tried = []
    for url in pdf_links(doi)[:4]:
        try:
            body = get(url)
        except (urllib.error.URLError, TimeoutError) as e:
            tried.append(f"{url}: {e}")
            continue
        if body[:5] == b"%PDF-":
            return url, body
        tried.append(f"{url}: a web page, not a PDF")
    raise LookupError("no free PDF; tried: " + "; ".join(tried or ["no pdf_url at all"]))
拿統合分析來跑,出版社的連結拒絕了這支腳本,典藏庫的版本則回傳了一個 1.6 MB 的 PDF。拿 Brain Drain 來跑,會直接以「no pdf_url at all」失敗。把試過哪些連結、為什麼失敗記下來,多寫這幾行很值得;只回一句「沒有全文」,你還是得回頭手動找。
每次查詢最多試四個連結、以及去除重複的 URL,這兩點也是沿用應用程式的做法。有些論文有十幾個位置,其實全都指向同一個檔案。
OpenAlex 的查詢只是其中一步。應用程式完整的順序是:
10.48550/arXiv.<id> 的 DOI 就是 arXiv 論文,而 https://arxiv.org/pdf/<id> 永遠是免費的。https://api.unpaywall.org/v2/<doi>?email=<your email>)會回傳 best_oa_location.url_for_pdf 和 oa_locations 清單,沒有附上真實 Email 地址的請求會被拒絕。這兩個服務來自同一個非營利組織 OurResearch,所以應用程式在設定了 UNPAYWALL_EMAIL 時問 Unpaywall,否則讀 OpenAlex 的位置,不會兩個都問。/v3/search/works?q=doi:"<doi>",需要 bearer 金鑰)彙整了各典藏庫的版本,常常直接在 fullText 回傳擷取出的文字。文字超過 500 個字元時應用程式就直接採用,否則改試 downloadUrl。https://www.ebi.ac.uk/europepmc/webservices/rest/<PMCID>/fullTextXML 以 JATS XML 提供整篇文章。它不是 PDF,但章節、圖表和參考文獻都有結構,可以乾淨地轉成 HTML。還有一個 OpenAlex 常讓人卡住的細節:沒有 abstract 欄位。你拿到的是 abstract_inverted_index,一個從每個字對應到它出現位置的 map,要自己把文字組回來:
words = {pos: w for w, positions in idx.items() for pos in positions}
abstract = " ".join(words[i] for i in sorted(words))
這樣用在搜尋結果和初步篩選就夠了。像 Brain Drain 這種唯一公開版本只是典藏庫頁面的論文,摘要加上統合分析的全文,大概就是免費管道能走到的最遠處,通常這時候就該查查你的圖書館有沒有訂閱。

 hana555

 iThome鐵人賽
 看影片追技術