

「系統最近還好嗎?」
半年前,這個問題的答案是憑感覺:「應該……還行吧?最近沒看到什麼錯。」現在,這個問題有一個明確的答案:**上個月 85 分,B 級。**扣分項列得清清楚楚:根目錄的 Markdown 檔案堆超過閾值,扣 10 分(治理檔案自己也會增生——Day 12 的老症頭又犯了);一份 DREAMS 記憶檔進了黃燈區,扣 5 分(Day 10 的記憶肥胖,這次抓到的是早期症狀)。
把「還好嗎」變成一個數字——這就是可觀測性(observability)在個人系統的落地版。今天講這套月度評分怎麼設計、監控的幾層視野怎麼各司其職,以及一個把警報系統搞到「狼來了」失效的真實慘案。
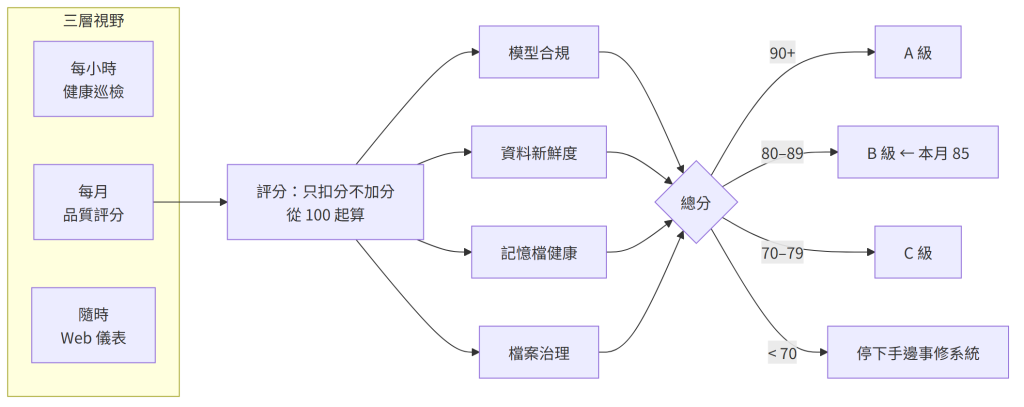
Day 20 講過監控是兩層(每小時守衛+每月體檢);把它們再加上一個「隨時打得開」的 Web 儀表,剛好湊成三種「問題的時間尺度」:
| 頻率 | 機制 | 回答的問題 |
|---|---|---|
| 每小時 | 健康守衛腳本 | 「現在有沒有東西壞了?」 |
| 每月 | 品質報告 + 評分 | 「這個月整體表現如何?趨勢向好還是向壞?」 |
| 隨時 | Web 儀表板 | 「我現在想看的時候,看得到嗎?」 |
每小時的守衛管急性病,每月的評分管慢性病,儀表板管「醫生想親自看一眼」。三者缺一不可,但今天的主角是中間那個——因為急性告警大家都會做,把慢性趨勢變成可比較的數字才是多數個人系統缺的那塊。
月度品質報告由一支 Python 腳本在每月一號生成。它翻閱整個月的資料:排程執行紀錄、告警歷史、快取新鮮度紀錄、閘道掃描結果,然後從 100 分開始往下扣:
score = 100
if 模型合規掃描發現違規:      score -= 15   # 最重——這代表錢正在漏(Day 22 的教訓標價)
if 根目錄_Markdown檔 > 20:    score -= 10   # 治理檔案自己增生(Day 12)
if DREAMS記憶檔過大:          score -= 10   # 紅燈 10 分、黃燈 5 分(Day 10)
if dreaming產出檔堆積:        score -= 8
if 投資資料超過7天未更新:     score -= 8    # 資料新鮮度(Day 18 的下游)
# 90+ = A,80–89 = B,70–79 = C,<70 = 該停下手邊事來修系統
(權重隨我的痛點演化過幾輪——現行版就長這樣,最重的永遠是「連著錢的」。)
幾個設計決策:
**只扣分、不加分。**初版有加分項(「本月零告警 +5」之類),很快發現這會鼓勵錯誤行為——想拿高分,最快的方式是把告警調鈍。扣分制的世界觀不會騙自己:滿分是本分,缺陷才是資訊。
扣分權重 = 修復的急迫性。模型違規扣 15 分,因為那代表錢正在漏——急迫性的頂;dreaming 產出檔堆積只扣 8 分,因為它是遲早要清的庫存,不是正在擴大的傷口。分數的意義不在絕對值,在它逼你為每種缺陷標價——標價的過程就是想清楚優先級的過程。
**等級比分數有用。**85 和 87 的差別毫無意義,B 和 A 的差別才有行動含義:A 代表這個月不用管系統、B 代表週末排點時間、C 代表本週就要處理。給自己看的指標,解析度夠用就好。
評分器自己也遵守 Day 24 的誠實條款。這個月的報告裡就有一行活的示範:模型合規掃描讀不到排程資料庫,報告寫的是「本項不計分——非合規亦非違規」,而不是默默給滿分。量不到的項目扣分是冤枉、給分是說謊,唯一不說謊的處理,是把「我沒看到」標記出來。
報告最後會寫進一份 Markdown(SYSTEM_HEALTH.md),每月一號重新生成、舊版由 git 留史——想看成長軌跡,翻它的 commit 紀錄就是逐月年表。分數的起伏疊著事故時間線看特別有感:哪個月在還債、哪個月閘道開始生效,都寫在數字裡——系統的成長史,用分數寫成年表。
上面整套評的是「系統健不健康」,但有一個更刁鑽的問題它沒回答:**模型生成的那些報告,內容到底好不好?**排程準時跑、訊息成功發,不代表晨報寫得對——LLM 的輸出空間無法窮舉,沒辦法像測程式一樣寫斷言。
我的做法是放棄評「內容對不對」,改評三個量得到的代理指標:
送達驗證——報告有沒有真的抵達頻道,看投遞證據而不是看任務狀態。這個區分是被真實案例教出來的:有一類失敗是任務被標成 error、還多發一則失敗告警,但翻執行紀錄的投遞欄位,報告其實早就送到了——模型在收尾時多呼叫了一個不存在的工具,整個任務被冤枉判死。狀態欄位會說謊,投遞證據不會。
格式契約檢查——每個生成任務的 prompt 都寫明輸出契約(純文字、禁表格、字數上限、必含段落),違約的輸出在 Telegram 上一眼就看得出來,等於每天有一次免費的契約驗收。契約越明確,「壞輸出」就越可偵測——這是把不可測的語意問題,部分轉換成可測的格式問題。
人工抽樣,而且是天天抽——晨報和收尾我每天都讀,這就是最誠實的評估管道。個人系統的獨特優勢正在這裡:使用者、開發者、評估者是同一個人,回饋迴路一天一圈。發現寫錯就改 prompt 或降級成純腳本,半年下來會呼叫模型的任務從三十幾個砍到十五個——每一次「這個交給笨腳本就好」的決定,都是一次評估結論。
老實說,這離正規的 LLM 評估(golden set、自動化評分、回歸比對)還很遠——那是這套系統規模化時第一個要補的東西。但對個人系統,「天天被人讀的輸出」加上「格式契約」加上「送達證據」,已經攔住了絕大多數的爛輸出。
上面那套評分有個沉默的前提:每一項都量得到。
而我有整整一段時間,其中最貴的那一項是量不到的——費用。
報告裡有一條費用曲線,資料來自系統每天寫入的用量快照。某天我去追一筆帳,才發現那個快照長期記到 0:上游回傳的 token 統計欄位是 null,而寫入端很老實地把 null 當 0 存了進去。整條鏈——每日快照、週報的成本段、儀表板的曲線——全部建立在一個空值上。
這裡要兌現 Day 1 講過的一件事:這段程式碼是 AI 助手寫的,而它壞掉的方式很有代表性。
它沒有寫錯語法、沒有拋例外、邏輯讀起來完全通順——它只是假設了上游一定會給你數字。而這正是 AI 產出最常見的失效形態:在「正常情況」下完美無缺,在「上游給你空值」這種現實情況下安靜地錯下去。
我後來的心得是:跟 AI 配對開發,程式碼審查的重點要從「這樣寫對不對」移到「這段程式碼假設了什麼」。前者它通常做得比我好;後者它看不到,因為那些假設不在程式碼裡,在我沒告訴它的現場條件裡。
最刺人的是:**這不會產生任何錯誤。**沒有例外、沒有告警、沒有紅字。曲線平平穩穩地畫著 0,看起來甚至像「成本控制得很好」。
修法分兩步,兩步都不是我原本以為的方向。
**第一步:換資料源。**原本讀的是上游提供的「彙總欄位」,那是別人算好給你的數字;改成讀每一次模型呼叫留下的執行軌跡,自己加總。差別在於前者是二手的、可能不更新,後者是一手的、只要呼叫發生過就在那裡。能自己算的,不要相信別人替你算好的。
第二步,也是我覺得更重要的:誠實回報涵蓋率。
換了資料源之後我才發現,有一家 provider 根本不回報用量——呼叫成功、有完整回應、但用量欄位全是 0。這時候你有兩個選擇:把它當 0 塊錢,或者記成「未回報」。
我選後者,而且把它做成一個獨立欄位放進報告:
用量涵蓋率:6 / 18 次成功呼叫有用量資料(33%)
缺口:gemini-3-flash-preview 12/12 未回報
這行字看起來很難看,但它是誠實的。把「量不到」記成「沒花錢」,正是爆量能長期不被發現的原因——帳面永遠漂亮,因為看不見的部分被當成零。
那個缺口最後查出來是免費額度的部分,實際成本確實接近零。但這是查證之後才知道的結論,不是預設值。系統該做的是把不確定標出來,讓人去查,而不是替人樂觀。
三層視野裡的「隨時」,實作是一個跑在 NAS 上的網頁儀表——把 workspace 裡那些 Markdown 和快取 JSON,渲染成人看得懂的頁面。Day 13 說全檔案化的好處之一是「我隨時能打開看它在想什麼」,這個儀表就是那句話的介面版。
它長成現在這樣不是規劃出來的,是每次「我想看某個東西但要 SSH 進去 cat 檔案」就多一頁:持倉與趨勢、行情與觀察清單、排程狀態、用量與成本、設備即時狀態、記憶瀏覽……
其中一個決定我想特別講,因為它是產品思考而不是技術問題:
系統原本有一個看板,管所有待辦——包括「我要修的 bug」和「只有人做得到的事」(換 API 金鑰、去廠商後台設消費上限、投資決策)。混在一起的結果是,少數幾件人工項被大量開發卡淹沒。而人工項往往才是真正的瓶頸:程式我可以自己排時間寫,但沒換的金鑰會一直是風險。
所以我把它們拆成兩個頁面。判準不是重要性,是**「誰做得到」**:系統自己能做的留在開發看板,只有人做得到的獨立一頁。拆開之後那些事才真的開始被處理。
到這裡,可觀測性看起來已經完備:急性有守衛、慢性有評分、隨時有儀表、量測有涵蓋率。
但我還漏了一個問題,而且要到這個系列快結束時才會發現——那些負責「看見」的機制,自己壞掉的時候,誰來看見?
這個問題的答案不太好看,我留到 Day 30 講。
講一個把我上了一課的數字:31。
某個月的品質報告顯示,健康守衛當月發了三十幾則告警,其中 31 則是同一個誤報:守衛檢查排程清單時,把一個 job 的別名(alias)誤判成「不在白名單內的未知 job」,於是每小時忠實地告警一次。修復很簡單(比對邏輯加上別名解析,五分鐘的事),但我拖了快一週才修——為什麼?
因為第 5 次之後,我看到那則告警就自動滑掉。第 10 次之後,我把整個告警頻道靜音了兩天。而在靜音的那兩天裡,有一則真正的告警(快取更新失敗)混在誤報堆裡,被我一起滑掉了。
這就是告警疲勞(alert fatigue)的完整病程:誤報 → 麻痺 → 靜音 → 漏掉真警報。事後我立了三條規矩:
**指標一開始貪多。**初版報告有二十幾個指標:平均回應時間、token 用量分布、記憶檔案增長率……做得很爽,看的人(我)每月只掃一眼總分。三個月後砍到剩七個扣分項加一條費用曲線。指標的價值不在收集成本,在「看到之後你會不會採取行動」——不會改變行動的指標,是儀表板上的裝飾品。
可觀測性的個人版三句話:急性問題靠每小時守衛、慢性趨勢靠月度評分、誤報當 P1 修。分數不是目的,是逼自己為每種缺陷標價的手段。
系統健康顧好了,下一個要面對的是更難堪的主題:安全。明天是資安自白書——我做了一輪安全審查,發現最大的漏洞全部是我自己親手埋的:token 進了 git、密碼寫進 Markdown。
🔑 這篇的關鍵字
月度健康評分:扣分制(每個扣分項對應一個看到會行動的指標)· 趨勢比單月分數重要
誤報是 P1 級 bug——誤報殺死的是整個告警系統的信用,比漏報更急著修
告警疲勞 / alert fatigue · 告警去重 · 同一問題只叫一次
指標的價值不在收集成本,在「看到之後你會不會採取行動」——不改變行動的指標是裝飾品
⚠️ 量測鏈本身會壞:上游回null、寫入端當 0 存 → 整條曲線建立在空值上
我是一名金融業資訊工程師,這是我半年來在家自架 AI Agent 系統的實錄。


 iThome鐵人賽
 看影片追技術