
Graph Engineering(圖結構工程)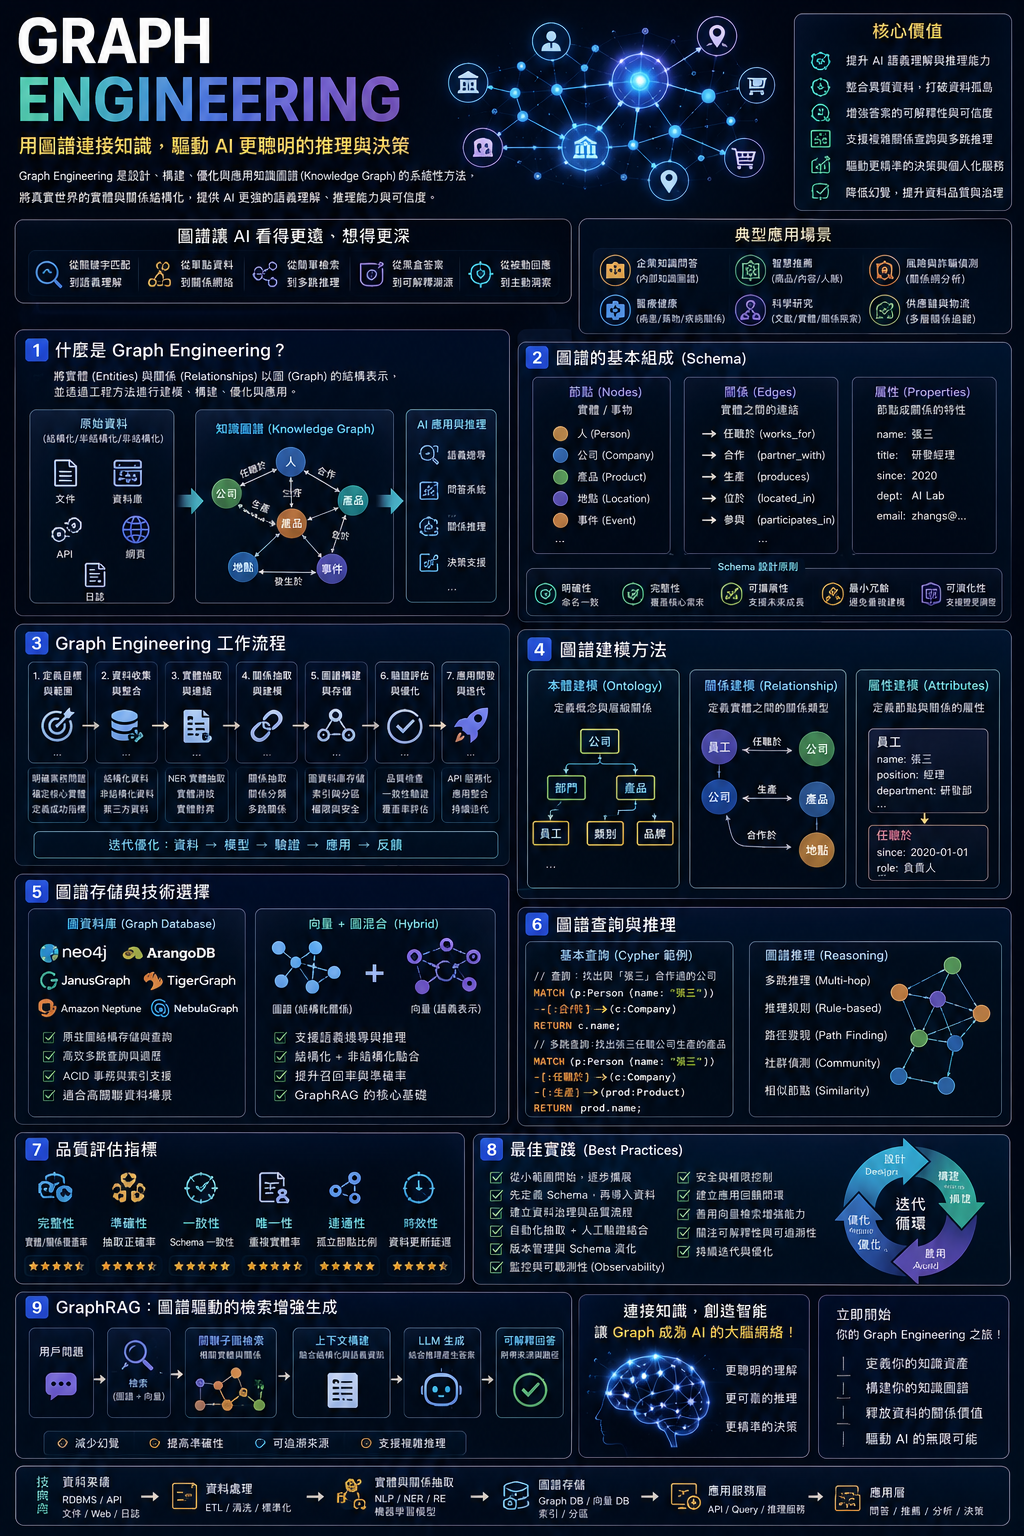
是近期 AI 開發與多智能體(Multi-Agent)領域中備受討論的最新概念。隨著開發者不再滿足於讓 AI 單次回答問題,而是指揮一群 AI 分工合作完成大型複雜專案,Graph Engineering 便成為安排與協調複雜工作流的核心方法論
1. 什麼是 Graph Engineering? 簡單來說,Graph Engineering 就是事先把 AI 要做的事,安排成一張清楚的「流程圖」(有向圖/狀態機)
過去單一或少數 AI 運作時,往往只能依賴單向迴圈(Loop)一件一件事情慢慢做,容易遇到記憶遺忘、一出錯就要全部重來、或無法有效平行的瓶頸。而 Graph Engineering 則是透過明確的圖結構來定義系統:
節點(Node):一個個獨立的工作單位或步驟(例如:查詢資料、審查檔案、執行測試),每個步驟各司其職邊(Edge):步驟與步驟之間的交棒關係、真實資料流與相依性(決定誰先做、誰後做、哪些可以同時平行處理)狀態與驗證(State & Verifier):記錄整體的進度、成本與產出,並在邊或節點之間加上檢查機制(Anchor),確保輸出符合預期2. 它在 AI 工程演進中的定位Graph Engineering 並非憑空出現,它是 AI 應用架構「層層相依」演進下的產物。從近年流行的 AI 工程術語來看,它們呈現由內而外的包含關係:
Prompt Engineering(提示工程):控制單次回答的指令與字句Context Engineering(情境工程):控制模型當下能看到的資料、文件與記憶Harness Engineering(駕馭工程):為模型搭建防護欄、工具調用介面與執行環境的整套外圍系統Loop Engineering(迴圈工程):讓單一 AI 自主進行「觀察 - 執行 - 檢查 - 重試」自動化循環Graph Engineering(圖結構工程):當任務過於龐大時,將多個 Agent 或迴圈組織成一張可平行、可分流、可追蹤的大型工作流程圖3. Graph Engineering 的核心優勢 打破序列限制(支援平行處理):圖上沒有先後依賴關係的任務可以同時執行,不必乾等前一步完成。過程可視化與可追溯:將原本隱含在模型黑盒子裡的推理過程,轉化為具備白盒路徑的圖結構,方便進行人工審查、錯誤定位與系統除錯精準的異常控管與介入:在流程中的關鍵節點(如涉及帳務、重要寫入或高風險動作)可以輕鬆插入「真人檢查點(Human-in-the-loop)」,在不中斷全域系統的情況下等待人工審核4. 適用場景與應用 Graph Engineering 特別適合用在複雜、多步驟且需要多個 Agent 協同合作的企業級應用,例如:
大型軟體開發專案:多個 Agent 同時進行需求拆解、程式碼編寫、自動化測試與代碼審查複雜客服與工單分流:自動抓取會員與訂單紀錄、判斷緊急程度、分流至對應部門並草擬回覆深度知識檢索與多跳推理(Multi-hop Reasoning):結合知識圖譜(Knowledge Graph)與圖結構,讓 AI 沿著明確的邏輯路徑進行推理,大幅降低幻覺率Graph Engineering 運作架構圖解[ 1. 多源數據擷取與清洗層 (Data Ingestion & Extraction) ]
├── 非結構化文檔 / PDF / 網頁 (Unstructured Data)
├── 結構化數據 / SQL 庫 / API (Structured Data)
└── 實體與關係萃取 (LLM-based Entity & Relation Extraction)
│
▼
[ 2. 圖譜建構與對齊層 (Graph Construction & Alignment) ]
├── 節點與邊的定義 (Nodes & Edges / Schema Design)
├── 實體解析與消歧義 (Entity Resolution & Disambiguation)
└── 知識融合與圖譜對齊 (Knowledge Fusion & Alignment)
│
▼
[ 3. 圖資料庫與儲存層 (Graph Database & Storage Layer) ]
├── 圖資料庫核心 (Graph DB Engine: e.g., Neo4j, NebulaGraph)
├── 向量與屬性融合 (Property Graph + Vector Embeddings)
└── 索引與圖結構快取 (Graph Indexing & Caching)
│
▼
[ 4. 圖分析與檢索運算層 (Graph Analytics & Retrieval Layer) ]
├── 圖查詢語言 (Cypher / GQL)
├── 圖演算法與關聯挖掘 (Graph Algorithms: PageRank, Centrality, Community)
└── 圖檢索增強生成 (GraphRAG / Multi-hop Traversal)
│
▼
[ 5. 應用與視覺化層 (Application & Visualization Layer) ]
├── 互動式圖譜視覺化 (Interactive Graph UI)
├── AI 智能體與決策支援 (Graph-powered Agents & LLM Integration)
└── 洞察輸出與回饋閉環 (Insights & Continuous Update Loop)
核心組件與運作階段解析數據擷取與萃取層 (Ingestion & Extraction)圖譜工程的起點是將散落的資料轉化為具有關聯意義的點與線:
Entity & Relation Extraction:利用大語言模型(LLM)或 NLP 技術,從長篇文檔中自動提取「實體(Entities,如人物、公司、事件)」以及「關係(Relations,如收購、合作、發生於)」圖譜建構與對齊層 (Construction & Alignment)Schema Design:定義圖譜的本體(Ontology),規範哪些類型的節點可以有什麼樣的關係
Entity Resolution:解決「同義異詞」或「異名同義」的問題(例如將「台積電」與「TSMC」指向同一個實體節點),確保圖譜的乾淨與準確
圖資料庫與儲存層 (Graph Storage)Property Graph:以圖資料庫(如 Neo4j、NebulaGraph)為核心,不僅儲存節點與邊,還能在上面附加豐富的屬性(Properties)
Graph + Vector 融合:現代圖譜工程常將向量嵌入(Vector Embeddings)結合進圖結構中,實現「語意向量搜尋」與「精準圖結構遍歷」的雙軌並行(GraphRAG)
圖分析與檢索層 (Analytics & Retrieval)Multi-hop Traversal(多跳查詢):突破傳統向量檢索只能找「相似片段」的限制,透過圖譜的「關聯跳躍」找出深層次的因果關係(例如:A 投資 B,B 供應 C,因此 A 影響 C)
Graph Algorithms:運用 PageRank 或社群發現(Community Detection)等演算法,計算關鍵節點與群聚效應
應用與視覺化層 (Application & Visualization)將複雜的關聯網路透過直覺的圖形化介面呈現,或是作為高階 AI 智能體(Graph-powered Agents)的記憶中樞,提供具備強大邏輯脈絡的決策支援


 iThome鐵人賽
 看影片追技術