
系列:30 天打造企業級 PLM|面向:後端
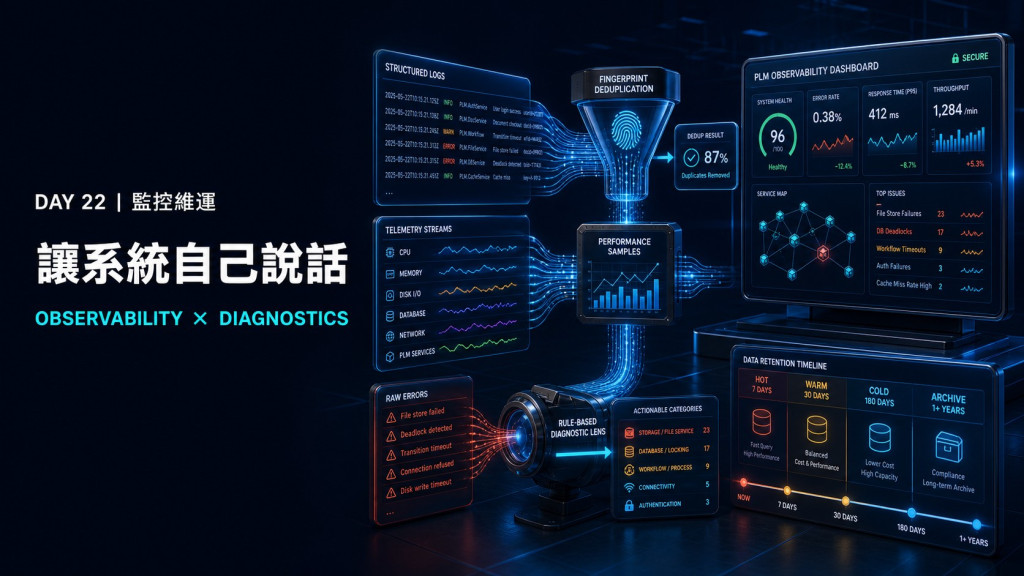
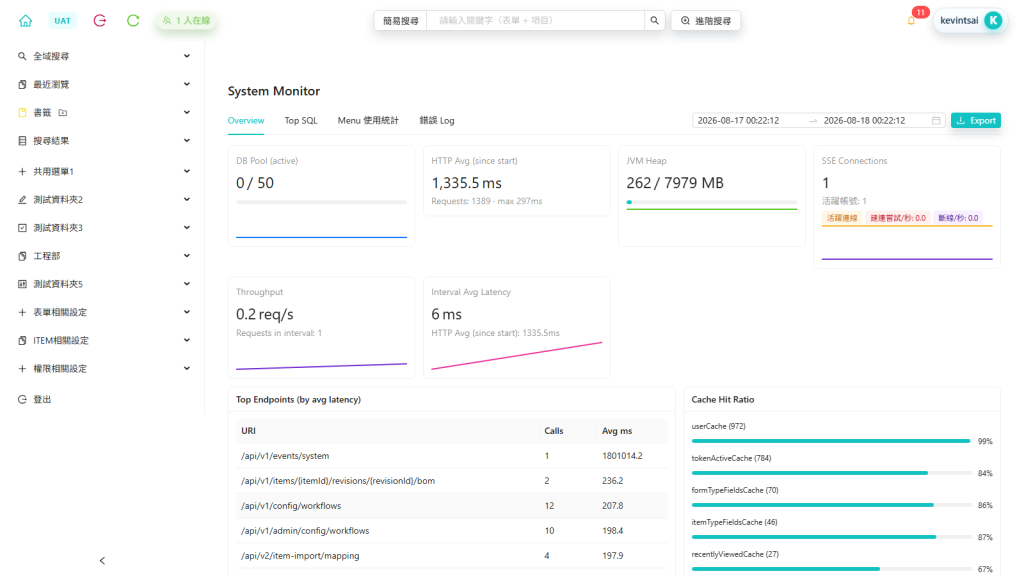
上線後的日常:「系統怪怪的。」沒有監控,每次都要遠端連上主機,在幾 GB 的 log 裡大海撈針。企業內網環境往往裝不了雲端 APM,Mini-PLM 的選擇是把監控做進系統本體:錯誤自動收集去重、效能樣本自動記錄、一頁 Monitor 看全部。
Monitor 頁實機畫面:
以前在 Oracle Agile PLM 的維運體系中,排查問題往往令人崩潰:
ManagedServer.out、Agile.log 中。同一個 bug 在一小時內噴出數萬行重複的 Stack Trace,硬碟常被塞爆,搜尋錯誤有如大海撈針;Mini-PLM 選擇在系統內建輕量級結構化 Monitor 模組:自動對錯誤進行 SHA-256 指紋去重與計數累加,並即時收集 API 效能樣本與 Top 慢查詢,讓管理員直接在一頁 UI 掌控全局。
Prometheus 加 Grafana 加 ELK 是標準答案,但內網部署的現實是多三套要維運的系統、跨系統關聯要自己建,而我們要回答的問題其實很收斂:哪支 API 慢、哪個錯誤爆量。取捨結果是監控進系統本體、資料存主資料庫、UI 就是系統的一頁。代價是監控與系統同生共死,系統倒了監控也倒,緩解靠外部的 /actuator/health 探測。規模換簡單的又一例,等到多節點分散式(Day 30 roadmap),再引入獨立監控棧不遲。
同一個 bug 在生產環境不會只發生一次,它會發生一萬次。逐筆存等於自己 DDoS 自己的資料庫。解法兩段(實碼註解):
// 錯誤日誌記錄實體
/**
 * 指紋 = SHA-256(exceptionClass + message 前 200 字 + logger) 十六進位前 64 字
 */

// 錯誤日誌寫入器
/**
 * 去重節流:先對「去重時間窗內同指紋」的列做 UPDATE(累加 OCCURRENCE_COUNT),
 * ...
 */
指紋的配方是重點:exceptionClass 加 message 前 200 字加 logger。message 只取前 200 字,因為訊息尾巴常帶變動值(ID、時間戳),全文進指紋會讓同一個 bug 產生一萬個不同指紋,去重直接失效。寫入端則是時間窗內同指紋 UPDATE 累加、否則 INSERT。一萬次發生變成一列加計數 10000,爆量錯誤反而看得更清楚。
錯誤列表不只給 stack trace,還配解讀規則:常見錯誤 pattern 對應「這通常是什麼問題、先檢查什麼」。例如 CLIENT_REQUEST 類等於使用者端網路中斷,不用緊張。值班的人不需要是寫程式的人,診斷知識從資深工程師的腦子搬進規則表。這也是 Day 30「AI for Maintain」的地基:規則式解讀先把格式與流程鋪好,之後換 AI 當解讀器是水到渠成。
每個 API 請求記效能樣本(路徑、耗時、時間戳),保留 7 天。分析走離線匯出:Monitor 頁一鍵匯出 ZIP(樣本時序、Top SQL、錯誤彙總,預設近 24h),資料拿回本機用趁手的工具慢慢分析,不在生產系統上跑重查詢。Day 21 壓測的監控快照收集,接的就是這套樣本體系。
Release Notes 產生腳本在 git commit 後產生版本說明 JSON({timestamp}-{shortHash}.json),前端配 version.json 偵測新版、彈 What's New。維運的最後一哩:使用者知道系統更新了什麼,支援電話就少一半。
指紋去重讓爆量變計數,規則式解讀讓知識資料化,樣本加離線匯出讓分析不擾生產,health 只答自己。品質週到此結束,明日起進入 Migration 篇。Day 23:怎麼把十幾年的舊系統資料撈出來。


 iThome鐵人賽
 看影片追技術