

談到 AI Guardrails,常見的反應是:「這是 AI Security 的事吧?」也有人會問:「把限制寫進 Prompt 不就好了?」或是:「模型都這麼強了,還需要加這麼多限制嗎?」
避免 Prompt Injection、阻擋有害內容、偵測敏感資訊,確實都是 Guardrails 的重要應用。但在過去幾年參與企業 AI 專案與 PoC、研究不同 Guardrails 技術,以及嘗試設計企業級 Guardrails Solution 的過程中,筆者越來越在意另一個問題:企業訂下的要求,要怎麼變成系統實際會執行、也能被驗證的控制?
對企業來說,Guardrails 也是將治理、風險與合規(Governance, Risk and Compliance, GRC)需求,轉換成可執行技術控制的工程手段。
這是筆者選擇從 GRC 視角展開這次 30 天鐵人賽的原因。防止 AI 被攻擊 / 入侵是其中一項任務;企業還需要根據業務情境決定哪些資料可以使用、哪些行為可以放行,以及出錯時該如何處理。
Guardrails 能承接其中一部分要求。至於應該控制什麼、控制到什麼程度,還得回到業務情境與組織的政策。
討論 Guardrails 時很容易先從輸入與輸出的內容開始檢查:使用者是否觸及禁止討論的主題(Denied Topics)?Prompt 是否試圖繞過限制(Prompt Injection)?回覆是否包含不該揭露的個人資料(PII Leakage)、有害內容(Content Safety),或缺乏依據的敘述(Hallucination)?
這些問題都需要處理;但即使偵測到了風險,系統也還不能直接決定下一步行動是甚麼。
假設 PII Detector 在輸入中辨識到一個身分證字號,接下來應該怎麼辦?
PII Detector 能提供的是偵測結果;但企業要採取哪一種處理方式還得看這是什麼業務流程、使用者是誰、資料從哪裡來,以及目前正在執行什麼任務,同時要考量組織的政策與可接受風險範圍後,才能有相依據來決定處理方式。
例如,同樣是身分證字號,出現在公開客服的對話裡,與出現在經授權的內部作業流程中,可能需要不同的控制。即使使用者有權限讀取,也還要確認目前的任務是否允許將資料交給模型,或顯示在回覆裡。
所以,偵測之後還有一個更關鍵的問題:
在這個業務情境下,政策允許系統如何使用這筆資料,又要求系統執行哪些控制手段?
從辨識資料,到依政策決定處理方式,再將決策落實到執行流程,正是筆者想討論的合規工程(GRC Engineering)。
最直覺的 Guardrails 架構,是在模型前後各放一個檢查點:
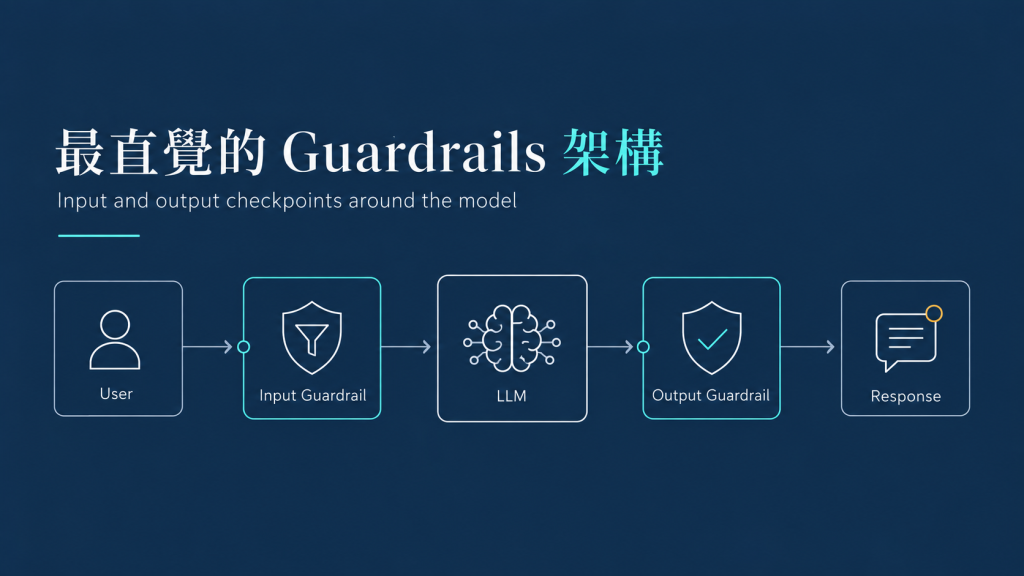
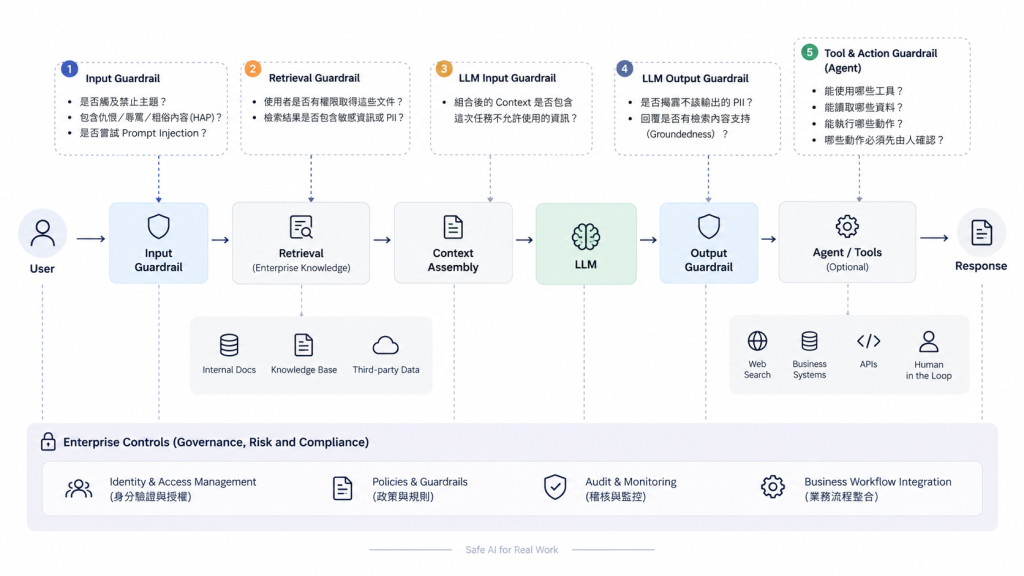
這張圖容易理解,但進入企業流程後,還需要把檢索資料、權限與工具操作等環節展開來看。
以 RAG 客服為例,不同位置要回答的問題就不一樣:
| 檢查位置 | 要處理的問題 |
|---|---|
| 使用者輸入 | 是否觸及禁止主題、包含仇恨/辱罵/粗俗內容(HAP),或試圖進行 Prompt Injection? |
| 資料檢索 | 使用者是否有權限取得這些文件?檢索結果是否包含敏感資訊或 PII? |
| LLM 輸入 | 組合後的 Context 是否包含這次任務不允許使用的資訊? |
| LLM 輸出 | 是否揭露不該輸出的 PII?回覆是否有檢索內容支持(Groundedness)? |
如果應用進一步發展成 Agent,還得控制它能使用哪些工具、讀取哪些資料、執行哪些動作,以及哪些動作必須先由人確認。這些控制也需要和既有的身分驗證、授權與業務流程整合。
為了把責任拆清楚,筆者在設計企業 Guardrails Solution 時,會先區分「檢查能力」與「政策」。
在本文採用的拆分方式中,單一 Guardrail 檢查元件負責辨識特定條件,例如使用 PII Detector、Regex、HAP Classifier,或 LLM-as-a-Judge 進行檢查。Policy 則定義特定業務情境下需要哪些檢查,以及命中後應採取什麼行動。
也就是說,檢查元件回報「發現了什麼」;系統再依 Policy 決定要拒絕繼續推論、遮罩處理、放行,或轉交人工處理。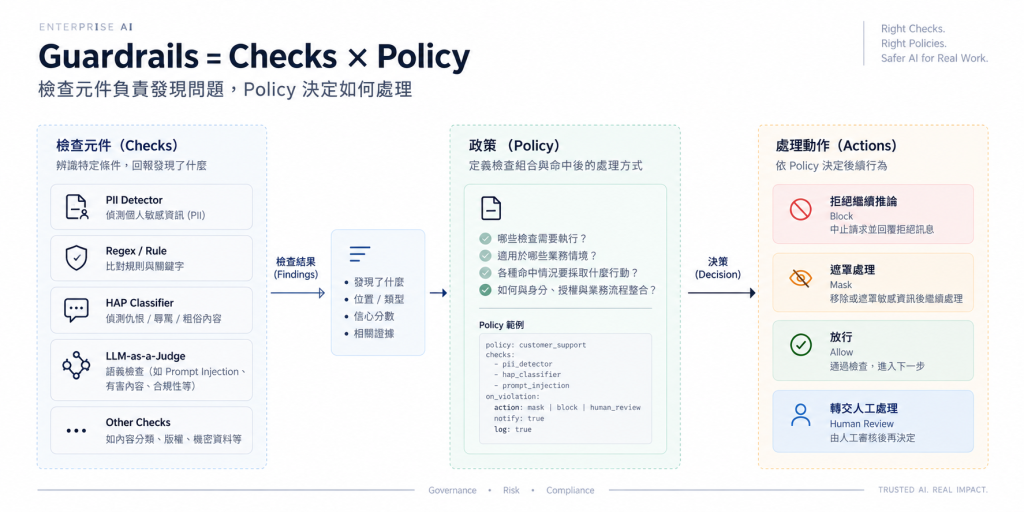
Guardrails 的實作可以從很簡單的規則開始。以下片段只示意關鍵字阻擋的邏輯:
if "信用卡號" in response:
    block()
它檢查的是「信用卡號」這幾個字是否出現。因此,正常的信用卡使用說明也可能被擋下;反過來,如果回覆直接列出卡號,卻沒出現這個詞規則就可能漏掉。
再往下做,可以使用 Regex、允許/封鎖清單(Allow/Deny List)、命名實體辨識(NER)、分類模型(Classification Model),或 Guardian LLM。涉及評估與人工覆核時,也可能用到 LLM-as-a-Judge、Reward Model 與 Human Review;它們在流程中扮演的角色,需要分別說清楚。
技術選擇的難處,在於企業必須同時考慮多種代價。偵測準確度如何?誤擋(False Positive)會不會中斷正常業務?漏擋(False Negative)會留下什麼風險?增加一層模型檢查後,延遲與成本 (Latency & Cost)是否可以接受?日後政策改變又由誰維護與驗證 (Day2 Problem)?
因此評估一組 Guardrails 時筆者會先問:目前要控制哪一項風險、可接受的錯誤範圍是什麼,以及這套組合能否在成本與延遲限制內達到需求。
「哪個模型最強」可以是選型時的問題,但要先有明確的任務與評估條件答案才有意義。
假設今天接上了一個 PII Guardrail,Demo 順利回傳結果:
Input:
我的身分證字號是 A123456789

Result:
PII Detected
很好,至少這一筆抓到了。
接下來,電話號碼、中文姓名、地址與銀行帳號呢?電話換一種格式,或混在中英文裡,還能辨識嗎?一萬字文件裡只有一句個資,會不會漏掉?
誤判也得測。「訂單編號 0912345678」看起來像電話號碼,Detector 會如何分類?系統又該依什麼情境決定是否遮罩?
而且,測試不能停在「PII Detected」。如果政策要求 Masking,還要檢查遮罩後有沒有殘留;如果要求 Block,就要確認內容確實沒有被送到下一個環節。最後,企業仍得決定誤擋與漏判各能接受到什麼程度。
Guardrails 的驗收,需要用測試證據說明:在約定的情境與條件下,控制是否達到需求,還有哪些情況沒有被涵蓋。
這時候,下一個麻煩就來了:測試資料從哪裡來?
企業未必能直接取用幾萬筆真實客戶資料做測試。但缺少測試資料,就很難知道 Detector 到底會漏掉什麼,更難比較不同控制方式的效果。
因此,這個系列會接著談合成資料(Synthetic Data)、評估(Evaluation)、LLM-as-a-Judge、Reward Model 與人工校準(Human Calibration)。合成資料用來建立可控制的測試案例;評估流程用來比對預期與實際行為;模型評分和人工校準,則要處理判斷品質與評估結果是否可信的問題。
它們各自負責不同工作,共同支援 Guardrails 的驗證。測試資料的品質、涵蓋範圍與評估方法,也都會限制我們最後能提出多強的結論。
筆者想用這 30 天,整理企業從提出需求到驗證控制的工程過程:
業務與 GRC 需求
        ↓
辨識風險、訂定政策
        ↓
定義預期行為與驗收條件
        ↓
設計測試情境、建立合成測試資料
        ↓
建立評估方法
        ↓
實作、組合與評估 Guardrails
        ↓
依證據調整選型、政策與控制
最後,希望能回到企業 AI 架構設計時的一個實際問題:
面對一個 AI Use Case,我們為什麼選擇這樣設計 Guardrails?它控制了哪些風險,又有哪些證據支持這個選擇?
接下來讓我們用鐵人賽的 30 天來深入淺出討論這個企業部署 LLM 應用上線時繞不過的主題吧。


 iThome鐵人賽
 看影片追技術