
「這個系統真的很難改。」
聽到這句話,我會想再問仔細一點:是改一個欄位就要動很多地方,還是測試、上線要等很久?先把困難說清楚,後面才知道要怎麼改善。
例如,需求只寫「提升效能」,工程師可能看平均回應時間,但是使用單位在意的卻是那支一直逾時的月結查詢。大家都在努力,只是心裡想完成的事情卻不太一樣。驗收前,這個差異就要先談清楚。
所以,我會先把每個問題的影響、現況、目標與量測方式列出來。下表先做前半段:把模糊痛點翻成可量測的問題,再對到建議指標。現況與目標值要在各自環境量過才填得出來。
| 模糊痛點 | 可量測問題 | 建議指標 |
|---|---|---|
| 需求很慢 | 從需求確認到上線需多久 | Lead Time for Changes |
| 常常改壞 | 部署後需修復或回退的比例 | Change Failure Rate |
| 問題難查 | 從告警到恢復需多久 | MTTR |
| 權限很亂 | 是否能證明誰可存取何種資料 | 權限複核率、越權測試 |
| 介面太多 | 有多少系統直接連 ERP | 直接連線數、治理入口覆蓋率 |
之後回頭看,要知道自己到底進步了多少,這裡的順序就很重要。先知道問題影響了哪些作業,再記錄目前的數字,最後才訂目標值。
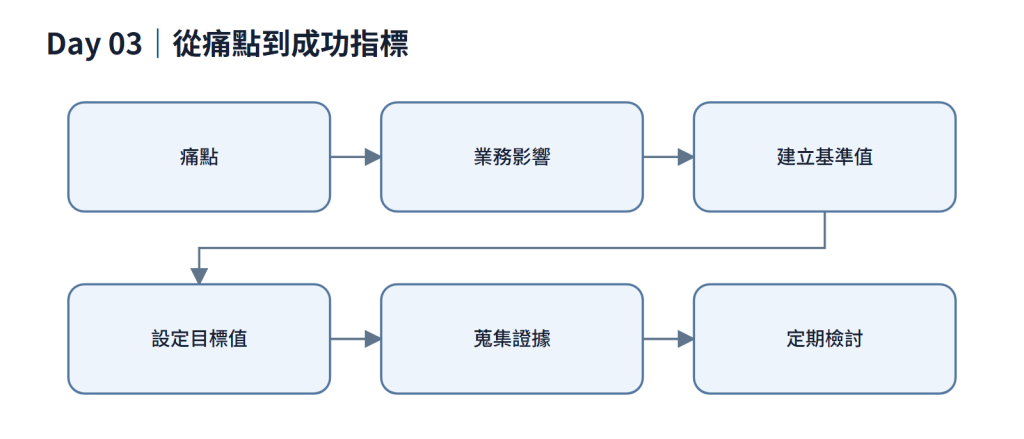
圖 Day 03-1:從痛點到成功指標。
指標只看單邊會失真:交付變快了,維運卻可能更累。所以沿用上一篇的做法,我會把指標分成兩邊來看:一邊看業務與交付有沒有改善,另一邊看維運或使用者有沒有因此多受一些影響。
借用公開定義,可以減少各自解讀,也讓跨團隊比較有共同語言。所以交付面可以直接借用 DORA 的四個關鍵指標——變更前置時間、部署頻率、變更失敗率與失敗部署恢復時間。但要注意它們衡量的是「交付系統的效能」,不衡量 ERP 現代化本身的價值,因此還需要補上耦合面與治理面的指標,例如直接連線 ERP 的系統數、治理入口涵蓋率與可追蹤請求比例。
沒有這些基礎紀錄,後面的目標就很難說明:請求要有 correlation ID,部署要有時間紀錄,事故要有開始與恢復時間,再把需求和測試接起來。這些看起來是準備工作,卻是訂目標的前提。所以在目標裡,我不會急著寫下「效率提升 50%」這種百分比。
另外,數字變差時,總要有人查原因、調整做法,量測才會接到下一步的行動。所以每個指標也要找到能處理它的人,把負責人找好。
指標定義,我會寫到換一個人來算,也能得到同樣結果的程度。負責人、資料來源、量測頻率與門檻,都先列好。下面是 ERP 入口涵蓋率的例子:
Metric: ERP Gateway Coverage
Formula: 經 Gateway 的 ERP API 呼叫量 / 全部 ERP API 呼叫量
Owner: Platform Team
Frequency: Weekly
Sample: 營業日 08:00-20:00,排除壓測與健康檢查流量
Evidence: Gateway metrics + ERP access log
Baseline: 待補(需先完成 ERP access log 集中收集)
計算時,我會先確認分母與排除條件。像健康檢查、壓測流量要不要計入,就得先說好;ERP access log 還沒集中時,分母可能也拿不到。這些都要先補齊,數字才算得出來。
以 MTTR 來說,哪些事故要算、從何時開始、怎樣才算恢復,都要定義。使用者報案時間與監控告警時間不能混用;部署成功率,也要說清楚是否包含 smoke test 與上線後觀察。
因為跨期比較要成立,前提是同一份指標用一致的樣本與統計方式。若中途調整了取樣範圍或計算公式,就當成新的指標序列,在紀錄中標明變更時間,不要和舊資料直接接續比較。
| 取捨 | 這樣選的理由 | 何時要重新評估 |
|---|---|---|
| 初期只維護少量指標 | 指標過多會讓定期檢討失焦,也增加資料維護成本 | 現有指標無法解釋落差來源時 |
| 借用 DORA 既有定義 | 有公開定義可對照,減少各自解讀 | 定義與實際流程不符時,例如尚無獨立部署單位 |
| 門檻先留空,只記基準值 | 沒有基準值就設目標,等於用猜測當驗收條件 | 基準值已累積足夠期數,波動範圍可判斷時 |
| 以既有品質流程紀錄作為證據 | 減少重複整理,也讓稽核有單一來源 | 既有紀錄粒度不足以支撐指標計算時 |
事故提早結案,MTTR 會縮短,但使用者可能還不能工作;部署次數增加,也可能是同一個問題反覆修補,而不是交付變快。所以數字變好,還是要看看背後發生了什麼,配合事故紀錄與使用者影響一起看。
做到這裡,先有一份能重複計算的定義,再有一組現況數字,我就認為已經踏出了重要的一步。下面整理幾個可以先開始的指標:
| 指標 | 計算方式 | 想回答的問題 |
|---|---|---|
| Lead Time for Changes | 需求確認至正式上線的時間 | 交付是否仍被核心系統的上線時段綁定? |
| Change Failure Rate | 需修復或回退的部署/全部部署 | 變更品質是否穩定? |
| MTTR | 事故開始至服務恢復的時間 | 恢復能力是否改善? |
| ERP Gateway Coverage | 經 Gateway 的 ERP 呼叫量/全部 ERP 呼叫量 | 治理入口是否真的收斂了舊路徑? |
| 可追蹤請求比例 | 具 correlation ID 的請求/全部請求 | 問題能否跨系統追蹤? |
| 權限複核率 | 已完成複核的角色/全部角色 | 權限現況是否可以被證明? |
定期回顧時,也把事故報告與使用者回饋放進來。如果數字變好,使用單位卻覺得更難用,就先看看量測是不是漏掉了他們在意的部分。
今天想整理的,其實就是把「希望變好」說得更清楚。先知道現在在哪裡,再一步一步看耦合、交付時間和恢復能力有沒有改善。下一篇,來比較一次重建與漸進式現代化,看看各自需要準備什麼。


 iThome鐵人賽
 看影片追技術