
上一篇先談了為什麼 ERP 還能運作,周邊卻需要新的整合方式。接下來,我想繼續整理一個很實際的問題:事情這麼多,到底要先做哪一件?
我的想法是,先把現況與做法放在同一張表裡。每個方案要改善什麼、會多出哪些工作,以及最後怎麼確認結果,都一起寫清楚,再來安排資源。
討論架構時,我會希望大家先對三件事有共識:為什麼現在要做、做到哪裡算完成,以及出了問題由誰處理。策略矩陣,就是把這些問題放在一起,讓業務、工程團隊與主管能夠一起看、一起討論。
下面用舊 ERP 串接周邊系統的情境來整理。這是一份示例,真正使用時,還是要換成自己專案盤點出來的現況與指標。
| 面向 | 常見現況 | 策略方向 | 預期價值 | 主要風險 | 驗證指標(結果/健康) |
|---|---|---|---|---|---|
| ERP 整合 | SOAP 與直連資料庫並存 | Gateway 加 Adapter | 降低直接耦合 | 多一層中介 | 還有幾個系統直連 ERP 資料庫/查詢超過 3 秒的比率 |
| 身分 | 權限散落各系統 | Keycloak 加 RBAC | 集中治理 | 權限模型錯配 | 不該登入卻還能登入的帳號數/因權限被擋而求助的件數 |
| 事件 | 同步呼叫互相等待 | 查詢留 REST,寫入走事件 | 降低等待與耦合 | 最終一致性 | 使用者按下送出後要等幾秒/每天要人工補救的筆數 |
| 維運 | 靠人工翻 Log | 可觀測性平台 | 縮短定位時間 | 告警噪音 | 出事到找到原因要多久/告警裡真的要處理的比率 |
| 交付 | 手動部署、證據零散 | CI/CD 加測試留證 | 可重複、可追溯 | 初期流程變慢 | 改一版從寫完到上線要幾天/上線後要退回重做的次數 |
下面這張圖,把現況一路連到做法與指標,箭頭也標上主要風險。可以一列一列看,確認每個選擇都有對應的問題,後面也取得到驗證資料。
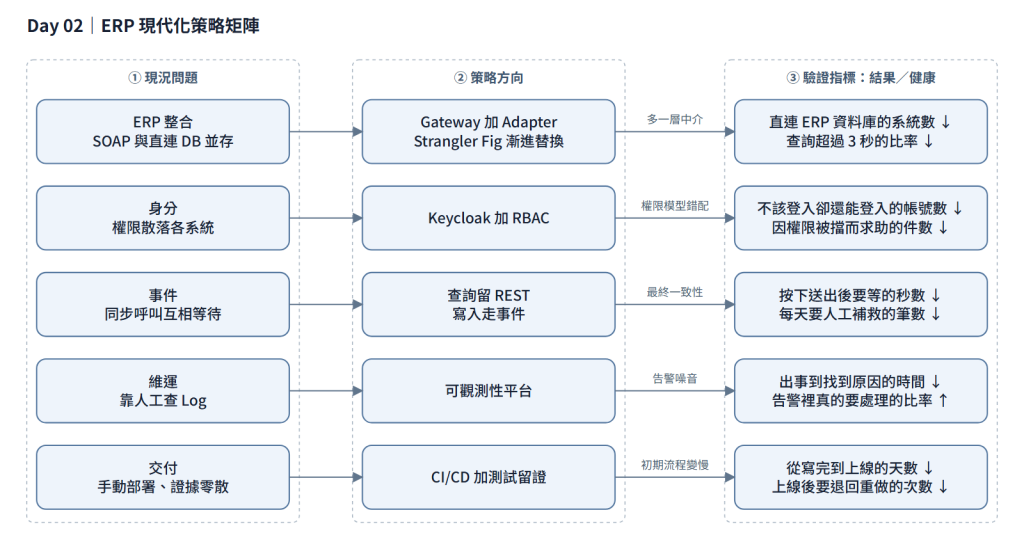
圖 Day 02-1:現況問題到驗證指標的對照。指標欄各留一個結果指標與一個健康指標,箭頭標籤為該策略的主要風險。
要安排資源的主管、要確認責任的架構師,以及之後接手維運的人,都需要用到這張表。所以我希望它不只工程師看得懂,像 P95、DLQ 這些名詞,也要補上它們和日常作業有什麼關係。
只看漂亮的數字,不夠踏實。所以指標一開始可以少一點:我會先放一個結果指標,看看事情有沒有改善;再放一個健康指標,看看改善的過程有沒有增加別人的負擔,兩邊一起看。
有一件事,我自己會特別提醒:討論很容易變成一份越列越長的工具清單。所以每個工具,都要找得到它要處理的問題;先把現況寫清楚,再選做法。
選好 Gateway 與 Adapter 之後,還要想移轉的順序。哪些介面先走新平台、哪些暫時保留,以及什麼情況需要退回去,都要寫進策略裡,時程才排得下去。
後面的人接手,要找得到當初的理由,以及資料是從哪裡來的。所以討論出來的結論與指標定義,再留到 ADR 或指標規格裡。
表上的說法可以簡單,但背後的計算要清楚。我會把給主管看的描述,和工程上真正要量的資料對在一起:
| 矩陣上的說法 | 工程上實際量的東西 |
|---|---|
| 查詢超過 3 秒的比率 | Gateway 與 Adapter 分段的延遲分佈,等價於 P95/P99 的 SLO |
| 不該登入卻還能登入的帳號數 | 離職與轉調後未回收的 role binding,搭配定期越權測試 |
| 因權限被擋而求助的件數 | RBAC 角色設計過細或錯配的直接症狀 |
| 每天要人工補救的筆數 | DLQ 深度、重送次數、consumer lag |
| 出事到找到原因要多久 | MTTR,拆成偵測、定位、修復三段 |
| 上線後要退回重做的次數 | 部署失敗率與回退次數,也就是 change failure rate |
表中的 3 秒是示例門檻,實際值要與使用單位確認,並記錄適用流程與量測範圍。確定門檻後,再以逾時請求比例與 P95 等數字檢視。同一份指標必須使用一致的樣本與統計方式,才有辦法比較。
少數請求可能因連線池耗盡,或 Adapter 等待 ERP 回應而明顯變慢,平均值卻未必反映出來。所以延遲不能只看平均值。指標變差時要能確認是哪一段需要處理,量測時也要分開記錄 Gateway、Adapter 與 ERP 的耗時。
寫指標之前,我還會多確認一步:資料從哪裡來?留多久?之後查不查得到?如果這些都還沒準備好,就先把資料收集列成工作,這個數字才有機會真的算出來。
之後每月或每個里程碑,再更新一次基準值、目前值、證據連結與剩下的風險。拿其中一個面向展開,可以這樣記錄:
YYYY-MM 盤點,直連 ERP 資料庫的系統 N 個、SOAP 介面 M 支N' 個(本期收斂 X 個)A 系統的報表查詢尚未改走 Gateway,預計 YYYY-MM 前處理若目前拿不到基準值,就先把盤點清單、API inventory 與 Log 集中收集列為交付項目,指派負責人與完成期限。量測準備可以在平台建置前開始。
矩陣本身也是需要維護的產出,採用前應先確認以下取捨:
| 取捨 | 這樣選的理由 | 何時要重新評估 |
|---|---|---|
| 每個面向只留一個結果指標與一個健康指標 | 指標過多會稀釋注意力,蒐集與解讀成本也會上升 | 兩個指標已無法判斷改善或副作用時 |
| 欄位採非技術說法 | 讓核准者與使用單位能參與同一份討論 | 說法與工程量測對不上,出現各自解讀時 |
| 每月或每個里程碑更新 | 與實際進度對齊,矩陣才有決策價值 | 維護成本高於決策價值時,改為僅於里程碑更新 |
| 先用現有可得資料建立基準 | 等待完整資料會讓量測無法開始 | 資料品質不足以支撐結論時 |
指標也會影響大家做事的方式。假如只要求結果達標,背後卻多了很多人工補救,這份改善就需要再想一想。這也是我想保留健康指標的原因。
目標可以隨業務條件調整,只是調整的原因、影響與確認人也要留下來。這樣再回頭比較,就知道中間發生過什麼變化。
要確認狀態是否真的改變,矩陣的每一列都要能連到可查閱的證據:
| 驗證項目 | 證據來源 | 想回答的問題 |
|---|---|---|
| 直連收斂 | 架構盤點、API inventory、Gateway 路由表 | 未經治理入口的舊路徑是否真的減少? |
| 權限正確性 | 權限測試紀錄、role binding 盤點 | 不該登入的帳號是否確實被擋下? |
| 回退可行性 | 故障演練與回退演練紀錄 | 回退條件是否真的能執行,而非只寫在文件上? |
| 交付效率 | pipeline 紀錄、部署與回退記錄 | 前置時間與回退次數是否可取得? |
| 效能瓶頸 | Gateway、Adapter、ERP 分段延遲 | 變慢時能否指出是哪一段? |
若既有品質流程已保留相關紀錄,可以直接建立對應關係,減少重複整理。初期不必補齊全部項目,但每一列都應標明目前狀態、負責人與預計完成時間。
整理完這張矩陣,我希望每個方案都能說得清楚:為什麼做、要承擔什麼,以及怎麼知道做得有沒有效。下一篇,再一起把量測方式與成功指標整理得更具體。


 iThome鐵人賽
 看影片追技術