
RAG 的運作可拆解為檢索(Retrieval)與生成(Generation)兩個階段。使用者提出問題後,系統首先在外部知識庫中檢索與問題相關的內容,接著將檢索結果與原始問題一併作為輸入,交由語言模型生成回應。此流程的效果類似於開卷作答,回答的依據並非全然仰賴模型內部的知識,而是取決於當下所取得的參考資料是否充分且正確。
這也意味著,RAG 系統的表現同時受兩個階段的品質所影響:檢索階段能否找到真正相關的內容,以及生成階段能否正確理解並運用這些內容作答。兩者之間並非各自獨立,即使檢索找到了正確資料,模型仍可能誤讀或忽略;反之,若檢索本身出錯,後續生成的內容再通順,也只是建立在錯誤基礎上的合理。
從「檢索到相關資料」到「模型正確理解並運用資料」之間,實際上涉及一連串相互銜接的處理環節,整體流程如下圖所示。大致可分為資料的前處理與切分、向量化與儲存、檢索與重排序,以及最終的組裝與生成,後續文章將針對每個環節逐一介紹。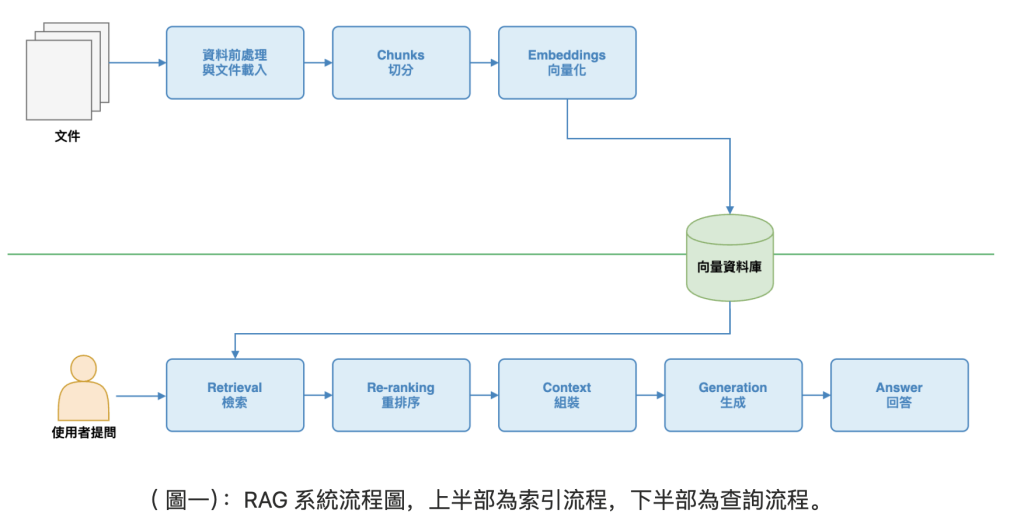


 iThome鐵人賽
 看影片追技術