
我們都知道啟動一個 Spring 的系統之後,Java 會將帶有 @Controller, @Service ...等 @Component 註解的類別,轉換為單例 Bean 運行。但如果我們往深一點的地方看,可以發現將 Java 檔案轉換成 Bean 的操作並不只是單純的 Object bean = new Component(); 而已。
細節一點來說:Spring 框架並不會看到一個 @Component 類別,就迅速將它變成一個可以使用的 Bean。這樣做除了會導致複雜的依賴關係很難被處理之外,因為有 @Conditional, @Property ...等註解的存在,掃描後立刻創建也容易發生建完 Bean 卻完全不會用到的資源浪費。因此,Spring 最後採用的解決方法是解耦「掃描」和「創建」這兩個流程。
在掃描階段,Spring 會先檢視專案內所有可能是 Bean 的檔案,並將它們儲存成定義檔 BeanDefinition(後續簡稱 BD),待掃描結束之後,Spring 才會回頭檢視這些 BD,並根據系統實際的需求(像是有沒有被其他 Bean 依賴、環境資訊有無對應、是否 lazy-loading、是否需要立刻初始化 ...等),把當前需要用到的 BD 一個個實例化成可用的 Bean。
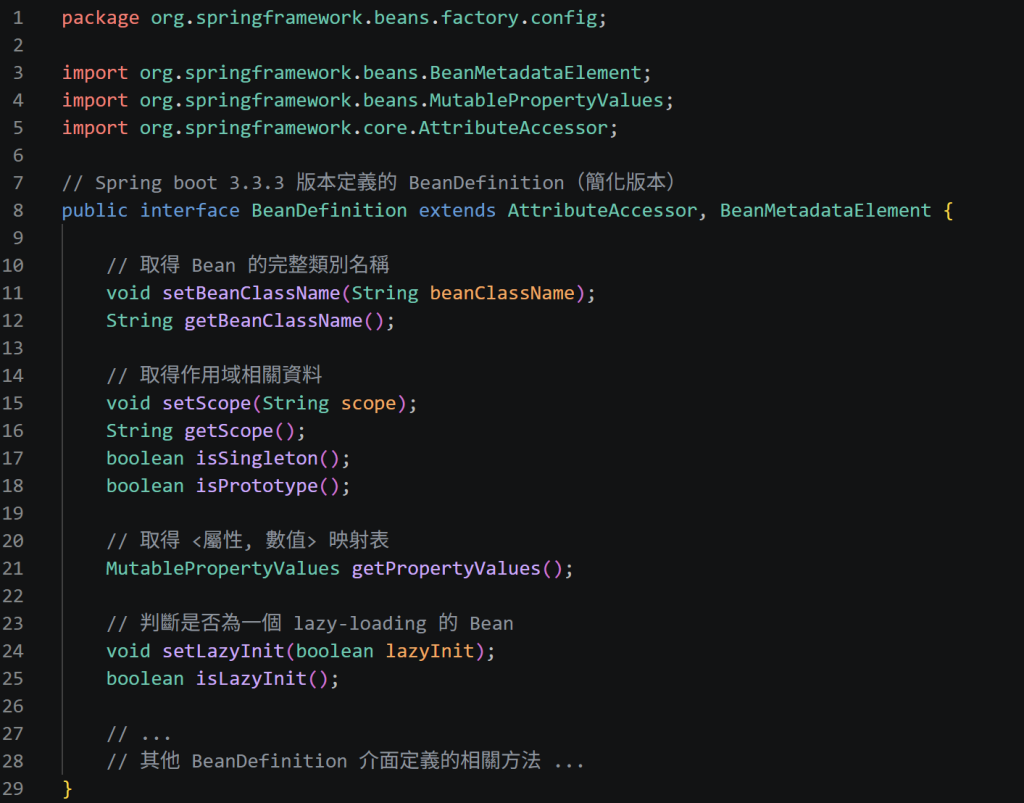
BeanDefinition 本身是一個介面,內部定義了一系列「一個 BD 應該要提供哪些功能」的方法規範,例如取得 Bean 的完整類別名稱、取得 singleton, prototype ...等 Bean 的作用域、取得 Bean 的 <屬性, 數值> 映射表、或是否為一個延遲載入的 Bean ...等。實務上,Spring 會透過其他組件的協助,將不同來源(像是從專案內、從依賴包、從 XML 配置 ...等)的 Java 檔案轉換成不同的 BD 實例,後續再透過其他的執行階段,將這些 BD 一個個轉換成真正的 Bean 物件。
另外,這裡可以提個小東西:在一般坊間的書籍或文章裡面,我們並不會把 Bean 的建立流程只分為掃描和創建兩個階段,這樣分有點太粗糙了。細節一點講:我們會把創建額外再拆出 3 個階段,並微調掃描的名稱,使創建流程變成組件掃描、實例化、參數賦值、和初始化四個步驟,這就是我們一般在說的「Bean 的創建週期」。後續也會很頻繁地提到,有餘裕的話,讀者可以先簡單記憶一下。
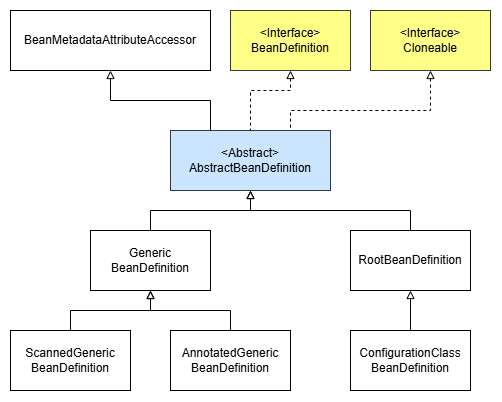
Abstract-Bean-Definition(簡稱 Abstract BD)是 Spring 中大多 BD 實作的共同父類,負責的工作有仨:第一是實作 BD 介面裡面的那些方法定義,透過在父類別上實作共用方法,免去不同子類需要重複造輪子的冗餘邏輯;第二是追蹤 Bean 的原始定義與擴展元資料。透過繼承 Bean-Metadata-Attribute-Accessor,Abstract BD 具有來源追溯(能知道定義來自哪裡)和屬性掛載(能動態增加 BD 裡面的鍵值屬性)這兩項能力。
第三是具備深拷貝的複製能力:透過實作 Cloneable 介面,Abstract BD 具備了高效的自我複製能力,這點在一般的靜態配置比較不會用到,主要的應用場景是在繼承或加工 Bean 定義上。常出現在 XML 的父子 BD、或者是 Merged BD 上(這個下面會講)。透過複製既有的 BD 來建立需要用的 BD,是比起每次都從頭重新構建還要更有效率的安全做法。
在現今的環境下,我們在開發上比較常遇到的實體 BD 大致有 4 種:Scanned-Generic-Bean-Definition 是透過組件掃描所產生的 BD,一般用來記錄標註 @Component 的相關類別,是專案裡最常見的一種實體 BD;Configuration-Class-Bean-Definition 是專門處理被 @Bean 方法標記的 BD,@Configuration 裡面的 @Bean 就是用這個實體 BD 紀錄的;Annotated-Generic-Bean-Definition 負責那些主動指定的、不透過掃描發現到的 Bean 類別。一般用來把 main() 方法的主類別、@Import 註解、或 context.register() 的類別參數變成實體 BD。
Root-Bean-Definition 則是 Bean 後續實例化時的統一標準。當 Spring 的流程進入創建階段之後,為了讓後續的系統組件不需要應付各類 BD 之間的實作與差異,Spring 內部會呼叫一個特殊的 merge 方法,將原本不同的 BD 實例調整為 Root-Bean-Definition 快取起來,作為後續實例化、依賴注入的標準依據。
最後,總結一下這篇提到的內容:BeanDefinition 就是 Spring 用來描述「一個 Bean 該長什麼樣子」的規格書,它用來將「配置」與「創建」這兩件事徹底解耦,讓 Spring 在建立物件之前,能夠先有一份標準化的資料進行查詢與加工。而在具體的實作上,Spring 則會根據不同的來源資料(像是掃描到的、@Bean 標註的、或者是主動設定 ...等),封裝成不同的實體 BD,並透過後續的流程,將它們統一收斂成 Root BD,作為後續系統組件用來實例 Bean 的簡單依據。
至於 Spring 是怎麼掃描和儲存 BD 的?在這之後又會怎麼做?還有在開始查找 BD 之前是不是還有什麼前置工作需要完成的 ...要回答的問題目前還跟山一樣多,但問題不大,因為我們還有 28 天的時間,明天第三天,我們先解決「Spring 是怎麼掃描和儲存 BD」的這個問題,而其他的內容,同樣會在往後的文章慢慢解答。
期待後續各位的閱讀與分享,我是 Pax,我們明天見。


 iThome鐵人賽
 看影片追技術