
Chunking 完成後,每個片段仍然是一段文字,而電腦本身並不理解文字的「意思」,它能處理的只有數字。Embedding(嵌入) 要解決的正是這個問題:將一段文字轉換為一組固定長度的實數向量,並且讓這個轉換具備一個關鍵特性——語意相近的文字,其向量在向量空間中的距離也會相近。透過這個轉換,「兩段文字意思像不像」便從一個難以量化的語言學問題,變成一個可以直接計算的數學問題,例如計算兩個向量之間的餘弦相似度(cosine similarity)。
這個特性使得檢索的方式與傳統關鍵字搜尋有本質上的差異。關鍵字搜尋依賴用字是否精確匹配,使用者的提問若與文件用字不同,即使語意相符,也可能檢索不到;向量檢索比對的則是語意本身,使用者以不同措辭、同義詞,甚至換句話描述同一件事,只要語意相近,其向量在空間中的位置依然會靠近原始內容,因此依然能夠被檢索到。這正是 RAG 系統得以處理「使用者提問方式與文件原文用字不同」這類常見情境的基礎。
選擇 Embedding 模型時,有幾項實務考量。首先是向量維度:維度越高,通常語意表達力越好,但相對的儲存空間與計算成本也隨之提高。其次是多語言支援程度:若知識庫以中文為主,需特別確認模型對中文語意的表達品質,並非所有模型在各語言上的表現都一致。第三則是部署方式的選擇——採用開源模型自行部署,可避免資料離開自有環境,但需要額外的運算資源與維運成本;呼叫商用 API 則部署簡便,但需將文件內容傳輸至外部服務,在資料隱私與延遲上須一併評估。
每個片段轉換為向量之後,仍須有能力儲存大量向量、並在使用者提問時快速找出最相似的內容,這牽涉到向量的儲存與檢索方式。此外有一點容易被忽略但十分關鍵:索引階段用來轉換文件片段的 Embedding 模型,與查詢階段用來轉換使用者提問的模型,必須是同一個模型。若兩者不一致,即使個別轉換過程都正確。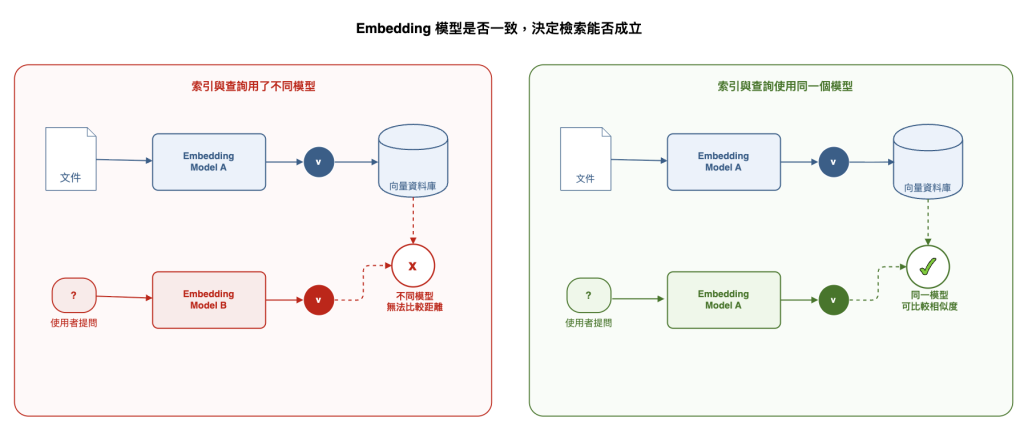
這項前提看似基礎,卻是後續評估檢索品質時必須先確認的基本條件,任何檢索結果的分析都建立在這個假設成立之上。


 iThome鐵人賽
 看影片追技術