
使用者提出問題後,這段文字同樣需要先經過向量化,透過與索引階段相同的 Embedding 模型轉換為向量,才能與向量資料庫中的內容進行比較。檢索(Retrieval)階段的任務,便是在這個共同的語意空間中,找出與提問向量距離最接近的片段,並將其回傳作為候選內容。
多數系統會設定一個 Top-K 參數,也就是只回傳相似度最高的前 K 筆結果,而非整個資料庫的排序清單。K 值的選擇需要權衡:設得太小,可能遺漏語意相關但排序稍後的內容,導致後續生成階段缺乏足夠的資訊;設得太大,則會引入較多不相關的片段,不僅增加後續處理的運算負擔,也可能稀釋真正關鍵的內容在整體脈絡中的比重。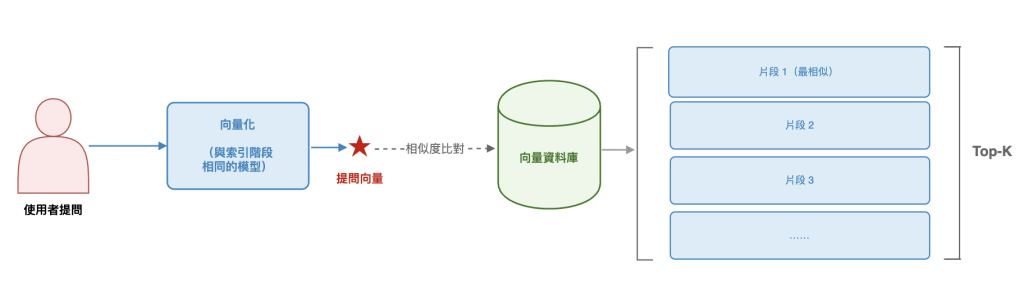
純粹依賴向量相似度的檢索,在面對精確詞彙時也有其限制。向量化著重的是語意層面的相近程度,對於特定名詞、代號、數字等需要精確匹配的內容,語意上相近的片段未必包含這些確切字詞。因此許多系統會採用混合檢索(Hybrid Search),將向量搜尋與傳統關鍵字搜尋(如 BM25)的結果一併納入考量,讓語意檢索與精確匹配兩種能力互補。
檢索階段完成後,系統手上會有一份依相似度排序的候選片段清單,但這個排序僅反映向量空間中的距離關係,未必等同於片段對回答問題的實際幫助程度,這也是這份初步候選清單仍需要進一步篩選與調整的原因。


 iThome鐵人賽
 看影片追技術