
來做個小實驗吧!我們實際來試看看自己透過 BPE 建立一個分詞器(Tokenizer),接著用我們訓練好的分詞器進行分詞(Tokenize)看看。這次我使用的是 Google 所開發的 SentencePiece 開源工具,這是一個專為神經網路與語言模型設計的開源分詞系統,它主要具備兩個功能:
.model 與 .vocab )。也就是說,從編寫字典到實際切分文字,整個流程都可以靠它一手包辦。當中支援的訓練方法也包含了昨天說的 BPE 與 Unigram 等等。
要做分詞實驗,首先需要訓練語料。我們就截取「Google 維基百科繁體中文條目」(約 5,800 字)來當作我們的訓練語料庫,裡面各種中英夾雜,是個很好的訓練資料。我所設定的字典大小是 5000 個詞,所以當它收集到第 5000 個最熱門的詞後就會停止收集。
import sentencepiece as spm

spm.SentencePieceTrainer.train(
    input="data/corpus.txt",
    model_prefix="models/model",
    vocab_size=5000,
    model_type="bpe",
    character_coverage=1.0,
    byte_fallback=True,
    remove_extra_whitespaces=False,
)
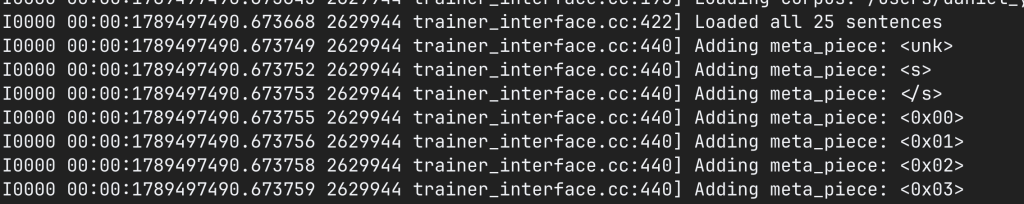
執行後,會印出 SentencePiece 底層 C++ 的 log,越上面是越早產生的 Token,最一開始它會先把自然語言處理常見的 Token <unk>、<s>、</s> 以及 <0x00>、<0x01> ... <0xFE>、<0xFF> 放到分詞器模型裡,也就是昨天提到的「字典非常薄」的階段。
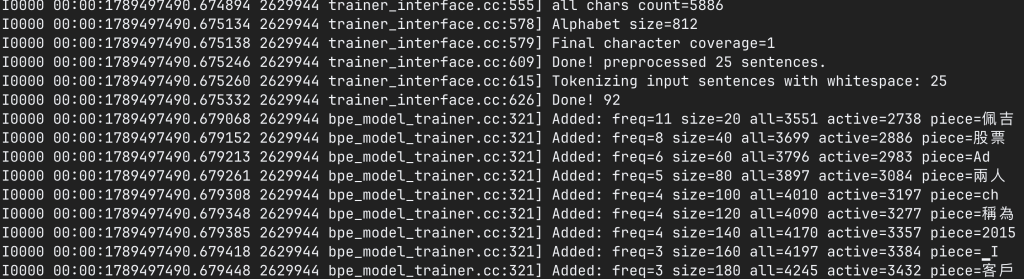
接著開始把各種最常見的字或詞合併,慢慢組出一本有 5000 個詞彙的字典,這就是我們的分詞器模型。可以看到它會把像是「佩吉」、「股票」、「搜尋引擎」等高頻相鄰字元逐步合併成新詞。其中的 5886 是原本 wiki 的字數,整個訓練過程只花了大約 18 毫秒就能生成完成。
打開生成的詞表檔案,可以發現每一列後面都有一個數字,值的範圍是小於等於 0 的數字,這數字代表 BPE 依合併頻率給予的優先級分數(Rank),越小表示越後面進去,表示分數越低,也代表出現頻率較低,而行號才是真正的 ID。整份詞表呈現清楚的三層結構:
<unk>, <s>, </s> 等控制標記。<unk> 0
<s> 0
</s> 0
<0x00> 到 <0xFF>。這是 UTF-8 的純 Byte 保底,確保遇到任何字典沒收錄的字元時都不會崩潰,因為最壞狀況就是靠 UTF-8 把字元組回來。...
<0x00> 0
<0x01> 0
<0x02> 0
...
<0xFD> 0
<0xFE> 0
<0xFF> 0
...
le	-0
og	-1
oog	-2
oogle	-3
Google	-4
20	-5
公司	-6

...

創始人	-135
在網路	-136
旗下的	-137
2011	-138
2015	-139
▁199	-140
作業系統	-141

...

一張十萬美元	-2159
上市不會影響	-2160
不作惡的哲學	-2161
並在內部部落	-2162
並得到了保羅	-2163
中國人工智慧	-2164

...

頓	-4735
願	-4736
馬	-4737
駕	-4738
麻	-4739
齡	-4740
仔細看會發現 ▁199 前面有個小方塊符號,這其實是 SentencePiece 用來跳脫空白鍵的設計,讓它可以把空格當普通字元合併,以方便之後還原回去。
當中 UTF-8 可能就是另外一個故事了,UTF-8 這種編碼方式是現今最常見的編碼方式,他幾乎涵蓋了所有的字。至於他的運作原理,網路上已經有很多大神講的非常好了,如果大家敲碗的話,有機會我再整理看看「我所看見的 Unicode」吧 XDD。現在只需要知道,既然他用 Byte 來當最小的 token,UTF-8 就是用 1 到 4 個 Byte 的組合來進行編碼的。所以一段看不懂的句子,不論是哪一種語言或是 Emoji,最壞情況都能被拆解成 1 到 4 個 Byte。所以分詞器的 Token 至少都包含了所有 Byte,就可以透過 UTF-8 來解碼,最壞情況就是用 4 個 Token 來表示一個字,幾乎不會有這個分詞器沒辦法處理的句子。
我嘗試將模型大小設成 500,結果系統直接噴 Vocabulary size is smaller than required_chars. 500 vs 1071。原因在於這篇維基語料中出現了 812 個「相異」字元,加上開啟 byte_fallback=True 所強制加入的 256 個 UTF-8 byte 保底與特殊控制符號,基礎字元就佔了 1,071 個位置。字典容量若小於 1,071,連基礎字元都裝不下,因此報錯。
接著我嘗試將模型大小設成 50,000,結果系統提示最大只能設到 8,007。這是因為 BPE 每合併一次,文本序列長度就減少 1。在這篇 5,800 多字的文章中,加上標點符號隔離與長度限制,所有可能產生的不重複子字串在去重後總共只會有 8,007 種。語料庫規模有限時就根本無法從中生出更多詞彙。
我們在推論時刻意輸入以下三種句子,來刻意命中或沒命中我們分詞庫的詞,結果如下:
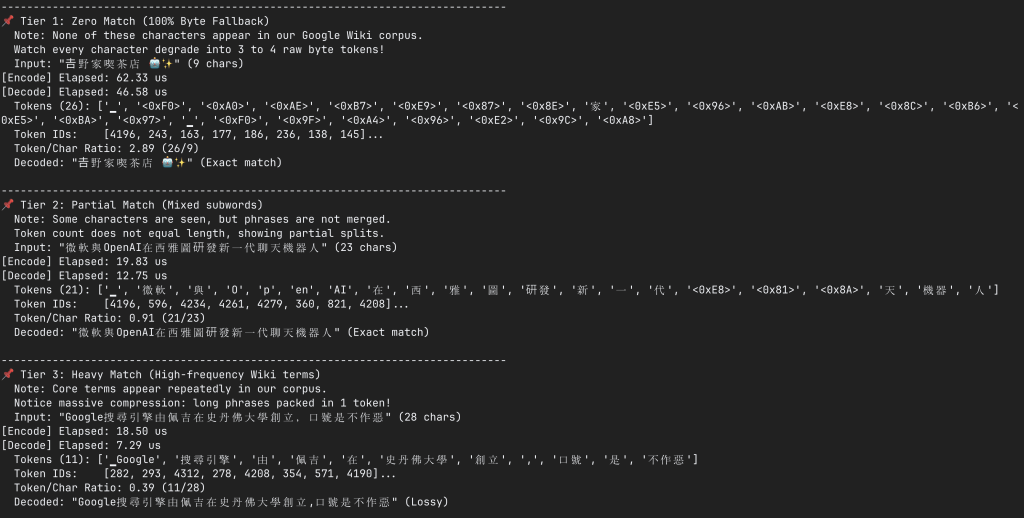
這裡也可以想像為什麼 一般使用 LLM 時,中文字時常比英文貴? 主要原因並不是因為中文 UTF-8 編碼要用比較多 byte 表示,而是因為當初 LLM 模型開發商在訓練分詞器時使用的語料中,英文的佔比遠高於中文。就如這兩天所說的,BPE 看的就是詞的「出現頻率」,所以中文在訓練語料中出現頻率相對少很多的話,被收錄進分詞器裡的中文詞彙就會比較少。雖然現代主流大模型為了照顧多語言,已經把字典擴充到十幾萬詞,讓常見中文單字大多擁有獨立的 Token,但多字成詞的比例依然遠低於英文,因此傳達相同資訊量時,中文往往需要耗費更多 Token,其他非英語的語言也常面臨類似的問題。
看完推論結果後,心中自然浮出一個問題:當一段長文字送進分詞器時,底層怎麼決定在哪裡切一刀當作一個 Token 的,哪裡該合併?這個演算法大家心中可能已經有個答案了,我們就留到明天繼續探討吧!明天見~


 iThome鐵人賽
 看影片追技術