
一、撐得了多久,是第三個問題
Day 1 說效能測試回答三個問題:撐得住多少人、多快回應、撐得了多久。前面二十三天幾乎都在前兩題上;第三題一直被放在後面,因為它最花時間——不是你的時間,是機器的時間。Soak test 的定義簡單到令人懷疑:用系統撐得住的負載,跑很久,看它會不會慢慢壞掉。
「慢慢壞掉」是關鍵。Load test 十分鐘內看不出來的問題有一整類:記憶體一點一點增加、資料庫連線一條一條沒還、暫存檔一個一個沒刪、log 一行一行把硬碟填滿。每一個都不會在第五分鐘出事,但在第五個小時,或上線後的第五天,系統會以一種和流量無關的方式倒下——這就是 Day 1 江蕙售票之亂之外,另一種更常見、更難查的上線事故:沒有人壓它,它自己慢慢死掉。
Soak 就是把那第五天壓縮成幾個小時,在上線前看到它。而今天要練的能力,和 Day 18 是同一套:你手上只有 k6 端的數據,伺服器在你看不到的地方;但曲線的形狀會告訴你它大概在漏什麼。
二、設計:時長、負載、窗口
時長怎麼訂。新手的直覺是「越長越好」,實務上錯的。時長由兩件事決定:第一,你懷疑的漏法多久會顯現——記憶體洩漏通常一兩個小時就看得出趨勢,連線池耗盡快則幾十分鐘,log 填滿硬碟要看硬碟多大;第二,系統的自然週期——有沒有每小時的排程工作、每天凌晨的批次、快取多久過期。時長要蓋過至少一個完整的週期,並且長到趨勢能和雜訊分開。練習環境(QuickPizza)30 到 60 分鐘足夠看出設計方法;到公司實際執行,2 到 4 小時是常見起點,過夜 8 小時是進階。沒有人一開始就跑 24 小時。
負載怎麼訂。不是 stress——soak 的負載是「系統確定撐得住的量」,通常取 Day 12 load test 通過門檻的那個 VU 數的六到八成。理由:你要看的是時間造成的劣化,不是流量造成的劣化;如果一開始就把系統壓在邊緣,兩種劣化混在一起,Day 18 的三條線索會全部纏成一團。平穩的負載,才能讓時間成為唯一的變數。
窗口怎麼安排。這是 Day 6 五問的長時間版本,而且更嚴格,因為你多半不會全程盯著:
• 告知範圍要擴大:不只是「我要壓測」,是「從幾點到幾點,會有 N 個 VU 持續存取,期間請不要重啟、部署或跑批次」——這三件事任何一件發生,soak 的數據就得作廢
• 避開系統的自然週期衝突:凌晨批次會讓回應時間出現一個和你無關的鼓包;要嘛避開,要嘛在報告裡標出來
• 施壓端要撐得住同樣久:Day 19 的四問在長時間下多一項——施壓機自己會不會漏?k6 的 --out json 跑兩小時,檔案會有幾百 MB;Day 20 教過用 --summary-export 或降低輸出頻率
• 資料要撐得住同樣久:Day 9 的參數化資料兩小時內夠不夠用?測試帳號會不會被鎖?產生的測試資料會不會把資料庫塞爆——這本身就是一種你製造的洩漏
腳本沿用 Day 14 的 journey,只改 stages:
export const options = {
  stages: [
    { duration: '5m',  target: 20 },   // 暖身:平緩爬到 soak 負載
    { duration: '50m', target: 20 },   // soak:固定負載,讓時間成為唯一變數
    { duration: '5m',  target: 0  },   // 收尾:觀察恢復
  ],
  thresholds: {
    http_req_duration: ['p(95)<800'],
    http_req_failed:   ['rate<0.01'],
  },
};
注意 thresholds 在 soak 裡角色不同:它們仍然是裁判,但今天真正要看的不是紅綠燈,是趨勢。一個全程綠燈但 p95 從 300ms 爬到 700ms 的 soak,是失敗的 soak——它在告訴你,第八小時會紅。
三、判讀:三個 k6 端的趨勢訊號
Soak 跑完,把 raw.json 依 Day 20 的方式分桶(五分鐘一桶就夠),畫出三條線:p95、錯誤率、rps。三條線各有一種形狀是警訊,每一種都對應伺服器端一類典型的洩漏。
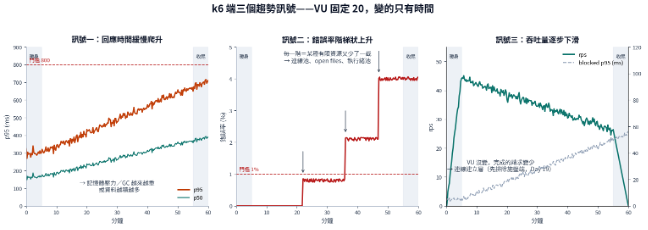
圖 1:k6 端三個趨勢訊號——負載平穩不變,變的只有時間,曲線卻在動
訊號一:回應時間緩慢爬升。負載沒變、rps 沒變,p95 卻像溫水一樣一路往上,沒有尖刺、沒有階梯,就是慢慢變厚。這是最典型的記憶體壓力訊號:記憶體被一點一點占住,垃圾回收(GC)越來越頻繁、每次越來越久,每個請求都被拖住一點點。另一個可能是資料越積越多——你製造的測試資料讓某個查詢越來越慢(Day 9 提醒過的清理問題)。分辨方式:看 p50 有沒有一起爬。GC 壓力通常 p50 和 p95 一起厚;資料量問題常常只有特定端點變慢,用 Day 15 的 tags 拆開就看得到。
訊號二:錯誤率階梯狀上升。前面一小時零錯誤,某一刻突然出現一批,然後維持在一個新的高度,過一陣子再跳一階。階梯的形狀表示某種資源「用完了」——最常見的是連線池:資料庫連線借出去沒還,池子一條一條變少,少到某個程度後新請求開始等不到連線而逾時。每一階就是池子又少了幾條。其他候選:檔案描述符(open files)耗盡、執行緒池滿、暫存空間用完。分辨方式:看錯誤的種類。Day 18 教過把錯誤按 status 和 error 分開,連線池耗盡多半是逾時或 5xx 集中在需要資料庫的端點;硬碟滿了則常常是寫入類端點先出錯。
訊號三:吞吐量逐步下滑。VU 數固定,但 rps 越來越低——因為每個請求越來越久,同樣的 VU 單位時間內完成的請求變少。這其實是訊號一的另一面,但有一種情況它會單獨出現:回應時間沒怎麼變,rps 卻掉了,同時 http_req_blocked 或 connecting 上升。那代表問題在連線建立那一層,可能是伺服器端的連線數上限、負載平衡器的連線表、或——Day 19 的老朋友——施壓機自己的連線用完了。先排除自己,再指向對方。
三個訊號整理成表,判讀時逐行對:
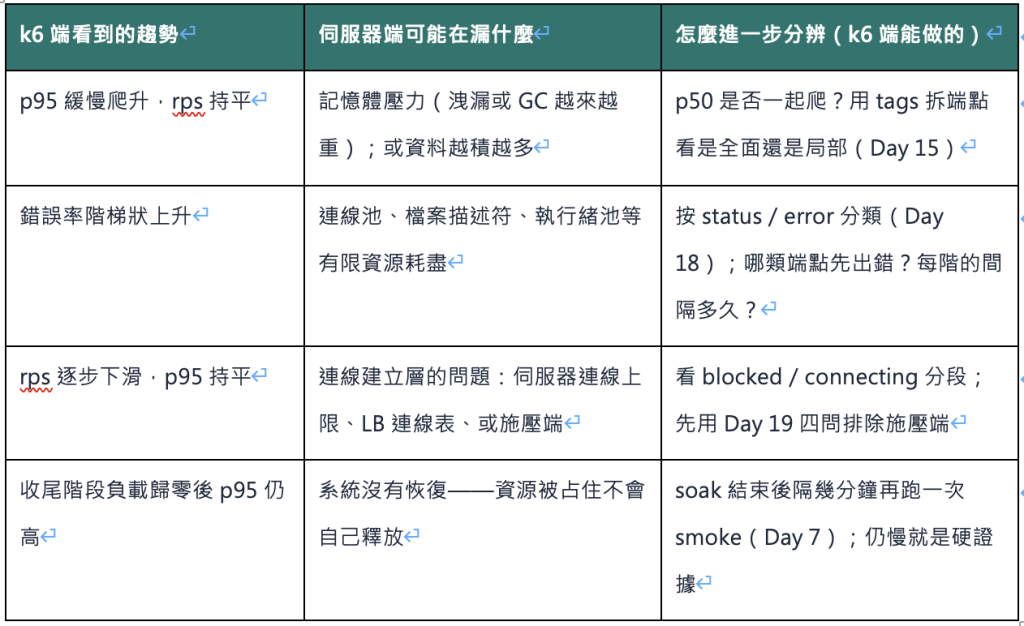
最後一列常被忽略,卻是最有力的一個:負載拿掉之後,系統有沒有恢復。正常系統在流量歸零後幾分鐘內回到基準;漏資源的系統不會,因為被占住的東西不會自己回來。這是你不需要任何伺服器端數據就能拿出的硬證據——Day 22 開單時,把「soak 結束十分鐘後 smoke 仍然 p95 650ms(基準 300ms)」寫進去,RD 很難說這是特例。
交給 Claude Code 分析時,把這張表的邏輯講給它:
Prompt 1|Soak 趨勢分析
請讀取 raw.json(60 分鐘 soak,5 分鐘暖身、50 分鐘固定 20 VU、5 分鐘收尾)。
1. 以 5 分鐘為一桶,算出每桶的 p50、p95、錯誤率、rps、http_req_blocked p95
2. 只看 50 分鐘固定負載那一段:對 p95、錯誤率、rps 各做線性趨勢,
   告訴我斜率與方向,並判斷是「持平」「緩慢爬升」「階梯狀」還是「下滑」
3. 依端點(tags.name)拆開,指出趨勢最明顯的前三個端點
4. 收尾段負載歸零後,最後一桶與第一桶的 p95 相比如何?
5. 對照這三種訊號與可能的洩漏類型,給我你的推測,
   每一條推測標註〔推論〕並說明我還需要向 RD 要哪一項伺服器數據才能確認
四、伺服器那一端長什麼樣子——以及該向團隊要什麼
你看到的是果,伺服器端的監控看到的是因。這個系列不架監控系統(承諾過的),但你至少要知道 RD 那邊的圖長什麼樣子,兩邊才對得起來。下面是一張示意圖——不是任何特定工具的截圖,而是幾乎每一套監控(Grafana、Datadog、CloudWatch、Azure Monitor)都會有的那幾條線:
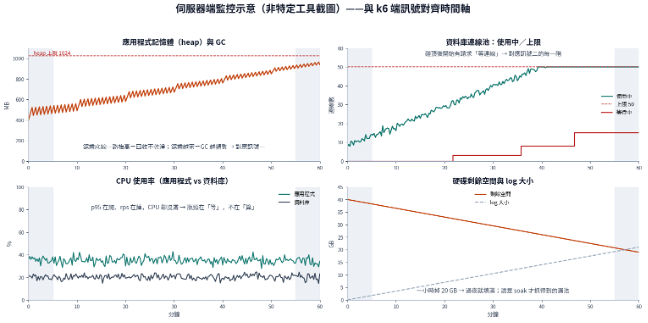
圖 2:伺服器端監控示意——同一段 soak,k6 端的訊號在這裡各有對應的「因」
對照的方式很直接:k6 端 p95 爬升的那段時間,伺服器端的記憶體是不是也在爬、GC 是不是越來越密;錯誤率跳階的那個時間點,連線池的「使用中」是不是碰到了上限;rps 下滑的時候,CPU 是不是反而沒滿——沒滿代表瓶頸不在運算,在等待。時間軸對齊,兩邊的曲線互相解釋,這才是完整的 soak 判讀。
所以到公司實際執行 soak 之前,帶著這份清單去找 RD 或維運:
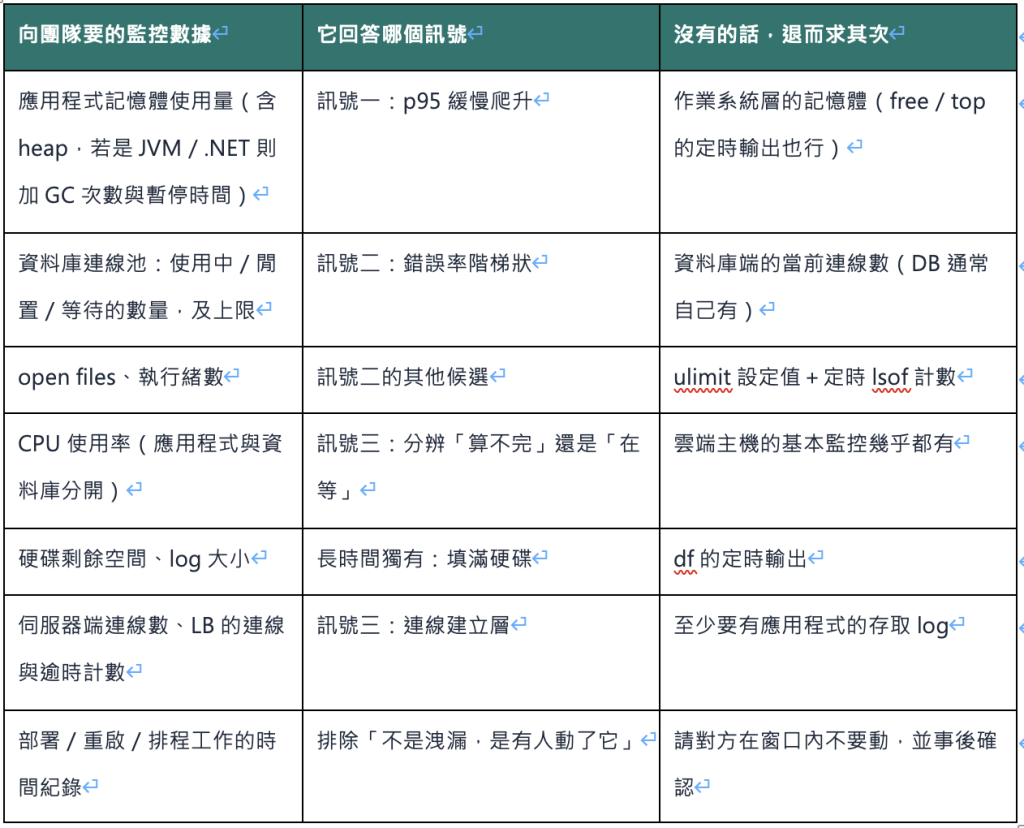
要這些數據的時候,說法很重要。不是「請幫我裝監控」,是「soak 從幾點到幾點,能不能請你在那段時間截這幾條線的圖給我,或者告訴我去哪裡看」。多數團隊已經有這些數據,只是沒人問過。你不架監控,但你知道該問什麼——這就是 QA 在 soak 裡的位置。
給 RD 的一句話:QA 來要 soak 期間的記憶體、連線池和 GC 曲線時,請把時間軸對齊了一起看:他的 p95 開始爬的那五分鐘,你的 heap 在做什麼?他的錯誤率跳階那一刻,連線池是不是碰頂?兩張圖對上,洩漏的位置通常就出來了;對不上,也排除了一大半。他還會告訴你負載歸零後系統有沒有恢復——那是最不需要爭辯的一項證據。
五、動手做:一次 60 分鐘的 soak
練習一:設計與告知。照第二節的原則寫下你的 soak 計畫:時長、負載(用 Day 12 load test 通過的 VU 數乘 0.7)、窗口、告知內容。練習對象是 QuickPizza,20 VU 一小時是可接受的上限,不要更高——Day 6 的禮儀在長時間測試裡加倍重要。
練習二:執行與分桶。跑起來,同時做兩件事:每十分鐘記一次施壓機的 CPU 與記憶體(Day 19 的習慣,這次要撐一小時);跑完立刻用 Day 7 的 smoke 再打一次,記下恢復狀況。然後用 Prompt 1 分析。QuickPizza 大概率三個訊號都持平——那也是結果:把「50 分鐘固定負載下三條趨勢斜率接近零、負載歸零後 p95 回到基準」寫成一段,這就是一份「撐得了多久」的正面證據。
練習三:對照題。沒有伺服器端數據也能練判讀。把圖 1 的三種形狀各想一個你公司系統裡可能的原因,寫下來;再從圖 2 挑出你會第一個去要的那條線,以及要不到時的替代方案。這份紙上作業就是你到公司執行 soak 前的準備。
六、注意事項:長時間測試的六個習慣
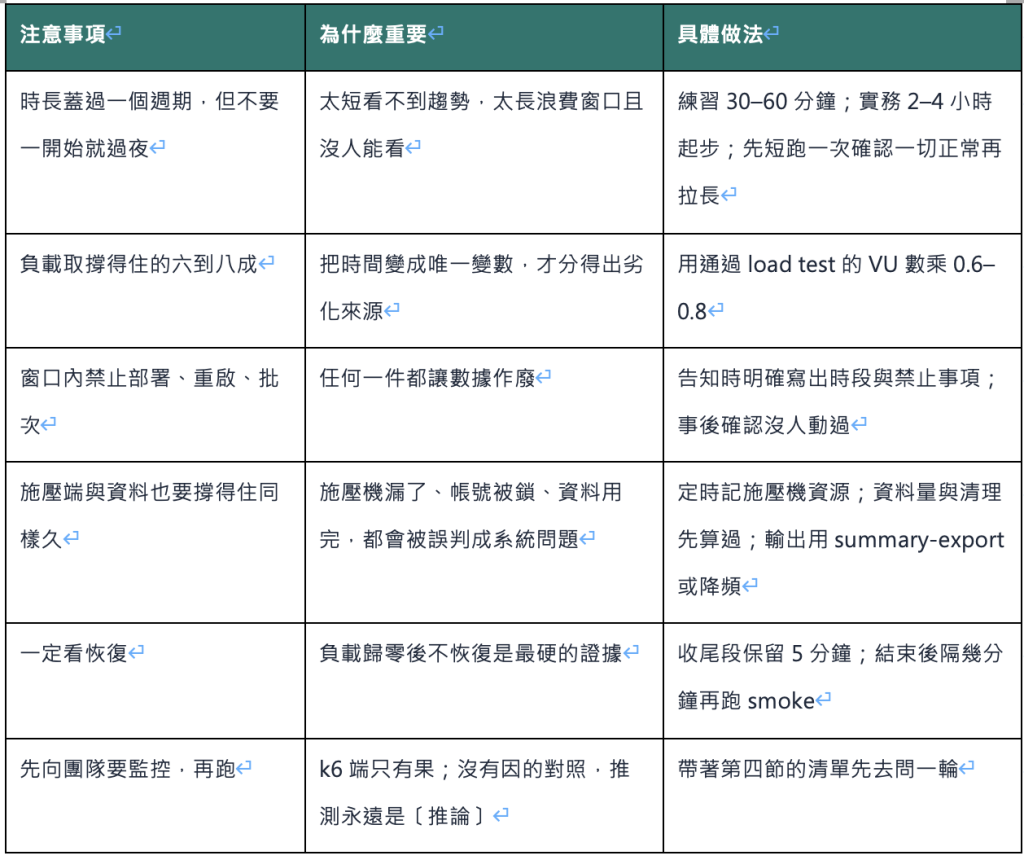
七、觀念驗證:三個問題確認你有帶走今天的重點
• Soak 的負載為什麼要取「撐得住的六到八成」而不是壓到邊緣?這和 Day 18 的三條線索有什麼關係?(第二節)
• p95 緩慢爬升和錯誤率階梯狀上升,各自暗示伺服器端在漏哪一類資源?在 k6 端要怎麼進一步分辨?(第三節)
• 為什麼「負載歸零後系統有沒有恢復」是最不需要爭辯的證據?到公司執行 soak 前,你會第一個向 RD 要哪條監控曲線?(第三、四節)
八、小結
撐得了多久,是三個問題裡最花機器時間、最少花你時間的一個:設計好時長、負載與窗口,剩下的交給時間。負載平穩不變,時間成為唯一變數,於是曲線的形狀就會說話:p95 緩慢爬升指向記憶體壓力,錯誤率階梯狀指向有限資源耗盡,rps 下滑指向連線建立層——而負載歸零後不恢復,是最硬的證據。你手上只有 k6 端的果,但你知道伺服器端的因長什麼樣子、該向誰要哪條線;架監控不是你的工作,問對問題是。明天處理另一種「本機辦不到」的情況:當你要的量本機根本壓不出來,雲端執行是什麼、什麼時候真的需要、以及為什麼多數團隊其實用不到——Day 25 見。


 iThome鐵人賽
 看影片追技術