
一、先把功勞算清楚
回頭看 Day 4:你用一段中文描述,拿到一支能跑的 k6 腳本。在沒有 AI 的年代,那一步是三週的 JavaScript 入門加上翻文件——多數測試人員就是在那三週裡放棄效能測試的。這個系列之所以能叫「不會寫程式我照樣做效能測試」,前提就是 Claude Code 把四類工作的成本壓到了接近零:
生成:Day 4 的第一支腳本、Day 9 的參數化、Day 13 的 scenarios、Day 23 的 workflow YAML、Day 26 的 browser 腳本、Day 28 的 SOAP 信封——每一個「語法我不會」的時刻,都是一句中文解決的。解釋:Day 4 立的規矩「生成後必問三個問題」,讓每段看不懂的程式碼都有人講給你聽,而且不會不耐煩。除錯:Day 11 整天在練的工作流程——錯誤訊息完整貼上、描述預期與實際的差異、一次只改一個地方——把「腳本壞掉」從放棄點變成了例行公事。分析:Day 18 之後,每一份 raw.json 的分桶、趨勢、分家,都是它算的;Day 21 之後,連報告初稿都是它寫的。
這四件事的共同點:它們都有標準答案,或至少有可以立刻驗證的答案。腳本跑不跑得起來、分桶算得對不對、YAML 的語法合不合法——對錯當場見分曉。AI 在這種題目上又快又好,而且會越來越好。
二、再把學費算清楚:這 28 天 AI 錯過的地方
但這個系列從 Day 4 到昨天,幾乎每一篇都埋著防 AI 的機關。把它們排在一起看,是一份很誠實的清單——每一條都是這 28 天裡真實出現過(或每個讀者遲早會遇到)的失手,以及當時人是怎麼接住的:
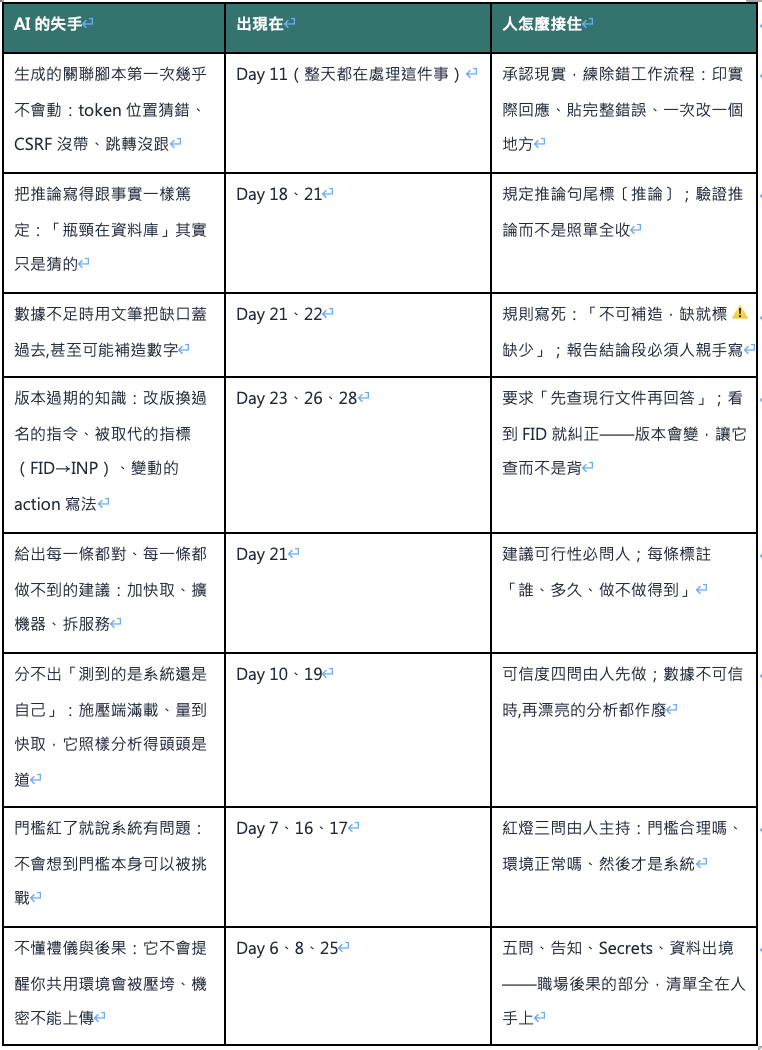
這張表值得多看一眼的地方是規律。AI 的失手不是隨機的,它集中在三種題型:沒有當場可驗的答案(推論、建議可行性)、答案會隨時間變(版本、指標定義)、答案在系統之外(業務、組織、禮儀、後果)。而它強的四件事——生成、解釋、除錯、分析——全都是「當場可驗」的題型。這條規律就是分界線的位置。
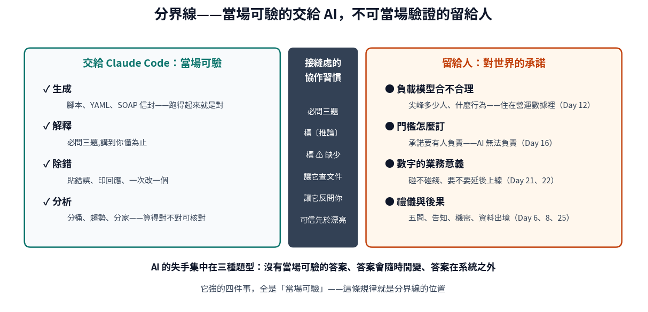
圖 1:分界線——當場可驗的交給 AI,不可當場驗證的留給人;接縫處是這系列教的協作習慣
三、分界線:三個永遠在人這邊的判斷
把規律說成三個具體的判斷——你會發現它們正是 Day 21 那三個「必須由人來下的判斷」的完整版,而且貫穿整個系列:
判斷一:負載模型合不合理。Claude Code 能生成任何你描述的負載——但「30 VU 爬五分鐘」這個描述本身對不對,取決於 Day 12 的推導:尖峰同時在線多少人、什麼行為組合、湧入速度多快。這些數字住在你的營運數據和業務常識裡,AI 沒有入口。給它錯的負載模型,它會用完美的語法忠實執行一場無意義的測試——垃圾進、精美的垃圾出。
判斷二:門檻怎麼訂。「p95 要小於多少」沒有技術上的正確答案——800ms 是 Day 16 從客服訪談、轉換率、同業水準推出來的,Day 17 還要依環境折算,Day 27 在負載下另訂。AI 可以告訴你「業界常見值」,但你的老闆不是業界平均,你的使用者也不是。門檻是承諾,承諾要有人負責,AI 無法負責。
判斷三:數字的業務意義。「/api/ratings p95 920ms」是事實;「所以要不要延後上線」是判斷。中間隔著:這個端點碰不碰錢、尖峰影響幾成使用者、修它要排掉哪個功能、上了之後誰半夜起來救火。這些權重在組織裡、在人身上——Day 21 的報告、Day 22 的開單、Day 23 的擋門決定,每一個關鍵處都寫著「這要問人」,不是客氣,是這題真的不在 AI 的資料裡。
注意這三個判斷的共同結構:它們都是「對世界的承諾」,不是「對數據的計算」。計算可以外包,承諾不行——因為被追問的時候,站起來回答的是你。
四、驗證瓶頸:為什麼判讀能力越來越值錢
把鏡頭拉遠一點,這 28 天的經驗其實是整個軟體業正在發生的事的縮影。
AI 讓「產出」的速度呈倍數增長:腳本幾秒鐘就有、報告初稿一分鐘就好、程式碼一天能生出過去一週的量。但每一份產出都要有人回答同一個問題:「這個對嗎?可以信嗎?」——而回答這個問題的速度,沒有跟著倍增。於是瓶頸移動了:從「做得出來嗎」移到「驗得過來嗎」。產出越快,判讀能力越是稀缺資源——這就是驗證瓶頸(verification bottleneck),你在這 28 天裡已經親身經歷過它好幾次:
Day 21 那個練習還記得嗎——AI 一分鐘寫好報告初稿,你卻要花半小時逐句決定「這句我真的同意嗎」。寫的時間塌縮了,讀的時間沒有;Day 15 的腳本審查、Day 22 的「⚠ 缺少」、Day 27 的四格判讀,全都是同一件事的不同形狀。這不是 AI 不夠好,是結構性的:生成可以並行加速,驗證的最後一關永遠通過一個人的理解。
對測試人員,這是這波變化裡最重要的一個消息,而且是好消息。效能測試裡「寫腳本」的門檻消失了——連帶地,「會寫腳本」不再是測試人員的護城河;但「看得懂數字、問得出好問題、扛得起結論」的價值,恰恰因為產出變快而上漲。這個系列的結構就是照這個判斷設計的:工具與語法(Day 1–15)用最快的速度帶過,判讀與溝通(Day 16 之後)才是重心——因為前者 AI 會了,後者是你的。
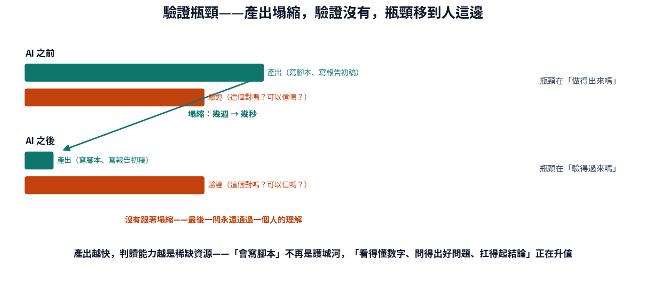
圖 2:驗證瓶頸——產出塌縮、驗證沒有,瓶頸移到人這邊;這正是判讀能力升值的原因
五、帶得走的協作習慣:讓 AI 自己標出弱點
最後把這系列反覆出現的協作技巧收攏。它們表面上是 prompt 寫法,底層是同一個原則:AI 最危險的不是錯,是錯得流暢——所以要在流程上強迫弱點現形。六個習慣,離開這個系列之後,用在任何測試工作上都成立:
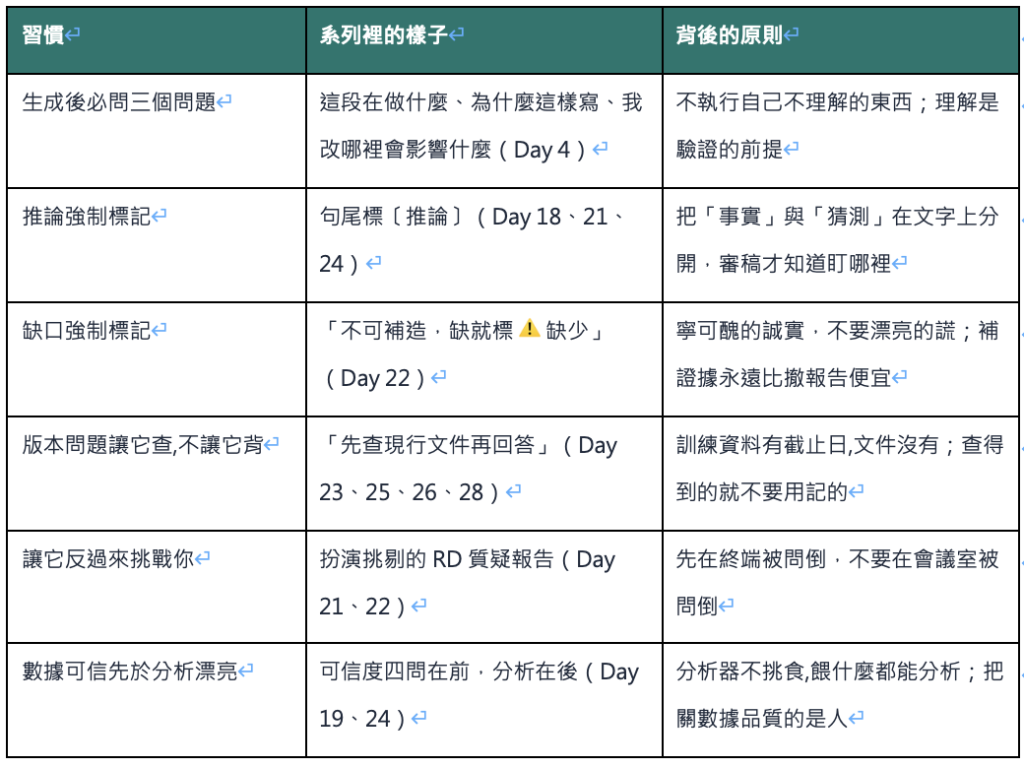
你可能已經注意到:這六個習慣沒有一個是「效能測試專用」的。功能測試請 AI 寫測項、自動化請 AI 生 Playwright 腳本、甚至 RD 請 AI 寫程式——同一套原則原封不動適用。這 28 天你練的其實是兩件事:效能測試,和「帶著 AI 工作而不被它帶著走」。第二件事的保存期限比第一件長得多。
給 RD 的一句話:這篇的分界線對開發一樣成立:AI 寫 code 又快又好,但「這個需求該不該做、做到什麼程度算好、上了誰負責」從來不在它手上。QA 練的「推論標記、缺口標記、讓 AI 自己挑戰自己」,code review AI 生成的程式碼時同樣好用——產出越快,你的 review 能力越是團隊的稀缺資源,這件事我們是同一條船。
六、觀念驗證:三個問題確認你有帶走今天的重點
• AI 的失手集中在哪三種題型?它強的四件事有什麼共同點?這條規律怎麼決定分界線?(第二節)
• 負載模型、門檻、業務意義這三個判斷,為什麼說它們是「對世界的承諾」而不是「對數據的計算」?(第三節)
• 什麼是驗證瓶頸?為什麼說它對測試人員是好消息?這個系列的結構怎麼反映了這個判斷?(第四節)
七、小結
這 28 天的帳算清楚了。Claude Code 把生成、解釋、除錯、分析的成本壓到接近零——凡是當場可驗的,它又快又好;而沒有當場可驗答案的、答案會隨時間變的、答案在系統之外的,是它的失手區,也就是人的位置:負載模型合不合理、門檻怎麼訂、數字的業務意義,三個判斷都是對世界的承諾,承諾要有人負責。產出塌縮、驗證沒有——驗證瓶頸讓判讀能力成為稀缺資源,這對願意練判讀的測試人員是明確的好消息。六個協作習慣帶走:必問三題、標推論、標缺口、讓它查、讓它反問你、可信先於漂亮——它們的保存期限比任何工具都長。明天是最後一天:把 30 天摺成一張地圖,檢核你已經能做什麼,然後看看三條往前的路——Day 30 見。


 iThome鐵人賽
 看影片追技術