

同一筆 case 跑完可以算出兩個數字,能當上線門檻的只有第二個,第一個留著看差多遠,改完 prompt 看的那份報表上兩個並列。
先接昨天的東西,被驗收的是一隻需求釐清 agent,它把需求方寫的雜亂 ticket 整理成四個區塊,Goal(這張卡要做什麼)、Scope in(做的範圍)、Scope out(不做的範圍)、AC 標註(標出有問題的那幾條 AC)。昨天判定交給程式,scorer 對這四個區塊各給一個過或沒過,優惠碼那張 ticket 第一次真跑,Goal 跟 Scope out 過,Scope in 跟 AC 標註沒過。
拿回來的不是一句過或沒過,是四個欄位各自的結果,這一筆到底算不算過,有兩種算法:
那張優惠碼功能的 ticket 有 7 條 AC,人工標完的期望標註是 4 個,第 3 條同時中了「彼此衝突」與「與描述不符」兩類。這筆 case 的 goal state 要判四個欄位,Goal 非空、Scope in 含三個關鍵詞、Scope out 含結帳頁效能、AC 標註的集合完全相同。
昨天第一次真跑,程式回的結果是這樣:
ac-conflict-001 判定結果

Goal        必須存在       過
Scope in    含三個關鍵詞   沒過(少了「後台建立」「過期處理」兩個詞)
Scope out   含結帳頁效能   過
AC 標註     集合完全相同   沒過(少 2 個,多 4 個)
逐條算是四個欄位過了兩個,50%,整筆算是 0,因為一個欄位沒過整筆就沒過。兩個數字算得都沒錯,而且是同一支判定程式、同一次執行給出來的。做到一半的一筆 case,長的就是這個樣子。
整筆算的規則在 scorer 裡只有兩行(src/scorer/goal-state.ts):
const graded = fields.filter((f) => f.pass !== null);
const pass = graded.length > 0 && graded.every((f) => f.pass === true);
graded.every 就是「一個欄位沒過整筆就沒過」,逐條算的數字則是 graded 裡 pass 為真的欄位數除以 graded 的長度,兩個數字讀的是同一份 fields。
手邊另一份跑完的實驗可以把這個距離拉得更開。這份實驗叫另一隻 agent 照一份寫作規範產出 Trello 卡片,4 個 case × 2 個 configuration × 3 次,共 24 次,單一變因是那份規範在不在輸入裡,判斷標準是一條一條寫進 metadata 的 assertion,附在各自的 case 上。
其中一個 case 寫了 16 條 assertion,規範放進輸入的那三次,每一次都有 1 條沒過、其他 15 條全過,逐條算是 94%,case 通過率是 0。把規範拿掉的那一組,逐條算的通過率 64%,4 個 case 沒有一個全過,case 通過率一樣是 0。
| 逐條算的通過率 | case 通過率 | |
|---|---|---|
| 優惠碼那筆 case 第一次真跑 | 50% | 0 |
| 那個 16 條 assertion 的 case | 94% | 0 |
| 把規範拿掉的那一組 | 64% | 0 |
| 這個數字回答的問題 | 離通過還差幾條 | 這份產出能不能交出去 |
24 次太少,這裡借的不是分數高低,是同一次執行上兩個數字的距離。逐條算分別是 50、94 與 64,而 case 通過率三次都停在 0。
門檻要用 case 通過率,理由是只有它跟下游收到的東西對得起來。需求方打開的是整張卡,不是半張卡,那張少了標註的卡看起來完全可以拿去開工,而漏掉的那條 AC 會照原文進 sprint。
94% 讀起來像「幾乎全對」,可是 case 通過率是 0,三次每一次都有一條紅。那一筆後來查出來是判斷標準寫反了,產出其實照規範做對了,但在查出來之前,報表上就是 94 跟 0,讓人停下來去查的是 0 那一欄,94 只會讓人放心送出。能不能交出去是整筆的事,門檻就要用整筆算的那個數字。
逐條算的通過率還有一個性質讓它不適合當門檻,它會被每筆 case 寫了幾條 assertion 牽著走。16 條的 case 掉一條是 6 個百分點,四個欄位的 case 掉一個是 25 個百分點,同樣是一筆沒過的 case,分數差了四倍。條數多的那幾筆會把整份資料集的平均拉高,而條數是人寫的時候順手決定的。
因為 0 只代表沒過,看不出差多遠,同一筆 case 從四個欄位全過掉到只剩一個,跟只掉了一個,case 通過率都是 0。改完 prompt 想知道這次是少過一條還是大半都沒過,只有逐條算的數字看得出來。
前幾天湊資料集時做的判別力檢查就是現成的例子。把「每一條 AC 對三類問題各檢查一次」那句指示刪掉,對同一張卡各跑三次,case 通過率兩邊都是 0,一動也不動,而作者標的 12 個標註裡 agent 標到的從 8 個掉到 5 個。只看門檻那一欄,會以為這次改動沒差。
兩個並列,動的方向才看得出來:
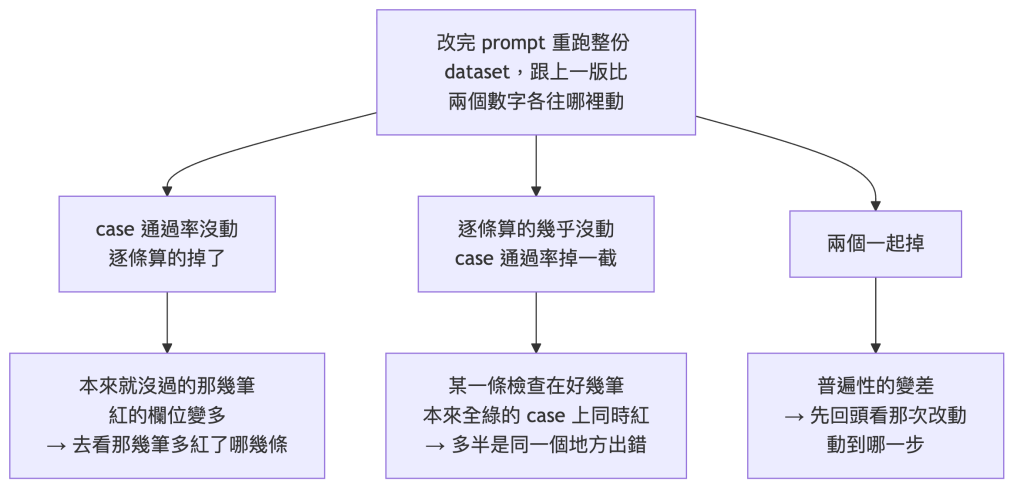
所以報表上兩欄並排,一欄負責擋,一欄負責告訴你去看哪裡。至於門檻要訂在幾分才准上線,得先知道漏掉一條跟多標一條各要付多少代價,那個代價還沒算。
上面那份 Trello 卡片的實驗值得多講一句,因為它評的東西是一張卡片的文字,沒有任何結構化的 store 可以讀出來逐個欄位比對。
即使這樣,那些 assertion 檢查的仍然全部是最後留下來的那份文字,某個欄位該不該出現、某一段有沒有寫到規範要求的內容,沒有一條在看它中間查了幾次、走了哪一條路。
常見的一種反駁是「我的任務沒有資料庫可以比對,所以只能看它的過程」。這份實驗就是反例,只評最終狀態靠的不是有一個資料庫,是有一份寫到能逐條檢查的完成的樣子。 卡片文字寫得出來,需求釐清 agent 整理出來的四個區塊當然也寫得出來。
一筆 case 跑完有兩個數字,報表上兩個並列,各管一件事:
還沒處理的是這兩個數字都把每一條紅當成同樣重的一件錯,而這隻 agent 漏掉一條真的衝突,跟多標一條不存在的問題,代價並不一樣。


 iThome鐵人賽
 看影片追技術