
昨天,我把審查方法整理成 Claude Code 可以使用的 skill,再包成 plugin。規則有地方放,下一次也不用從頭交代。
但如果現在有人問:「所以你省了多少時間?」我還答不出來,只能給他一個禮貌又不失尷尬的微笑。
Claude 執行多久,可以查紀錄。我花多少時間準備材料、核對判級、修正規則,卻沒有完整記下來。接下來還會繼續改,如果現在沒有留下起點,之後就算覺得更順,也說不清楚差在哪裡。
METR 2025 年對 16 位資深開源開發者做隨機對照:允許用 AI 時完成時間多了 19%,受試者事後仍覺得自己快了 20%。那是當年的工具與任務,數字不能套到現在;但「體感和實測可能反向」這件事不會過期。METR 研究
Day 1 問的是「工作有沒有變好」,Day 2 到 Day 4 圍著同一件審查工作,看 Claude Code 怎麼接、怎麼驗、規則放哪。第一幕最後這篇,先約定比較哪種工作、怎麼算,再開始蒐集。這把尺量的是交給 Claude 的工作,不限寫程式:機器花了多久、人花了多久、結果能不能接受,三件事分開記。
先用一組合成數字,把「早完成」和「少投入」拆開。以下全部是教學用的合成數字,不是公司工時,也不是 Day 4 案例的計時。
| 人工工作 | 原方式 | 加入 AI 後 |
|---|---|---|
| 理解背景 | 20 | 15 |
| 實作 | 30 | 10 |
| 審查 | 15 | 25 |
| 返工 | 5 | 20 |
| 合計(人分鐘) | 70 | 70 |
| 交付經過時間(分鐘,另計) | 240 | 180 |
實作少了二十分鐘,人卻沒有少忙:審查與返工把省下的吃回去了;交付倒是早了一小時。更早交付看經過時間,人工減載看人的投入。 只報實作時間會藏住負擔轉移,只報總投入會漏掉交付提早。
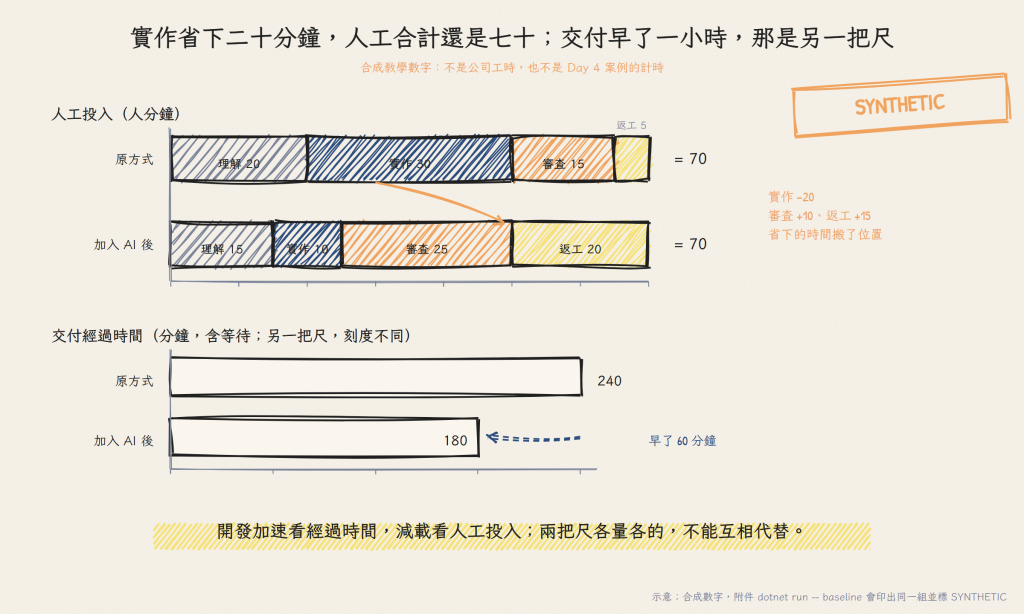
合成示範;經過時間另外設定,不是人工分鐘相加。
還有第三件事:品質。更早交出去卻不符合原本的接受條件,就不算同一種成果。三樣要一起看。
整段交付最後都要看,但先從前兩天反覆遇到、要人工查證的那一段開始:一輪小型 PR 審查。Day 3、4 看過 Claude 能交回發現,人還得核對來源;我想知道調整審查方法後,查證與補件有沒有少,重要問題有沒有漏。DORA 的價值流分析也是這個思路:把步驟攤開,找摩擦在哪。DORA
先把比較規則寫成「基線卡」。它現在是量測計畫,累積了目前做法的資料才成為基線。
| 基線卡欄位 | 本次示範如何約定 |
|---|---|
| 改善問題 | 審查時反覆補背景、找規則,想減少這些投入 |
| 工作範圍 | 先限一個專案的小型 PR 審查;開始前寫明大小與風險條件,核心 Domain 變更另列 |
| 目前做法 | 記提示範本、模型、effort、skill/plugin、CLAUDE.md 的版本 |
| 期間與名冊 | 填起訖日期;期間內符合條件的審查都列入,含卡住、取消與未完成 |
| 流程時間 | 送審到人工核對完成,由明確事件取起訖,不含送審前準備 |
| 人工投入 | 抽樣記理解、操作、審查、返工,包含送審前準備;等待另記 |
| 品質條件 | 重要發現對得回來源、未知有標示;另記誤報與人工找到的漏項 |
| 使用界線 | 事前說明用途、期間、欄位、誰能看、保存多久;不作個人排名 |
| 缺值處理 | 未記標未知;報符合條件件數、完整紀錄件數與缺漏 |
計時前再約定三件事:
我翻出訂單取消案例的一次審查紀錄。Claude 花了約二十五秒,交回六條需要核對的發現。
有的在問規則在哪裡,有的指出假設還沒確認,也有的提醒呼叫端和測試證據沒交代。六條都有可追查的位置:
| 嚴重度 | Claude 指出的內容 | 來源 |
|---|---|---|
| block | 作者自評判級為 low,且勾「以上皆非」而非「狀態轉換規則」 | PR.md:25 |
| block | 新增假設「已出貨時不丟例外、已取消再取消視為無事發生」未經確認 | PR.md:14–15 |
| ask | 規則位置未填 | PR.md:6 |
| ask | 驗收預期的規則依據未填 | PR.md:10 |
| ask | 呼叫端與尚未驗證的路徑未填 | PR.md:18–19 |
| ask | 「七組情境十八個斷言 PASS」是唯一的驗證證據 | PR.md:11 |
看起來已經替我做了不少事。
但接下來呢?我讀懂這六條花多久?哪些需要回頭找規格?補件後又查了多久?紀錄沒有寫。
把這次交付攤開,差別就很清楚:
| 想知道的事 | 這次留下了什麼 |
|---|---|
| Claude 花了多久? | 約二十五秒,實際為 24.967 秒 |
| 它交回什麼? | 六條查核線索,要求 Owner 確認;不等於六個已確認的缺陷 |
| 工具花費多少? | 五回合,費用估值約 US$0.0627,不含人的成本 |
| 我花多少時間讀材料、查證、補件? | 沒有可核對的計時,未知 |
| 這輪審查從送出到核對完,經過多久? | 缺少完整起訖,未知 |
這筆是一般提示審查,沒有載入 plugin,原件編號 G0-A;它碰核心規則,只拿來認欄位,不進上面小型 PR 的基線。
同一份材料、同一段提示,三天後重跑,結論變了。 第一次要求 Owner 確認,第二次改成要求補證據(五回合、19.1 秒、費用估值 US$0.0568),沒再指出自評不符。兩次 CLI 版本不同,一次不能當代表;量時間之前,先核對它到底交回了什麼。
我能回答 Claude 執行多久,還不能回答自己少忙了多少。 下一輪要補的,是工作紀錄裡人的那一半。
我不打算請大家把每件事逐分鐘填完,而是先選一個專案的小型 PR 審查,依基線卡觀察:約定期間與完成點,符合條件的都列入名冊,卡住的也保留;Claude 的執行資訊沿用紀錄,人補上為了確認結果做了什麼。沒有導入前基線,就從目前做法累積起點。
一個完全合成的教學案例:假設 Jira 有一張「修正列表排序」的工單。Claude 交回審查結果後,Reviewer 發現提供的需求是舊版,補上新版再請它確認。這一輪從準備材料到核對修正後的結果,留下這張紀錄:
| 工作紀錄 | 合成示例 |
|---|---|
| 任務/階段 | DEMO-123/PR 456/第 1 輪審查,編號皆為示例 |
| 執行對照 | 第一次與補件後的執行識別、session |
| 人工理解 | 5 分鐘;實際準備的人 |
| 操作 | 2 分鐘;實際操作者 |
| 初次審查 | 8 分鐘;Reviewer |
| 補件與返工 | 5 分鐘,與前面三項不重複;實際補件與重審的人 |
| 人工合計 | 20 分鐘,全部標為事後估計 |
| 主要卡點 | 送審材料引用舊版需求 |
| 本輪結果 | 審查核對完成,重要發現有來源 |
| 程式是否已交付 | 另看 PR、部署與驗收 |
這二十分鐘是人的投入,不含機器秒數。它證明不了省時,但指出一個可改的地方:時間花在重新確認需求版本。只看 Claude 多快回答,看不到這件事;所以人工補記除了分鐘,也要問卡點。
前面是我的既有紀錄。如果你想知道自己的 Claude Code 會留下哪些資料,可以用這個小練習拿一筆。它只幫你認識紀錄,不重現剛才的二十五秒,也不要求日常工作額外重跑。
第一步,準備一份你有權使用的 PR。 同一資料夾放四份材料:PR.md 修改說明、ticket.md 需求與驗收條件、diff.patch 差異、Program.cs 測試;檔名不同就把提示一併改。在該資料夾開 PowerShell,需先安裝並登入 Claude Code。
第二步,請 Claude 看一次,順便留下紀錄。 這段指令做三件事:讀取材料、只審查不改檔、把回答與執行資訊存進 run-demo.json。
claude -p "讀取 PR.md、ticket.md、diff.patch、Program.cs,僅審查,不修改檔案。用三句話說明這份 PR 缺什麼依據。" --model sonnet --effort low --safe-mode --tools Read,Grep,Glob --allowedTools Read,Grep,Glob --output-format json > run-demo.json
檔案存好後,先讀 Claude 的回答,看看它指出什麼缺件。這才是這次審查要做的工作;留下的數字,是幫我們回看這段工作,不是另一份成績單。
第三步,把工具紀錄和自己的投入放在一起。 打開 run-demo.json,確認執行成功後,先找下面四欄:
| 檔案裡的名稱 | 用白話看它 |
|---|---|
session_id |
這次執行的編號,之後找回同一筆用 |
duration_ms |
Claude 執行多久;除以 1,000 就是秒 |
num_turns |
這次執行經過幾個回合,不是完成幾件工作 |
total_cost_usd |
這次工具費用估值,不是完整工作成本 |
接著補上:自己讀材料、操作、核對回答與補件各花多久,卡在哪裡。事後回想就標「估」,不知道留未知。
這四欄為什麼自動就有?因為 claude -p 加 --output-format json 的回傳本來就帶著它們。互動模式在對話裡輸入 /cost 也看得到費用與時間。要每次自動落檔,session 開始與結束有 hook 可以掛;官方遙測是另一條路。
我的機器上那兩支 hook 已經掛著。把 09-15 到 09-19 16:14 的原始紀錄攤開:
| 記錄器留下的 | 數字 | 怎麼讀 |
|---|---|---|
| 開始事件 | 21 筆 | startup 11、resume 4、compact 2、clear 1、headless 3;同一個 session 續接一次就多一筆 |
| 結束事件 | 15 筆 | 6 筆開始沒有結束,全是兩個長 session 的 resume/compact;1 筆結束找不到開始 |
| 不重複 session | 開始 14、結束 12 | 這才接近「幾個 session」,事件數不是 session 數 |
| 有時間值的結束 | 11 筆,加總 43.4 分 | 開始到結束的時間差,含等待;不是模型執行時間,也不是前面的 duration_ms |
| 寫這篇文章的 session | 4 次開始、0 次結束 | 最長的那個 session 反而沒有分鐘數 |
| 人工分鐘 | 0 筆有效 | 一筆占位,五個分鐘欄全空 |
三件事在數字裡。機器那半邊會自動來,但要先去重、配對、分清哪一欄量什麼,才敢加總。 自動也會被自己關掉:今天六次隔離實驗用了 --setting-sources "",hook 跟著停,一筆都沒進帳。人工那半邊沒有任何機制會替你填,也不能從 session 時長推算。
我 09-17 用 Day 4 的合成材料跑過一次 demo-01:約十二秒、五回合、費用估值 US$0.0474。它交回的三句是:
這份 PR 最缺的是「規則位置」與「驗收預期的規則依據」:ticket 只有一句需求,已付款退款、已取消 no-op、null 拋例外都是作者自行假設。其次,「已確認/待確認」與「尚未驗證的路徑」欄位空白,呼叫端完全未被檢視。第三,測試由同一支 AI 依自己假設的規則編寫並自證通過,等於用假設驗證假設。
三句和 G0-A 的六條指向同一個缺口,用字與數量不同。執行成功看 is_error: false 與 subtype: success;成功不代表審查內容對。做到這裡,你有了一筆「Claude 做了什麼、人又補了什麼」的紀錄;單筆證明不了省時,但下次回看不必只靠印象。
第一輪先用一張共用表,照工作發生的順序記:
工單、PR 與 CI 通常已有事件紀錄;Claude Code 的執行資訊要確認是否保存,人工投入則需要另外補記。先挑一件工作,看看工單、PR/CI、Claude 執行與人工簡記這四種資料能不能對上。
task_id 用來連結資料,不是直接加總的指令。同一任務可能有多個 PR、審查輪次、session 與 run;對上任務後,仍要依各自識別碼核對重複事件、分清輪次與缺值。流程時間用約定的起訖事件計算,不能把多個 session 的時長相加當成交付經過時間。
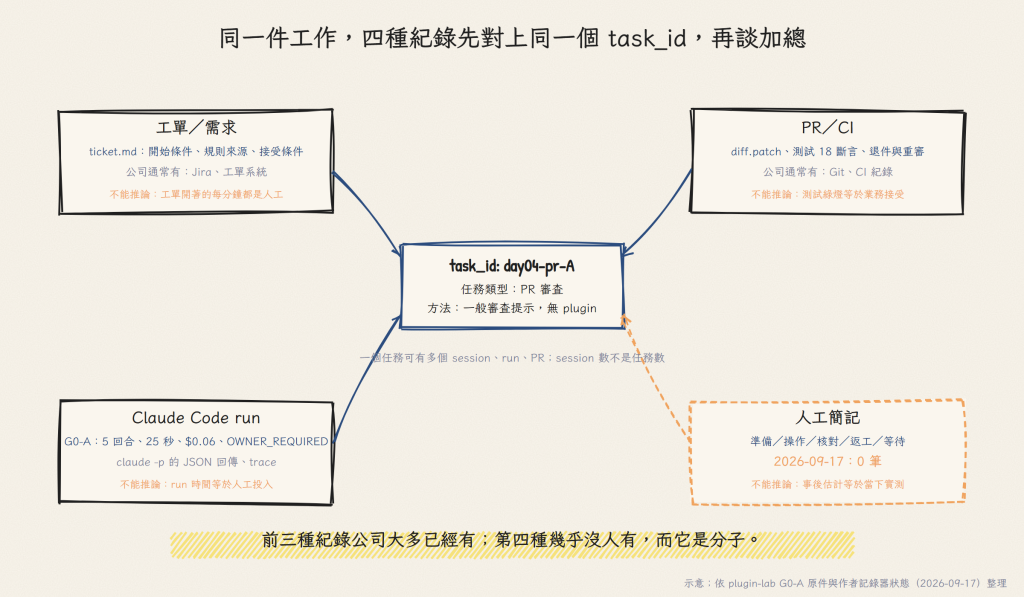
依 G0-A 原件與作者記錄器狀態整理。圖中的「0 筆」指有效人工投入紀錄;全空的占位不計入。
先記一輪,看這些欄位能不能幫團隊找到卡點,再決定哪些重複動作值得自動化:送審時自動建草稿、執行後自動帶入工具紀錄,人補查證與判斷。工具執行結束不等於人核對完成。這套整合目前是設計。
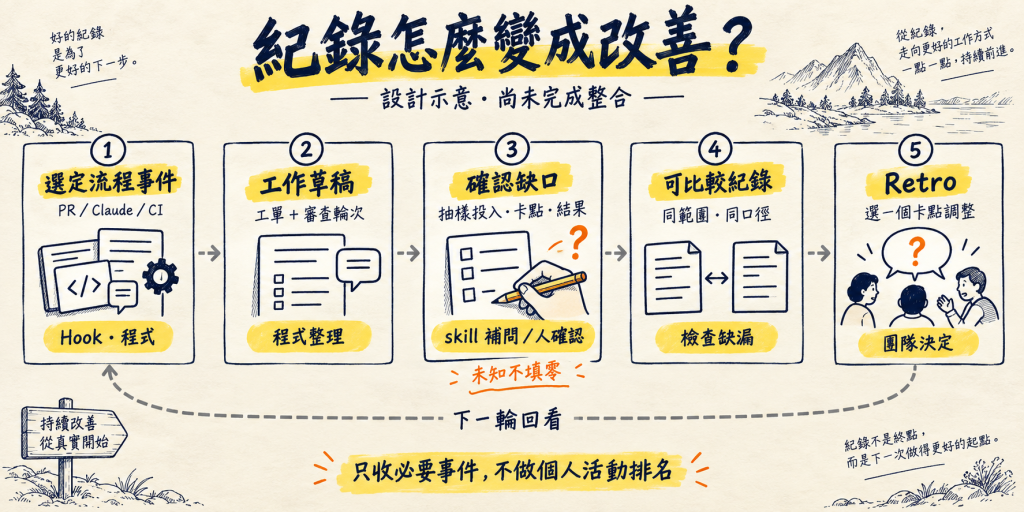
設計示意。程式整理事件,skill 補問,人確認;團隊依可比較的紀錄決定下一輪。
到了約定的回看時間,先確認這批工作可不可比、漏了哪些,再看卡點。延續合成情境:如果多筆審查都卡在需求版本不明,先調整送審材料,不是判定 Claude 不好用。
| Retro 要決定的事 | 本例的下一步 |
|---|---|
| 看見什麼問題? | 多次花時間重新確認需求版本 |
| 下一輪改什麼? | 送審時附需求版本與接受條件 |
| 誰負責? | 指定送審範本的維護者,約定完成與回看時間 |
| 怎麼知道有幫助? | 比較同類審查的補件情況與人工查證投入 |
| 哪些不能犧牲? | 重要問題的辨識、來源核對與漏項檢查 |
| 還要算什麼? | 改範本、維護規則與填紀錄的投入,另列不重算 |
除了想觀察的改動,其餘條件盡量一致,同期的人員與模型變動也留下來。比的是協作方式調整前後,推不成「有 AI 比沒有 AI 快」。這接回 Day 2 的 Retro:挑一個卡點,改一次,用同樣的尺回看。
Day 1 的五層問題,不能靠一份 Claude 執行紀錄全部回答。把目前有的與缺的放在一起:
| Day 1 的問題 | 需要的證據 | 今天有沒有 |
|---|---|---|
| L1 使用:大家有沒有用? | 使用紀錄、對象、期間與分母 | 有活躍數,口徑未對帳 |
| L2 工程:交付能接受嗎? | 驗收依據、測試、退件與返工品質 | 有審查與執行紀錄,缺人工核對與接受依據 |
| L3 人員:人有沒有減載? | 人工投入、求助與交接紀錄 | 0 筆有效人工投入紀錄;記錄器有 14 個 session,人工欄全空 |
| L4 成本:完整代價是多少? | 工具費用,加建置、審查、維護投入 | 只有機器側費用估值 |
| L5 業務:最後改善了什麼? | 更早可用、維運負擔的前後證據 | 沒有 |
「今天有沒有」那一欄是起點,後面每一次調整都回到這五個問題交帳;有證據的回答,沒有證據的留下未知。
今天先把審查的終點寫成「人工核對完成」。但這句話對我、Claude 和下一位接手的人,是否代表同一件事?這也是開始記錄之前,需要一起約定的事。
參考資料:
本文實作紀錄
machine_minutes 的原始加總,欄位為開始到結束的時間差,不代表模型執行時間或去重後使用量。人工 entries.jsonl 僅一筆占位、五個分鐘欄全空。09-19 六次實驗以 --setting-sources "" 執行,hook 未觸發。依 sessions.jsonl、entries.jsonl 與 hook 程式核對。方法參考
--output-format json 欄位、內建 OTel、費用估值、生命週期事件;本篇未部署遙測與整合。

 iThome鐵人賽
 看影片追技術