
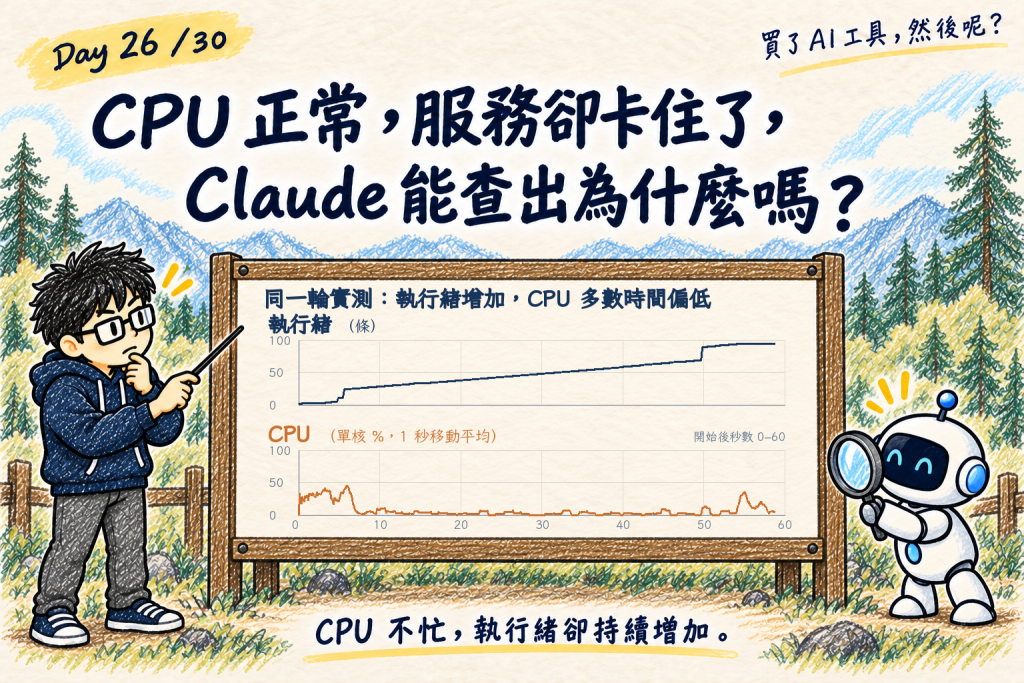
CPU 沒有忙,取消訂單卻等了快半分鐘。這時再加一台機器,還是先找哪段程式卡住?
以前團隊遇過類似的非同步問題,處理很久,那種難查的感覺我還記得,細節卻已經記不清楚。這次不還原舊事故,我在前面的 .NET 訂單教學服務加了一段等待,重新做一場能留下證據的調查。
Day 24 把線索接給 Claude,Day 25 把結果放回 Dashboard。今天是第四幕的下一步:Claude 能不能用這些線索找出原因,改完後,服務又是否真的好了?
取消訂單前,服務先等一段客戶資料查詢。教學環境用 Task.Delay(500) 模擬半秒等待,沒有真的連資料庫。單次操作看起來不奇怪,我改用 96 個併發工作者,取消 384 張不同訂單。
結果只有 321 筆拿到 HTTP 200,另外 28 筆逾時、35 筆連線被重設。整批花了近 50 秒;負載期間 CPU 平均只相當於一個核心的 4.4%。這個數字表示沒有持續吃滿 CPU,不是整台電腦的使用率。
沒在忙著計算,為什麼還是沒空接工作? 我沒有把故障答案交給 Claude,只給它症狀、時間範圍、原始碼和需求,請它先查。
Day 24 查的是一個原因已知的慢下游,用來確認線索有沒有接好;今天這一題,Claude 不知道答案。
沿用 Day 24 的入口,Claude 經唯讀 MCP 呼叫 gcx 查 Grafana,再用另一個受限工具讀程式與執行緒堆疊。查到的結果回到模型,由它決定下一個查詢;我沒有先挑好幾行 Log 貼給它。Grafana 裡是這次故障紀錄的重放,堆疊則另開一輪、用同版程式擷取,避免診斷工具干擾計時。
給 Claude 的調查要求可以濃縮成這段:
服務在併發取消時變慢,CPU 卻不忙。先提出至少兩個原因,各寫出什麼結果會推翻它。使用限定時間範圍的指標、Log、堆疊與當時版本程式查證;查不到就列缺件。不要修改程式,也不要把客戶端逾時當成工作未完成。
它沒有直接給答案,先列了四個嫌疑,每個都附上「查到什麼就推翻它」:
| 嫌疑 | Claude 事先寫的推翻條件 | 實際查到 | 判定 |
|---|---|---|---|
| CPU 被吃滿 | 最慢那段,CPU 遠低於一個核心 | 最慢的 44 秒幾乎都是 0,整段最高 55% | 排除 |
| GC 或記憶體壓力 | heap 小而平穩,Log 沒有 OOM | heap 全程約 1~18 MB;Log 只有 3 筆預期內的業務警告 | 排除 |
| 鎖或通知拖慢請求 | 鎖內工作很短,通知不在請求路徑上 | 鎖內只做字典與檔案附加;通知經佇列送出,沒有失敗紀錄 | 排除 |
| 執行緒被同步等待占住 | 待處理工作接近 0,或執行緒一開始就有 96 條 | 見下 | 支持 |
最後一個嫌疑的推翻條件很具體:如果一開始就有 96 條執行緒可用,問題就不是「人手不夠」。指標畫出的卻是相反的樣子:
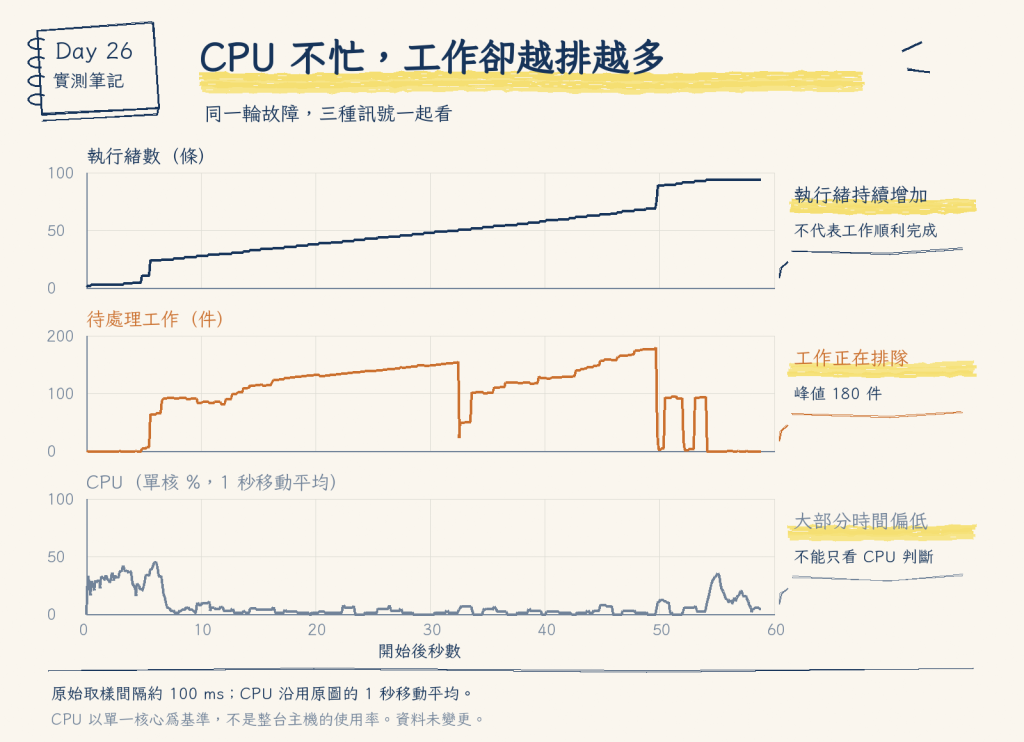
實測圖,資料就是重放給 Claude 查的那一輪。Claude 用 1 秒間隔查詢,峰值與每 100 ms 的原始取樣略有差異。
執行緒從 1 條開始,中段幾乎每秒只多 1 條(24 → 69),將近 50 秒才補到九十幾條;同一段時間,待處理工作一路堆到近 180 件。Claude 還查到有 27 秒,完成數只從 2,659 增加到 2,926,一秒約 10 件,幾乎停住。
CPU 貼近 0,工作卻越排越多:執行緒不是在算,而是在等。等什麼?Claude 打開堆疊,多條執行緒停在 Task.SpinThenBlockingWait,往上都是 CustomerHistory.Prepare()。再讀程式第 220 行:
public static void Prepare() { FetchAsync().GetAwaiter().GetResult(); } // FetchAsync 是 await Task.Delay(500)
非同步的半秒查詢,被同步等了回來,等待期間一直占著執行緒。堆疊是「這條執行緒取樣當下走到哪裡」的呼叫紀錄,不是錯誤訊息;只搜到 .GetResult() 還不夠,指標的排隊、堆疊的停點、程式的那一行,三者對上才成立。
這就是 ThreadPool starvation,執行緒集區飢餓:現有工作者被占住,新工作暫時找不到可用的人手,不一定是執行緒數已達上限。Microsoft 的診斷教學同樣建議把執行緒變化、CPU 與堆疊放在一起看,不能用單一指標下結論。官方診斷教學
上面是第三輪調查(63.5 秒、15 回合、7 次觀測查詢)。前兩輪 Claude 也指向同一行,結論寫得一樣篤定,我卻沒有收下,理由就寫在它自己列的缺件裡:
錯的不是推理,而是我餵給它的線索。 2026 年 Kim 等人分析五個模型、1,675 次雲端根因調查,最常見的失敗正是誤讀資料與探索不完整。答案猜對,不代表證據站得住;這兩次能被抓到,是因為我要求它把讀不到、看不懂的地方列成缺件。第三輪改成每輪獨立標籤、查詢都限定該輪,才是上面那張表。
Claude 也有判斷過頭的地方:它因為 heap 不大、沒有 OOM Log,就把 GC 列為排除,但這次沒收完整 GC 暫停資料。我接受的是「同步等待有直接依據」,不是「其他原因全被排除」。
診斷卡的風險欄還留了一句話,後面會用到:改成 await 後,同一張訂單的併發取消「可能都讀到未取消狀態」,修好後「要用同一訂單的併發取消測重複通知」。
接著換一個 Claude 工作階段,只給故障程式、需求與診斷卡。它能修改的只有兩個教學 C# 檔案,建置工具也只能執行固定的 dotnet build;沒有任意 shell,也不能改測試。
這些限制由自訂 MCP 的檔案白名單與固定命令執行。Claude CLI 關閉內建工具,只開這組 MCP,不是只在提示裡拜託它不要亂改。
第一版最重要的修改只有一行。看的是等待方式,半秒查詢仍然存在:
// 原本:請求的執行緒同步等結果
CustomerHistory.Prepare(); // 內部是 FetchAsync().GetAwaiter().GetResult()

// Claude 第一版:等待時不持續占住這條執行緒
await CustomerHistory.FetchAsync();
這一版 Claude 花 29.7 秒、8 回合、US$0.09。重跑相同負載,兩輪都是 384 筆全部成功,p95 約 0.56~0.58 秒。看起來可以收工了。
修法說明裡,Claude 又提了一次:讀取、判斷、寫入不是原子操作,可能重複通知;「這個競態原本就存在,我沒有處理,因為它超出最小修法」,並把要不要修列為需要我決定的事。它警告過,也問過;是我給的「最小修改」讓它停在那裡。 而 384 筆全綠的數字,正讓人想直接按下接受。
我把它的警告照字面做成測試。訂單規格本來就寫著:真正取消一次,只能產生一次通知。 讓 16 個請求同時取消同一張新訂單。
結果 16 個都說自己完成了狀態轉換,接收端也真的收到 16 筆通知。
速度恢復了,功能卻還沒過關。 不同訂單的壓測抓不到同單競態;「重複按一次」的依序測試,也不等於「大家同時按」。
我把同單測試的實際結果交回 Claude(30.4 秒、9 回合、US$0.10)。這次它把查詢放在前面,等完之後,再用同一把鎖完成重新讀取、判斷與更新。
原本並不是完全沒鎖:讀取、寫入各自都有保護,但兩步之間仍可以插進另一個請求。 這項缺陷原本就存在,不能說是 await 憑空創造;提高併發後,這次測試讓它現形了。
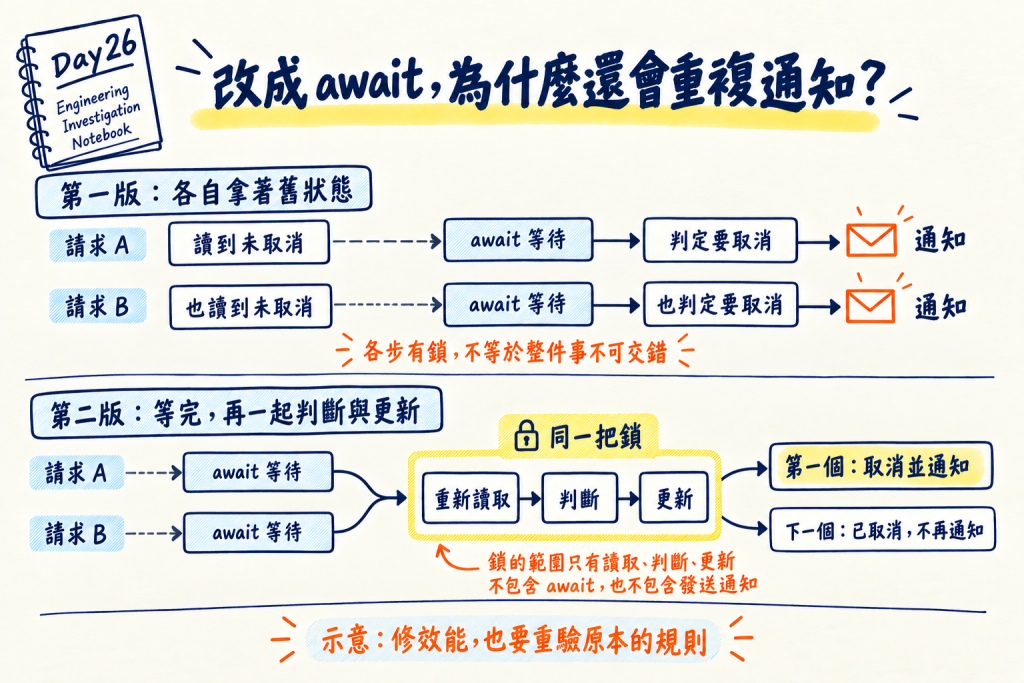
示意圖。鎖只包讀取、判斷與更新,不包非同步等待,也不包發送通知。
修正版的關鍵在 TryCancel。看下面的 current = _d[id] 是否和後面的判斷、更新處於同一把鎖內:
// handler:先等查詢完成,再依最新狀態決定
await CustomerHistory.FetchAsync();
store.TryCancel(id, out var current, out var result, out var transitioned);

// OrderStore.TryCancel 內部
lock (_g)
{
    current = _d[id];
    result = Cancellation.Cancel(current);
    transitioned = Cancellation.Transitioned(current, result);
    if (transitioned) _d[id] = result.Order;
}
// 只有 transitioned 為 true 的請求,才會在鎖外排入通知。
這是記憶體教學服務的修法,不能把 C# 鎖直接套成跨多台服務的保證。正式系統若用資料庫或多副本,還要依儲存方式處理一致性;本篇也沒有驗證「更新狀態後、通知入列前程序崩潰」的缺口。
修後兩輪維持相同的 384 張訂單、96 併發及半秒等待,再各做一次同單 16 併發。這次驗的是 Claude 真正修改後的程式,不是另準備一份答案版。
| 核對項目 | 故障版本 | 第一版:改 await | 第二版:補原子操作 |
|---|---|---|---|
| 不同訂單取得 HTTP 200 | 321/384 | 兩輪皆 384/384 | 兩輪皆 384/384 |
| 客戶端 p95 | 約 30 秒 | 0.56~0.58 秒 | 0.57~0.59 秒 |
| 同單 16 併發,實際通知數 | 未測 | 兩輪皆 16 筆 | 兩輪皆 1 筆 |
| 此次接受結果 | 未通過 | 未通過 | 通過本次條件 |
第二版每輪 13 項檢查全過,包含取消狀態、退款旗標、接收端逐筆對帳、重複取消、已出貨拒絕、授權與不存在訂單,以及新增的兩項同單條件。16 個同單請求都回 200,只有一個 transitioned=true,其餘表示已取消,不再通知。
所以,這次是真的修好了:同一批 384 張訂單,從近 30 秒逾時、63 筆失敗,變成兩輪全部成功、p95 約 0.6 秒;同一張訂單同時取消 16 次,也只送出一次通知。
這次真正帶得走的,是一段有次序的合作:先讓 Claude 查指標和堆疊,找到值得改的那一行;再讓它修改;最後用原本的需求驗收,不能只挑變快的數字。
在自己的 .NET 服務,可以先保留事故時間範圍、部署版本與負載描述,用 dotnet-stack report -p <PID> 取得當下堆疊,再讓 Claude 交叉核對。若沒有 Grafana,也可以先用 dotnet-counters 蒐集 runtime 指標;工具入口可以不同,但不能只給一句「服務很慢」。取得診斷資料須沿用團隊的存取規範。
教學附件另附不呼叫模型的重跑入口,從 repo 根目錄執行:
python days/day26/lab-threadpool/validate_claude_repair.py --workspace days/day26/lab-threadpool/claude-final-source
它會建置封存版本並重跑負載與同單案例。先看新產生的 summary.json 裡各項 checks,再看 same-order.json 的回應與接收數;不要只看畫面最後一行完成。
Claude 查因三輪與兩版修復的 CLI 回報費用合計約 US$0.78;沒有記人工分鐘,因此不能宣稱總工作省了多少。
因為工作卡在等待,不是計算。Claude 查出了那一行,第二版也真的修好了;但這篇真正的答案在另外兩處:證據站不站得住,要看它列出的缺件;修法算不算數,要看原本的承諾有沒有重驗。
換一題也一樣嗎?我另外用兩個不是我出題的第三方題庫考它:根因題庫 RCAEval 40 次中,39 次第一名就找對出問題的服務;但 o11y-bench 裡要把幾個訊號拼起來的調查題,評分平均只有 0.68(滿分 1)。題庫成績 2026 年的 ORCA-bench、TDAD 也指向同一件事:值班題目越接近真實越難答對,修好問題時也常弄壞原本通過的測試。
現階段不能整個交給 AI:讓它查因、動手修,由固定程式驗收,再由人決定要驗什麼、接不接受。
還有一件事沒說完:故障那一輪有 63 筆請求沒拿到成功回應,事後對帳,384 張訂單卻都已取消、也送出了通知。呼叫端看到的失敗,不一定是真的沒做。下一次再遇到逾時,直接重送是在補做,還是在重做?
參考資料:
CLAUDE-VERIFICATION.md 保存三輪查因、兩版差異、費用與逐輪結果;claude-a/ 是三張診斷卡與查詢稽核,claude-final-source/ 是最終修正版。

 iThome鐵人賽
 看影片追技術