

我們的系統現在已經可以認出「使用者傳了一個網址」過來。但是,AI 是沒辦法直接「點擊」網址的。
如果我們直接讓 n8n 把網頁的 HTML 原始碼全部抓下來,直接塞給 Gemini,會發生幾個致命問題:
<div>、<script>、CSS 樣式表等無意義的標籤。為了精準抓取網頁的正文,我們不從頭寫複雜的正則表達式,而是使用 Python 中極為強大的文字萃取套件 trafilatura
第一步:安裝套件
請打開終端機,在你的虛擬環境中安裝套件:
pip install trafilatura
第二步:新增 FastAPI 端點 /extract-web
打開 main.py,新增一個專門用來處理 URL 的 endpoint。這個端點會負責下載網頁、過濾掉廣告與導覽列,只回傳乾淨的文章內容。
import trafilatura

class URLRequest(BaseModel):
    url: str

@app.post("/extract-web")
def extract_web(data: URLRequest):
    try:
        downloaded = trafilatura.fetch_url(data.url)
        if not downloaded:
            raise HTTPException(status_code=400, detail="無法下載網頁內容")

        text = trafilatura.extract(downloaded)
        if not text:
            raise HTTPException(status_code=400, detail="無法萃取網頁正文")

        return {
            "status": "success",
            "text": text
        }
    except Exception as e:
        raise HTTPException(status_code=500, detail=str(e))
第三步:在 n8n 串接 Web 通道
1.新增 HTTP Request 節點:
從 Switch 節點的 Output 1 (Web) 拉出一條線,新增一個 HTTP Request 節點。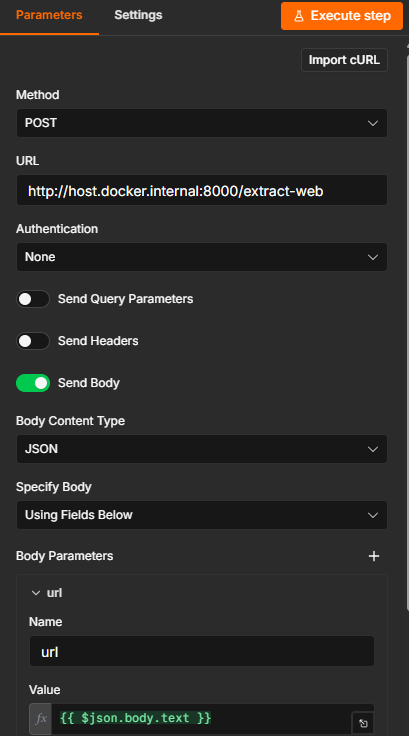
將這個新增的節點如上圖設定好。
{{$json.text}}
點擊 Webhook 的 Listen,在終端機發送一則包含真實網址的測試(例如維基百科或 iThome 新聞連結)。你會看到 n8n 成功走到通道 1,先去 FastAPI 爬出純文字,接著立刻送給 Gemini 產出完美的 JSON 結構化摘要!真實網址要是 HTML 式的靜態網址,不能是需要登入的社群網站裡的貼文,社群網站內的貼文只能抓到 JavaScript 空殼,找不到任何真正的文章內容。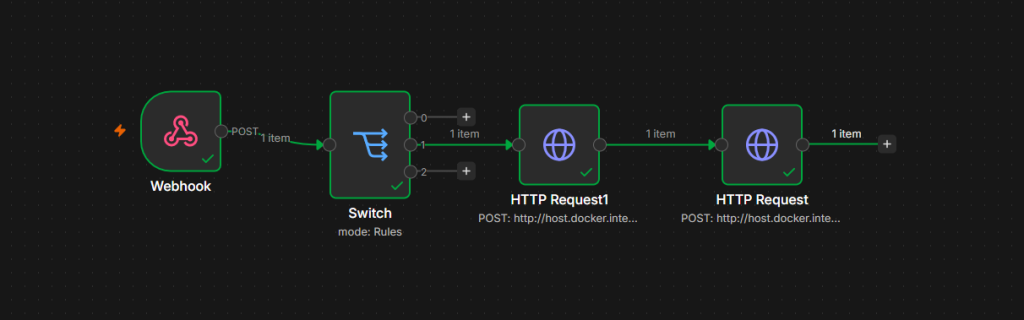


 iThome鐵人賽
 看影片追技術