

在 Input Router 實作中,我們已經能成功辨識出使用者傳來的是 YouTube 網址,並把它分流到了專屬的通道。
但是,LLM 是一種「語言模型」,它難以直接觀看影片畫面或聆聽聲音。如果我們想讓 AI 幫忙總結一部長達一小時的技術教學影片,我們必須建立一套機制,先將影片內容轉換為文字,才能餵給 AI 進行有效率的分析。
在處理影片自動化時,最穩定且低成本的做法是直接抓取 YouTube 的字幕。
為了解析 YouTube 網址並取得字幕,我們可以使用 youtube-transcript-api 這個強大的 Python 套件。
第一步:安裝套件
請在終端機(確保在你的虛擬環境中)執行以下指令:
pip install youtube-transcript-api
第二步:新增 FastAPI 端點 (/extract-youtube)
打開我們的 main.py,匯入所需套件,並新增一個處理 YouTube 網址的端點:
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel
from youtube_transcript_api import YouTubeTranscriptApi
from urllib.parse import urlparse, parse_qs

class YouTubeRequest(BaseModel):
    url: str

@app.post("/extract-youtube")
def extract_youtube(data: YouTubeRequest):
    try:
        query = urlparse(data.url)
        if query.hostname == 'youtu.be':
            video_id = query.path[1:]
        elif query.hostname in ('www.youtube.com', 'youtube.com'):
            video_id = parse_qs(query.query)['v'][0]
        else:
            raise ValueError("無效的 YouTube 網址")

        yt_api = YouTubeTranscriptApi()
        transcript_list = yt_api.fetch(video_id, languages=['zh-TW', 'en'])

        text = " ".join([t.text for t in transcript_list])

        return {
            "status": "success",
            "text": text
        }
    except Exception as e:
        raise HTTPException(status_code=400, detail=f"無法取得影片字幕,請確認影片是否包含字幕。詳細錯誤: {str(e)}")
後端 API 準備好後,我們回到 n8n 將管線接通:
呼叫 FastAPI 抓取字幕:
從 Switch 節點的 Output 0 (YouTube) 拉出一條線,新增一個 HTTP Request 節點。並將此節點如下圖那樣設定。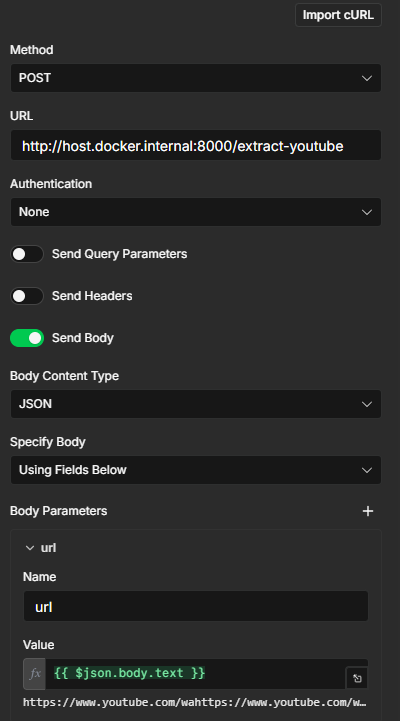
送給 Gemini 進行摘要:
將這個 HTTP Request 節點的輸出端,連接回我們最早建立的 /summarize 節點。確保 /summarize 節點接收的資料是剛剛 API 回傳的 {{ $json.text }}。
測試
接著可以用 curl 送一個有字幕的 youtube 連結進行測試,成功的架構如下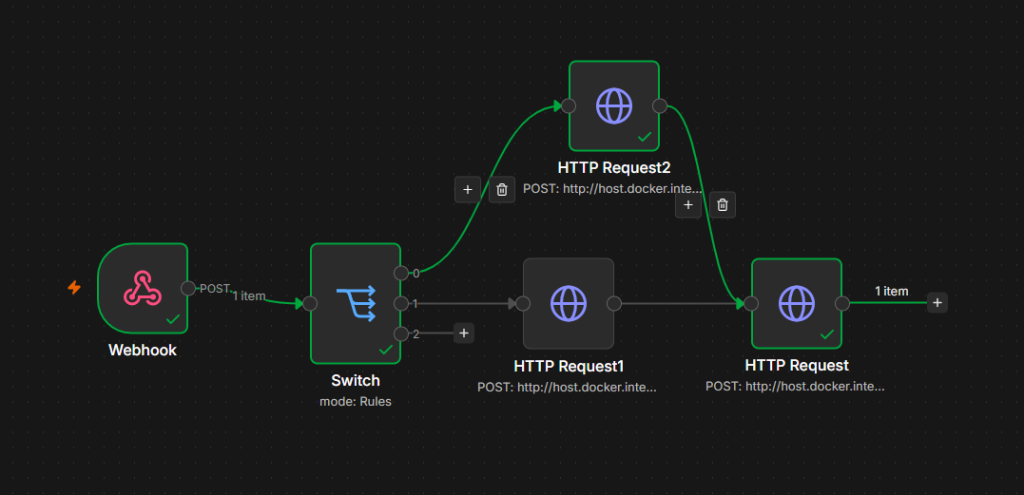
以下圖片可以看到 FastAPI 成功抓取 cc 字幕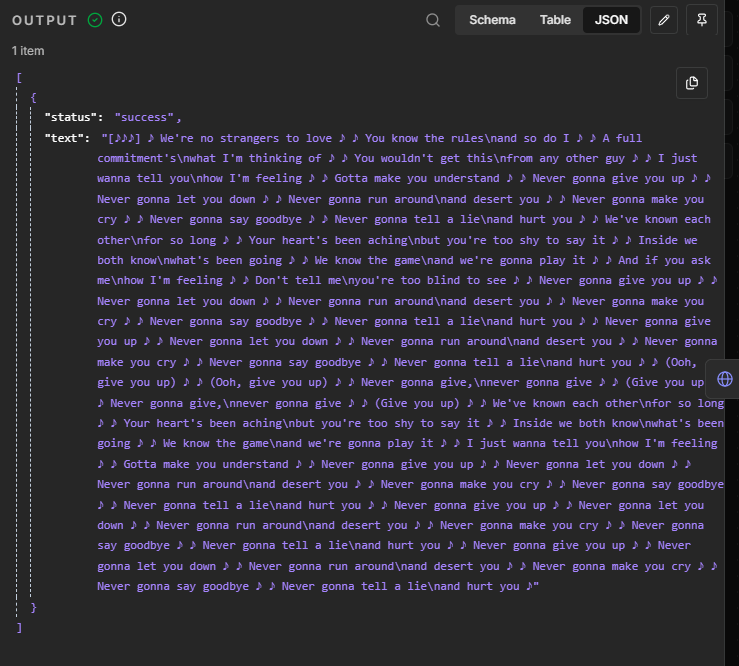
下圖可以看到 Gemini 針對字幕進行的摘要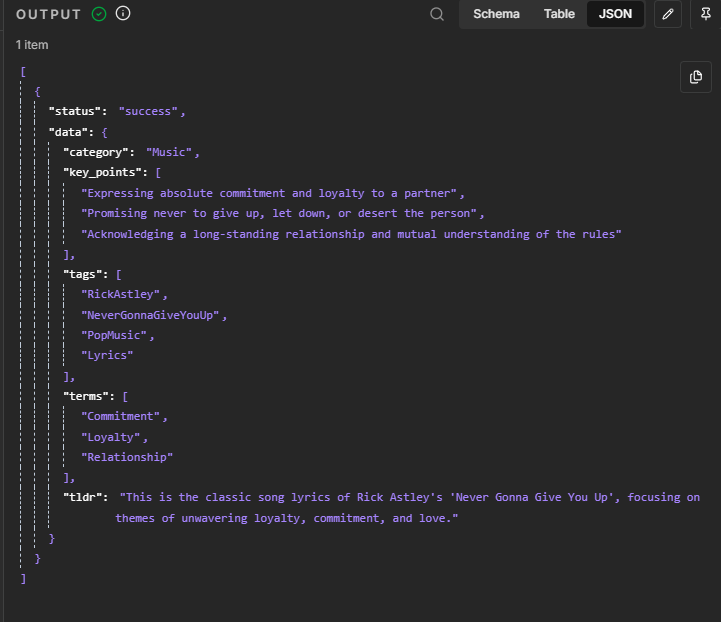
要注意我的實作只能抓取有 cc 字幕的影片,沒有字幕的影片就只能嘗試讓 AI 自己看整段影片後再摘要,或是用語音辨識模型自行建立字幕。系列的最後會加入沒有字幕的 error 機制,讓使用者可以知道影片能不能使用這個系統。


 iThome鐵人賽
 看影片追技術