
前幾天一定有人有疑問,標題為什麼叫「少年 Token」,沒錯,我只是為了這段標題 XDD
之前我們了解了 Token 從何而來,不管是 BPE 還是 Unigram,最終人類輸入的一整段文字,都會被拆解成一串 Token ID,並透過 Embedding Table 換成一段帶有語意的向量。
這時候,Token 的出航準備已全部就緒,正式踏入大語言模型(LLM)的世界!今天我們就從在看 LLM 規格時常碰到的名詞開始:Decoder-Only。
如果去查閱 ChatGPT、Claude、Gemini、LLaMA-3 或 DeepSeek 的架構,大多會有一段論述:「本模型採用 Decoder-Only Transformer 架構。」 但為什麼叫 Decoder-Only 呢?表示曾經不止有 Decoder 的意思囉?
這得回到 2017 年 Google 發表的《Attention Is All You Need》。當時設計 Transformer 想解決的比較像是機器翻譯(例如英翻中)這種問題。當時的想法把這類型任務拆成兩種工作:
於是當時設計了分工明確的 Encoder-Decoder 架構,並且兩者有各自的強項:
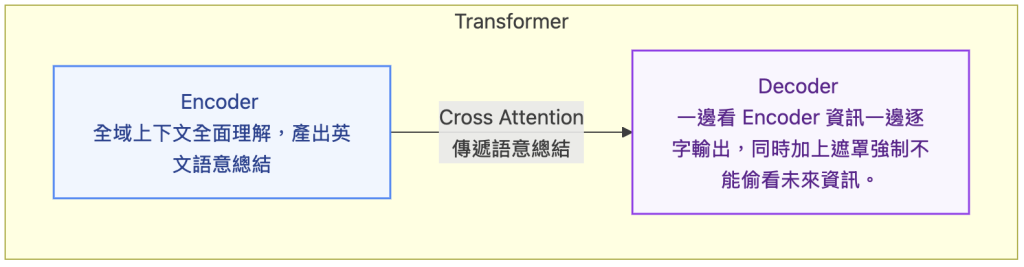
然而為什麼現在 LLM 大多都只有 Decoder-Only 呢?原因是目的不一樣,所以做的取捨也不同。在現在 LLM 應用情境裡,主要專注在「生成文本」,試想一下:如果我們把「問題」和「答案」接成同一篇長文章直接送給 Decoder:
所以我們不難發現,Decoder 其實就有能力對上下文做到「一定程度的理解」,接著再「預測下一個字」。在這樣的前提下,增加 Encoder 反而是增加整體架構的複雜度,輸出速度也會因此下降。於是現代 LLM 做了一個漂亮的工程取捨:砍掉 Encoder、砍掉中間的溝通線路,只留下同一種 Module 重複堆疊,這就是為什麼現在主流 LLM 大多是 Decoder-Only 的原因。
要特別提醒的是,是因為這個情境特別適合,所以採取 Decoder-Only 的策略。而這個策略真的解決了使用者的問題,被大眾買單了,才會看到到處都是這種架構的模型。但或許哪一天,別種架構的模型解決了其他領域的問題,或是更能解決問題,並且也被大眾買單後,就會有 Encoder-Only、Encoder-Decoder 等架構的模型再次現身時機出現,例如:這幾天很紅的 Jev,沒有直接證據表明他是採取什麼架構,但也有外界推測他是 Encoder-Only 的架構,其實也不難想像。我想表達的是,這些架構有各自擅長處理的問題,沒有絕對的好或壞,都是選擇與決策而已。
這部分講最好的肯定是台灣知名 Youtuber 李宏毅 aka 大金,我從就學時期到現在都是看著他的影片一步一步認識 AI,在這裡附上他講述 解剖大型語言模型 的連結,接下來幾篇可以當作我看完後的整理!LLM 的整個運作週期被稱作自回歸迴圈(Autoregressive Loop),意思就是每一輪都用 1 ~ N 個字當作 input 來預測第 N+1 個字。(再用第 1 ~ N+1 個字當作 input 預測第 N+2 個字,依此類推)
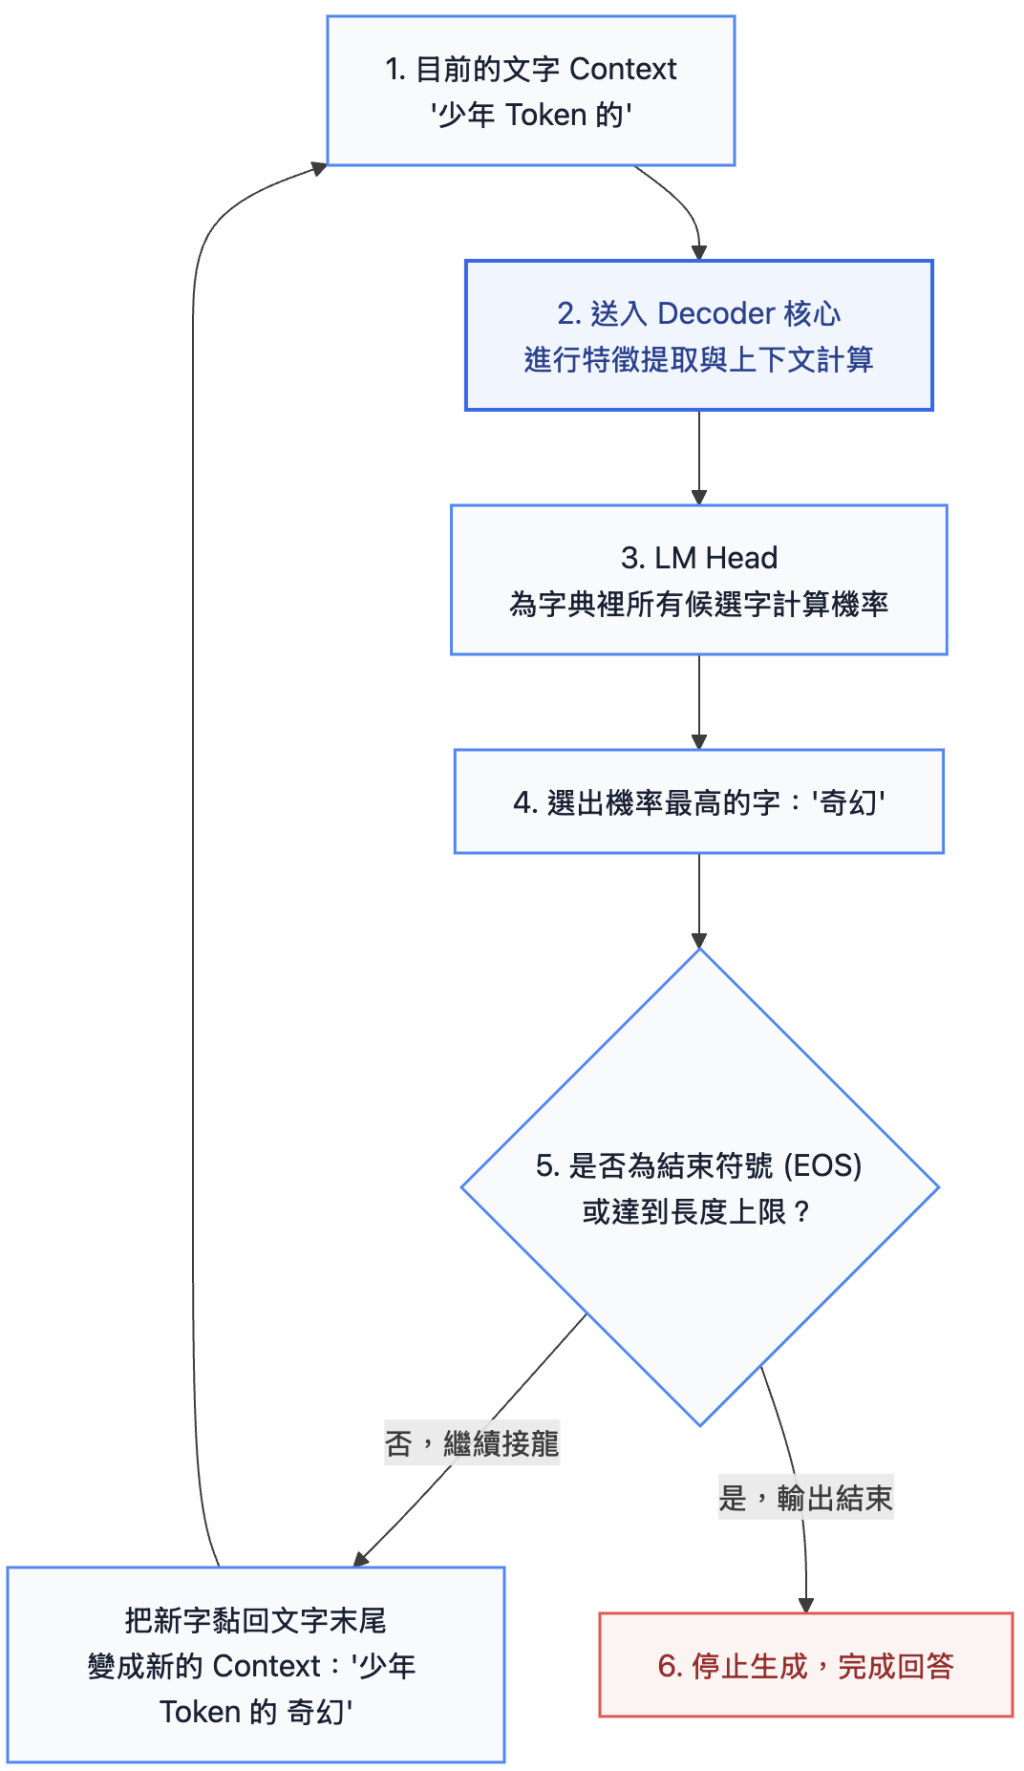
可以想成:對於輸入序列中的每一個 Token,模型都在嘗試預測它的「下一個字」。因此,我們只要聚焦在最後一個 Token 的輸出向量,就能推算出整句話接下去的下一個字!所以對應上面的流程圖,整個迴圈可以拆解為六個步驟:
"少年 Token 的"。"奇幻" 91%、"冒險" 5%、"世界" 2%)。"奇幻"。有趣的是,模型挑選的機制不一定每次都選機率最高的。如果每次都挑機率最高的,生成的句子很容易變得死板、跳針;因此通常會用「按機率抽籤」的方式,讓機率高的字最容易被選中,但也保留隨機性讓其他字有機會出現。"少年 Token 的 奇幻",當作輸入投入下一輪運算。</s> 這個預設 Token,系統收到後立刻終止迴圈。剛剛我們刻意先跳過了一個關鍵細節:每一層 Decoder Block 內部到底在忙什麼?
明天,我們就來深入了解單一 Decoder Block 內部是怎麼運算的,看看它究竟是如何找出每個 Token 之間的上下文關係!


 iThome鐵人賽
 看影片追技術