
昨天結尾我留了兩個承諾:把軌跡的欄位表定下來,還有給你 Jev 的數字,包含它答錯的那幾題。
兩個都做了。欄位表定出來了,但結論跟我原本想的不一樣——我以為模型會補上我填不滿的那一欄,結果它補的是另一欄。至於「答錯的那幾題」,我本來以為會是一句「錯了六題」,寫到一半才發現這句話講不出口,因為我沒辦法乾淨地說它錯了。
由於內容實在太豐富,我決定把這段探索拆成四篇。今天,我們先把地基打好:定出欄位的三層境界,並看看回傳機率的模型(Jev)到底能幫我們補上哪一欄。
先用一張圖,把前五天撞過的牆串起來:
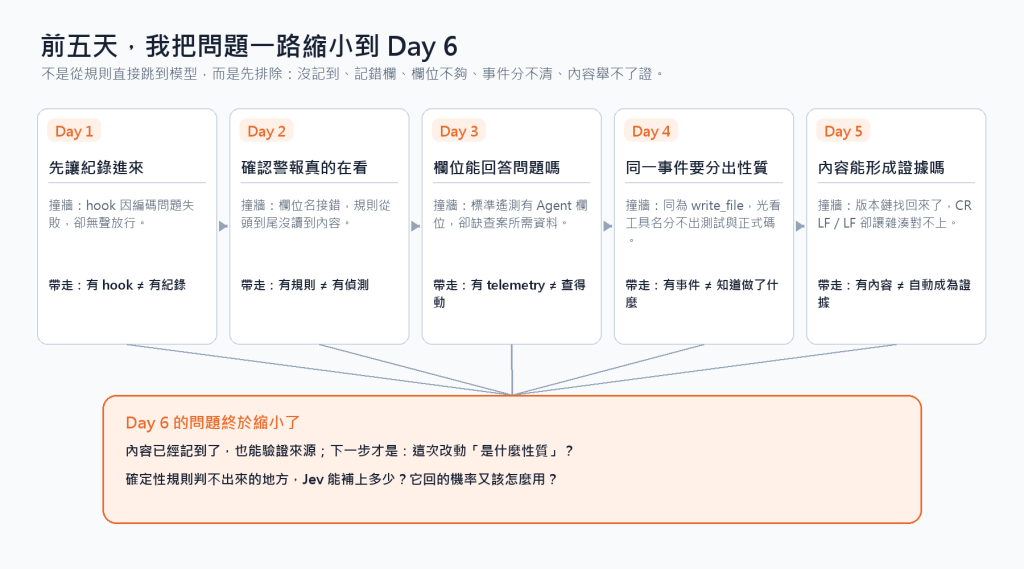
這五天不是一路「加功能」,而是一路排除更早的失敗:
走到這裡,問題才縮小成 Day 6 的樣子:內容已經記到了,也能驗證來源;接下來怎麼判斷這次改動的性質?確定性規則判不出來的地方,模型能補上多少?
有了這張路線圖,再看今天兩組資料的機率分佈:
【改動邏輯組 (n=64)】
0.0 - 0.1 █ 2
0.1 - 0.2 ▏ 1
0.2 - 0.3 █ 2
0.3 - 0.4 █▏ 3
0.4 - 0.5 ▏ 1
0.5 - 0.6  0
0.6 - 0.7 ▏ 1
0.7 - 0.8 █ 2
0.8 - 0.9 █▏ 3
0.9 - 1.0 ██████████████████████████████████████████████ 48

【憑證偵測組 (n=75)】
0.0 - 0.1 ███████████████████████████████████████████████████████████ 59
0.1 - 0.2  0
0.2 - 0.3  0
0.3 - 0.4  0
0.4 - 0.5  0
0.5 - 0.6  0
0.6 - 0.7 ▍ 4
0.7 - 0.8 ▏ 2
0.8 - 0.9  0
0.9 - 1.0 ██████████ 10
(註:這張極端的雙峰分佈圖,展示了絕大多數數據都擠在 0.0-0.1 與 0.9-1.0 兩端,中間幾乎是空的。這意味著它無法提供平滑的風險分數,要做排序必須靠其他訊號。)
這五天我一直在查「它做了什麼」。今天把要記的欄位攤開來,才看清楚問題在哪。欄位其實分三層,而我一直把它們混在一起講:
| 層 | 欄位 | 從哪裡來 | 記得到嗎 |
|---|---|---|---|
| 第一層:它動了什麼 | 時間、工具名、檔案路徑、寫入內容、內容雜湊 | hook payload 直接給 | ✅ 記得到 |
| 第二層:它動的是什麼性質 | 改的是測試還是正式碼、動到執行邏輯還是只動註解、有沒有移除斷言、有沒有碰到憑證 | 要自己分析內容 | ⚠️ 要花力氣,而且有上限 |
| 第三層:它憑什麼那樣動 | 依據哪句話、讀了哪份檔、為什麼選這個做法 | —— | ❌ 沒有來源 |
第三層不是「難記」,是根本沒有資料來源。
前兩層的欄位都能從 hook 拿到的內容推出來,第三層要的東西從來沒有流經 hook。這件事我前五天一直沒講清楚,因為我把它跟第二層的「要花力氣」混成一句「查不動」。
分開之後,今天要驗的題目就明確了:Jev 補得上第二層,還是第三層?
Jev(TypeSafe 的模型)不生成文字,只回一個 0 到 1 的機率。為了測試它,我準備了兩組真實歷史數據,一共問了 139 次:
ast.dump()。兩組都有標準答案,所以算得出它對錯。這是重點:沒有標準答案的時候,你沒有資格評估一個回機率的偵測器。 今天能做這件事,是因為前五天我們先把確定性的基準做出來了。
然而,當我把這 139 次的機率分佈畫出來時,我看到了上面那張極端的雙峰分佈圖。
這張圖告訴我們兩件事:
0.02 上就疊了 25 筆)。你如果想「把升級佇列照機率由高到低排,人從上面看下來」,排出來的順序其實跟沒排一樣。要排序,必須另外找別的訊號(例如改了什麼檔、動了幾行),不要硬用機率當排序鍵。從這兩組數據的加註過程中,我踩到了一個非常隱蔽的「資料衛生」陷阱。這是我這六天來第五次踩到同一個病,我把它總結成一條紀律:查不到就寫 null,不要寫 0。
在設計稽核紀錄時,對於模型的加註,我們必須嚴格區分三種狀態:
rec["jev"] = None          # 狀態一:沒問過(例如確定性層已經有答案,不需升級)
rec["jev"] = {"prob": 0.03, "model": "jev-1.13.0"}   # 狀態二:問了,模型說沒事
rec["jev"] = {"prob": None, "error": "timeout"}      # 狀態三:問了,但呼叫失敗或超時
如果你偷懶,把狀態三(呼叫失敗)也寫成 prob: 0,它在報表上會被讀成「問過了,確定沒事」,進而把你之後算的每一個平均值都往下拉,而且全程不會有任何紅燈或錯誤訊息。
資料衛生做好了,我們才能談下一步:這兩組實驗的數據,到底揭示了模型什麼樣的本質?
preToolUse 有 36 筆、postToolUse 有 35 筆,同一次工具呼叫的 pre 和 post 被算成了兩筆。15 個正例裡有 7 對是成對出現的,所以底層大約只有 8 個不同的事件。jev-latest 是會動的別名。 今天這些數字是 jev-1.13.0 跑的。過幾週重跑對不上,不代表哪邊做錯。明天,我們來看第一組實驗(憑證偵測)。我們會用真實數據看看:面對那些傳統 Regex 規則完全全盲的憑證洩漏,模型到底是如何把它們一筆一筆抓出來的?
今天對應的威脅: T3(藉 Agent 之手規避控制)。規避之所以划算,前提是事後舉不出證。今天我們釐清了「證據」的層次,定下了不容妥協的資料衛生紀律。
實驗與程式: 2026-09-19 跑、2026-09-20 重算。原始數據 data/day06-jev-secret.json(75 筆)、data/day06-jev-vs-ast.json(64 筆)。模型為 jev-1.13.0。本篇沒有引用外部來源。


 iThome鐵人賽
 看影片追技術