
上一篇的結論是一句原則:窗口裡要放「最小的高訊號詞元集合」。
原則很好,但它沒有回答最實際的那個問題:那一小段,是怎麼被找出來的?
這是第三層「外部知識」的第三篇,也是這一層的深水區。今天把檢索拆開:一份文件怎麼被切成塊、一段文字怎麼變成一串數字、「相關」到底是怎麼算出來的。而且會碰到一個洞:這條路上有一段,Claude 不做。
這個實驗不用寫程式,也不用金鑰。
第一步:打開你自己的一份長文件,找一句只有這份文件才答得出來的事實,例如某個參數的預設值。
第二步:從文件的第一個字開始往下數 400 個字元(character),在那裡畫一刀;再數 400 個,再畫一刀,一路切到底。空白、換行、全形標點,每一個都算一個字元,因為切塊器就是這樣數的:它拿到的是一長串字元,不是你眼睛看到的那個版面,段落與標題在它眼裡只是幾個換行符號。不想自己數的話,wc -m 會告訴你整份文件有幾個字元;在編輯器裡把一段選起來,狀態列也會報選了幾個字元。
然後看那句話落在第幾刀跟第幾刀之間,問自己兩個問題:
你剛剛做的就是切塊(chunking),而你剛剛擔心的兩件事,正是這一篇要量的東西。
真正的切塊器數的不一定是字元,也可能是詞元(token),而兩者差很多:第 4 篇那張圖裡,61 個字元被切成 38 個詞元。單位選哪一個,會改變刀落在哪裡,但不會改變這個實驗要你看的那兩件事。
第 5 篇借過 2020 年那篇 RAG 論文的分法:參數記憶是模型本身,非參數記憶是一個可以查的索引。當時說「你今天做的上傳,就是最土法的非參數記憶:沒有索引,也沒有挑選,整份送進去」。
今天補的就是被省略的那兩件事。完整的檢索長這樣,三步:
第三步結束之後,故事就回到第 5 篇:那幾塊變成 messages 裡的內容,跟著問題一起送進去做一次推論。模型永遠只看得到送進去的那些字,檢索改變的是「哪些字有資格被送進去」。
所以這一層真正的槓桿在前面兩步,而它們都不在模型裡。
這件事官方文件寫得很白(2026-09-20 查)。Embeddings 那一頁第一句就是:
Anthropic 沒有自己的向量化模型。
這是這個系列走到現在,第一次出現 Claude 不負責的一段。官方的處理方式是轉介:文件指向 Voyage AI,並且明講「這份指南接下來講的是 Voyage AI,但你應該自己評估多家供應商」。
實務上你會用到的規格是這些(2026-09-20 查):
| 面向 | 值 |
|---|---|
| 一般用途模型 | voyage-4(品質最好的是 voyage-4-large,最省的是 voyage-4-lite) |
| 單次輸入長度 | 32,000 詞元 |
| 向量維度 | 預設 1024,可選 256/512/2048 |
| 領域模型 | 程式碼 voyage-code-3、金融 voyage-finance-2、法律 voyage-law-2 |
三個實作上會踩到的細節:
input_type。 官方要求檢索情境一定要指定 input_type="query" 或 "document",不要省略。它做的事很樸素:在你的文字前面偷偷加一句提示詞,查詢那邊加的是 Represent the query for retrieving supporting documents: ,文件那邊是 Represent the document for retrieval: 。同一段文字,當問題和當文件,產生的向量不一樣。int8 省 4 倍,binary 省 32 倍。知識庫大到一定程度,這一條會變成成本問題。程式碼只有這麼長:
import voyageai

vo = voyageai.Client()   # 讀環境變數 VOYAGE_API_KEY

doc_embds = vo.embed(chunks, model="voyage-4", input_type="document").embeddings
query_embd = vo.embed([query], model="voyage-4", input_type="query").embeddings[0]

# 向量已正規化,內積就是餘弦相似度
similarities = np.dot(doc_embds, query_embd)
best = np.argmax(similarities)
向量化之後,每一塊變成 1024 個浮點數。你可以把它想成在一個 1024 維的空間裡放了一個點。三張圖把整件事走一遍:
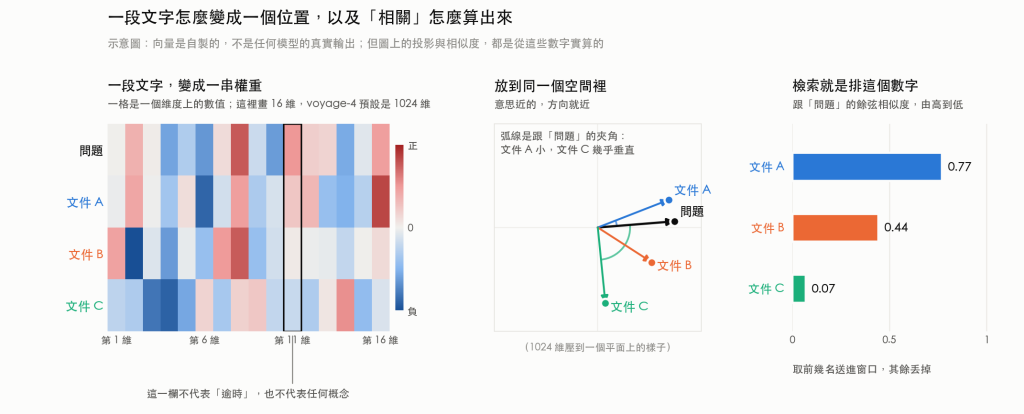
左邊是四段文字各自的向量,一格一個維度。「文件 A」跟「問題」的花紋比較像,而框起來的那一欄,四段文字都有值。
中間是把同樣四個向量壓到一個平面上。意思近的方向就近,而「近」是用夾角量的:文件 A 跟問題幾乎同方向,講部署測試的文件 C 幾乎垂直。
右邊就是檢索在做的事:把夾角換算成一個數字,由高到低排,取前幾名送進窗口。0.77、0.44、0.07 是從左邊那些權重實算出來的。
這張圖是示意。 圖上的向量是我為了說明捏出來的,不是任何模型的真實輸出,所以別拿那三個數字去對任何一家的結果(投影與相似度倒是從圖上那些數字實算的)。可以帶走的是形狀:一格一個權重、方向決定相關、相似度是算出來的一個數字。
圖上看得到的是形狀,底下這三件事決定了後面所有的取捨:
查詢的時候做的事只有一件:把問題也變成一個點,然後找離它最近的幾個點。 因為 Voyage 的向量長度被正規化成 1,算距離就是一個內積,快到可以對幾十萬塊即時算完。
這個距離量的是「看起來像同一類文字」,不是「這段話能回答這個問題」。 兩者高度相關,但不相等。所以檢索永遠會回傳「最像的幾塊」,就算那幾塊裡面根本沒有答案,它也會回傳,而且不會告訴你。
上一篇講可分心性的時候提過詞面與語意的推理落差,這就是它在向量端的版本:詞面的相似度算得出來,語意上的可用算不出來,而你拿到的排名是前者。
取幾塊(top-k)也是一個你要自己決定的參數。 取多了,答案比較可能在裡面,但窗口被佔掉更多;取少了則反過來。底下那份論文量的是取前 10 名與前 100 名兩種情況,而這兩種量出來的名次不一樣,等一下就會看到。
官方文件那張表裡,維度寫的是「預設 1024,可選 256/512/2048」。同一個模型為什麼可以吐出不同長度的向量?
因為它是用 Matryoshka 表徵學習訓練的(Kusupati et al., 2022,名字就是俄羅斯娃娃)。這種訓練法「把資訊以不同的粒度編碼進去」,粗的資訊排在前面、細的排在後面,所以你直接砍掉尾巴、只留前 256 維,剩下的仍然是一個可用的向量。論文在 ImageNet 上報的效果是:同樣的準確度,向量最多可以小 14 倍,檢索也快上同一個量級。官方文件給的截斷範例就是這麼做的:切前 N 維,再重新正規化。
但維度不只是成本,它同時是表達能力的上限。 On the Theoretical Limitations of Embedding-Based Retrieval(Weller et al., ICLR 2026)從學習理論推出一個很硬的結論:「能夠被某個查詢取出來的前 k 名文件組合,數量受限於向量的維度。」 也就是說,不管模型多強,有些文件組合就是不可能被同一個查詢取出來,因為那個空間裝不下那麼多種排法。
作者做了兩件事來證明這不是紙上談兵:他們直接拿測試集去最佳化向量,限制依然存在;又做了一個叫 LIMIT 的資料集,任務本身很簡單,目前最強的模型照樣失敗。他們的結論是這是單一向量這個範式的根本限制,不是資料不夠或模型不夠大。
檢索答不出來的時候,加大模型不一定有用。 它有可能不是「找不夠準」,而是「這個組合根本不在可取出的集合裡」。這也是為什麼實務上不會只靠一個向量,而會再接一層重排序(re-ranking),或混搭關鍵字檢索。
前六篇你只需要一個供應商;從這一篇開始,你的檢索品質綁在另一家公司的模型上,而它換版本的節奏、定價、退役時程都不歸 Claude 管。這不是缺點,是一個要自己做的決定:向量化要不要綁單一供應商,還是用開源模型自己跑。 Voyage 的 voyage-4-nano 是 Apache 2.0 授權、放在 Hugging Face 上,這條路開著。
這一篇講的是通用機制。 切塊、向量、距離,換成任何一家都一樣。Claude 在這條鏈上只負責最後一端:拿到那幾塊之後回答,並且標出處(那是下一篇的主題)。中間這一段是別人的,我照官方文件轉介的那一家寫。
切塊聽起來像雜事,但它決定了被找出來的單位長什麼樣子。到 2026 年,這件事終於有一份夠硬的公開研究:When Is Complex Chunking Worth It?(Caspari et al.,帕紹大學與 IT:U Linz,已被 ACM CIKM 2026 接受,CC BY 授權,程式與資料集都公開)。
它的規模是重點:八種切法、兩個語料(MS MARCO 來的 CoRE,以及維基百科來的 KILT 配 Natural Questions 的問題)、三個開源向量模型(Qwen-0.6B、embeddinggemma-300M、Snowflake-L V2),語料規模從 1 萬份逐級放大(CoRE 實際切到 100 萬份,KILT 切到全部 600 萬份)。量的不只是準不準:索引吞吐量、查詢吞吐量、尖峰記憶體都一起量,而且每一組比較都跑 Fisher 隨機化檢定(一萬次排列、對 28 組兩兩比較做 Bonferroni 校正),確認差距不是雜訊。
底下是 embeddinggemma 在 CoRE 上的 Recall@100(取前 100 名時,該找到的文件有沒有在裡面),按 100 萬份那一欄排序:
| 切法 | 1 萬份文件 | 100 萬份文件 |
|---|---|---|
| 每塊貼上標題(enriched title) | 82.55 | 57.27 |
| 固定長度(token,含重疊) | 82.73 | 57.09 |
| 句子邊界(sentence) | 82.55 | 56.00 |
| 每塊貼上全文摘要(enriched summary) | 82.36 | 55.64 |
| 只存一份摘要(summary) | 79.82 | 51.82 |
| 晚切(late chunking) | 80.18 | 50.54 |
| 語意切塊(semantic) | 80.00 | 48.00 |
| 情境化切塊(contextual,用模型替每一塊寫脈絡) | 82.18 | 貴到跑不完 |
三件事值得記下來:
切塊的方法大致有五種,由笨到聰明排,而越聰明的越貴:
| 切法 | 誰決定下刀的位置 | 代價 |
|---|---|---|
| 固定長度(fixed-size) | 數字:數到 N 個字元或詞元就切 | 最快,但完全不看內容 |
| 遞迴切塊(recursive) | 一組有優先順序的分隔符:段落不行才句子,句子不行才硬切 | 一樣快,邊界合理得多 |
| 結構切塊(structure-based) | 文件本來就有的標記:Markdown 標題、HTML 標籤、表格、程式碼區塊 | 文件沒結構就退化成固定長度 |
| 語意切塊(semantic) | 相鄰句子的向量距離:話題變了才下刀 | 整份文件要先跑一輪向量化 |
| 代理式切塊(agentic) | 模型:讀完整份文件再標出切點 | 每份文件付一次模型的錢,論文估 1 萬份的語料就要 10 到 15 美元 |
講再多不如看刀落在哪裡。拿這份文件當例子,問題是「連線逾時預設多久」:
## 連線設定

`request_timeout` 控制一次請求最久等多久,預設值是 30 秒。超過就丟 `TimeoutError`。

## 重試

預設不重試。要開的話設 `max_retries`,上限 5 次,間隔指數成長。
固定長度:跟你剛剛手動做的一樣,數到第 N 個字元就切,不看那裡是什麼。
…控制一次請求最久等多久,預設值是 30 ✂ 秒。超過就丟 `TimeoutError`。
「30」跟「秒」被分到兩塊去,兩塊都答不出那個問題。開頭那個 30 秒實驗,要你比的就是這個。
遞迴:先找空行,找不到才退一步找句號,所以刀只落在邊界上(上面那張表裡最接近它的是「句子邊界」那一列)。塊放得下的時候,標題會跟著本文一起走:
[塊 1] ## 連線設定
       `request_timeout` 控制一次請求最久等多久,預設值是 30 秒。超過就丟 `TimeoutError`。
[塊 2] ## 重試
       預設不重試。要開的話設 `max_retries`,上限 5 次,間隔指數成長。
看起來跟照結構切一樣,但它並不知道那一行是標題,只知道那裡有一個空行。同一節的內容一長、超過塊的上限,它就會挑一個句號切開,而後面那一塊不會再帶著「## 連線設定」。
結構:照標題切,所以每一塊都保證帶著自己的標題,節再長也一樣。這份文件本來就有標題,這一刀幾乎不用調。
語意:把相鄰的句子各自向量化,距離拉開的地方才下刀。
[塊 1] `request_timeout` 控制一次請求最久等多久,預設值是 30 秒。
       超過就丟 `TimeoutError`。
       ↑ 這兩句都在講逾時,向量距離近,不切
✂ 這裡話題換了,距離拉開,下刀
[塊 2] 預設不重試。要開的話設 `max_retries`,上限 5 次,間隔指數成長。
文件沒有標題、段落又亂的時候,這是唯一還找得到邊界的方法。
代理式:把整份文件交給模型,請它讀完再說該切在哪。它切出來的結果通常跟結構切塊很像,差別在於沒有標題可以照著切的時候它也切得出來,因為它讀得懂「30 秒」是在講哪一個參數。代價是每份文件一次模型呼叫。
兩個提醒。第一,那篇論文測的八種裡沒有結構切塊,因為它太依賴文件長什麼樣子,很難用同一組語料公平比較。沒有被測到不代表它差,你的文件如果是 Markdown 或程式碼,它往往是最省事又最準的那個,而且論文裡成績最穩的「每塊貼上標題」,做的正是同一件事的簡化版。
第二,這五種是可以疊的,實務上最常見的組合就是先照結構切一刀,塊還太大再用遞迴切。
要一個起點的話,論文的建議很直白:先用固定長度。 原文說它「因為簡單、索引快、省記憶體,而且成績常常不輸人,在多數大規模檢索場景仍是很強的預設值」;需要保住句子邊界再換句子切塊,代價是索引變慢;文件有標題就把標題貼上去,那是他們測出來最便宜的改善。
但沒有一種切法在所有設定下最好。 同一張表換一個向量模型、換一個語料、換一個語料大小,名次就會動,論文自己的結論句是「最好的方法取決於向量模型、資料集、語料大小與你要的那個指標」。所以切塊參數不能離開你的向量模型與你的語料單獨調。
上面那張表量的是 Recall@100:取前 100 名,該找到的有沒有被撈進來。論文同時量了另一個指標 NDCG@10:只看前 10 名,而且排得越前面分數越高。
換一個指標,名次就換一批人。 論文的說法是:用 NDCG@10 的時候,那些替每一塊補上文件層級資訊的做法(貼標題、貼摘要)比較強,因為它們擅長把最該排前面的那幾份推上去;改用 Recall@100,固定長度與句子切塊就追了上來。作者的結論是,一個在「直接排名」不夠好的切法,拿去當「第一階段撈回來」可能剛剛好。
這件事對你的意義是:先想清楚你要的是哪一種。撈回來之後還要再排一次(重排序,這一層後面會講),你該看的是召回率;直接把前幾塊送進窗口,你該看的是前幾名準不準。
而前幾名不準的代價,上一篇已經替你算過了:不相關的字進了窗口就要付注意力,就會變成第三種失效「可分心性」的材料。
檢索不是「找得到就好」,是「找得到,而且不要順便拖一堆垃圾進來」。
這份研究也要打幾個折。 它量的是開放領域的英文語料(MS MARCO 與維基百科),你的文件不長那樣;吞吐量與記憶體是他們那套實作、那台機器、那個 FAISS 設定上的數字,只能拿來比大小,不能當成絕對值;最貴的那幾種切法在最大的語料上跑不完,所以大規模的行為只看到一半;而且每一種切法都用同一組固定超參數,沒有各自調到最好,論文自己說這可能低估了個別方法的上限。
你的系統多了兩個你不太看得到的元件。 切塊器跟向量模型都不在模型裡,也都不會報錯。它們出問題的樣子就是「答案怪怪的」,跟提示詞寫壞了長得一模一樣。
抄來的參數不會是你的最佳解。 那篇論文最實用的結論就是這個:沒有一種切法在所有設定下最好,名次會隨著向量模型、語料、語料大小與你看的指標一起動。你在別人文章裡讀到的塊大小,是別人語料上的答案。
多了一個供應商,就多了一條依賴。 向量化那一段不在 Claude 手上:它的版本、定價與退役時程你都管不到,而換掉它就要把整個索引重算一次。
還有一個問題,這一篇沒有回答:你怎麼知道自己的檢索到底好不好?上面那些數字是別人在 MS MARCO 與維基百科上量的,不是你的。
多了什麼能力:知識庫不再是黑箱。你知道它被切成塊、變成向量、按距離取回,也知道這三步各自可以調什麼。
多付了什麼代價:兩個沉默的新元件(切塊器、向量模型)、一個新的供應商依賴,以及一組你還不知道怎麼在自己語料上量的數字。
檢索品質決定答案品質:召回率怎麼量、出處怎麼標。
這一篇的數字全是別人在公開語料上量的,而你的語料沒有人量過。
第 4 篇立的規矩是每上一層就用同樣的十題重跑一次,而第 5 篇重跑的時候刻意繞過知識庫、把那份筆記直接附在題目前面,理由寫在文章裡:知識庫會多出「有沒有被搜到」這個變數,而那一層要量的不是它。下一篇要處理的就是那個變數。
兩件事:在還沒有使用者、也沒有標註資料的情況下,怎麼自己生出一組「問題→正確段落」的配對,把召回率從別人的數字變成你的;以及答案回來之後,怎麼讓模型把出處標出來,讓你回得去核對它到底讀了哪一塊。順帶一提,今天官方那句「你應該自己評估多家供應商」沒有給方法,那筆帳也在下一篇還。
input_type 與量化的細節。


 iThome鐵人賽
 看影片追技術