
Day 7 的結果是:在門檻 0.50 下,模型(Jev)抓到了全部 15 筆憑證外洩,補上 Regex 漏掉的 6 筆。
今天要拆解一個在資安與稽核領域很常見的直覺:
「保險起見,把門檻調高一點比較嚴謹。」
先看這次實驗的結論:
在這組資料裡,0.90 不是更嚴謹,而是把模型的額外價值整段切掉。
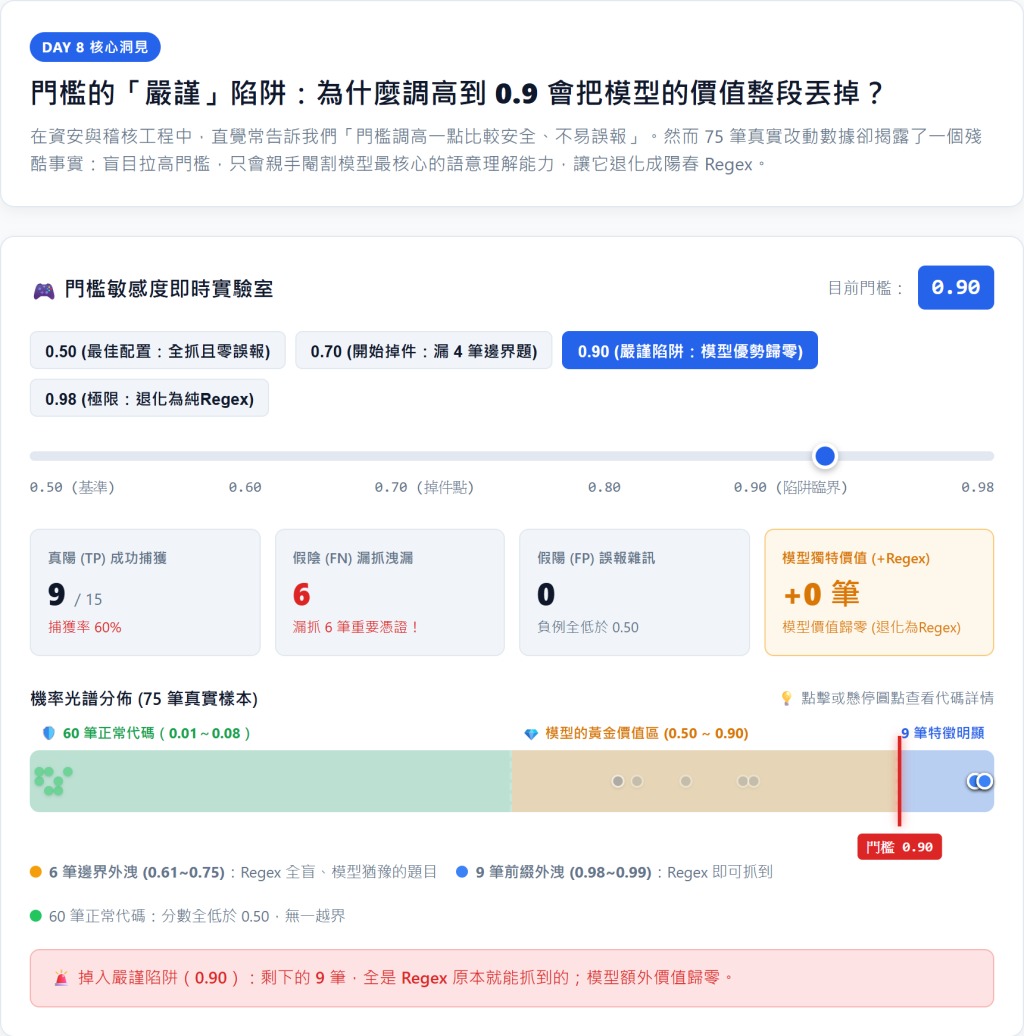
我把這組數據做成了可操作的互動圖。依序切換 0.50 → 0.70 → 0.90,觀察真陽、假陰與「模型額外貢獻」如何變化:
建議先停在 0.50,再一路拖到 0.90。當橘色樣本逐一變灰,就是模型原本補上的漏網之魚被門檻排除。
門檻調高到 0.90,模型額外價值歸零
門檻來到 0.90 時,誤報仍是 0,但漏抓增加到 6 筆;模型只剩下 Regex 原本就能抓到的 9 筆。
互動頁只是把本文同一組數據視覺化,不是另一組實驗,也沒有增加樣本數。
這裡的規則很簡單:
模型分數 ≥ 門檻,就送進待看清單;低於門檻,就不處理。
門檻越高,送進清單的項目越少。但「項目變少」不等於「判斷更正確」;還要看被排除的是誤報,還是真正的外洩。
把門檻從 0.50 一路拉到 0.98,結果如下:
| 門檻 | 真陽 TP | 假陰 FN | 假陽 FP | 真陰 TN | 召回率 |
|---|---|---|---|---|---|
| 0.50 | 15 | 0 | 0 | 60 | 100% |
| 0.70 | 11 | 4 | 0 | 60 | 73.3% |
| 0.90 | 9 | 6 | 0 | 60 | 60% |
| 0.95 | 9 | 6 | 0 | 60 | 60% |
| 0.98 | 9 | 6 | 0 | 60 | 60% |
這張表要分兩側讀。
60 筆負例的分數全部低於 0.50,大多落在 0.01~0.04。從 0.50 一路調高到 0.98,假陽始終是 0。
也就是說,把門檻設在 0.50,沒有付出額外的誤報代價。
真陽從 15 筆降到 9 筆,召回率從 100% 掉到 60%。門檻從 0.50 拉到 0.90,唯一明顯的變化,是多漏掉 6 筆真正的憑證外洩。
被 0.90 門檻排除的 6 筆,分數依序是:
0.61、0.61、0.63、0.68、0.74、0.75
回頭對照 Regex 的結果後,分佈非常整齊:
因此,門檻設成 0.90 時,模型留下的 9 筆,正好就是 Regex 原本已經抓到的 9 筆。
在這組資料裡,把門檻調到 0.90,模型就退化成原本那條 Regex。
它多出來的價值,恰好活在 0.50 到 0.90 之間。
因為它們比較難。
Regex 擅長抓明確特徵,例如固定前綴;遇到 auth_token 的底線邊界、註解或深層 JSON 等非典型位置,就可能無聲漏掉。模型能讀語意,因此有機會補上;但特徵不夠典型時,它也不會像看到固定前綴那樣有把握。
0.61~0.75,就是模型面對難題時「有訊號,但仍在猶豫」的樣子。
如果只因為 0.90 看起來更嚴謹,就把這段全部砍掉,等於刪除了當初引入模型的主要理由。
而且這次沒有任何回報:誤報本來就是 0,提高門檻並沒有讓精確度變得更好,卻讓偵測能力少了四成。
如果負例集中在門檻附近,或一次誤報會造成昂貴的阻擋成本,提高門檻可能合理。但那要由三件事共同決定:
門檻要由資料與成本決定,不是挑一個看起來比較嚴謹的數字。
既然 0.50 在這組資料上表現這麼好,模型分數能不能直接當成「Agent 洩漏憑證」的證據?
答案是:不能。
證據至少要具備三個性質:
模型給出的 0.68 不具備同等程度的穩定性與可檢驗性。相同輸入重跑可能有小幅波動;分數也無法拆成一條所有人都能逐步驗證的推理鏈,更不存在跨情境通用的客觀門檻。
但它很適合回答另一個問題:
這一筆要不要叫人來看?
這就是 Routing(分流)。它不負責定罪,只負責把有限的人工注意力送到更值得檢查的地方。
| 用途 | 需要具備的條件 | 判錯的代價 |
|---|---|---|
| 當證據 | 可重算、可拆解、可反駁 | 結論站不住,整份報告可能作廢 |
| 當分流訊號 | 比亂猜好,且誤報成本可接受 | 人多看一筆,或漏看一筆 |
所以在 Reliable Hook 的設計裡:
機率不進結論,只進待看清單。
紀錄也必須把分數與具體模型版號一起保存,例如 jev-1.13.0,而不是會移動的 jev-latest。否則三個月後,就無法說清楚當時是哪個模型做出的判斷。
明天,我們來看第二組實驗:執行邏輯偵測。我會帶你拆解模型「答錯」的 6 題,以及另一個更深的問題:
當基準本身只是代理指標時,我們要怎麼定義模型「答錯了」?
今天對應的威脅: T1(憑證外洩)。這組數據顯示,提高門檻可能在沒有降低誤報的情況下,直接犧牲偵測能力。
實驗與程式: 2026-09-19 執行、2026-09-20 重算。原始數據 jev-lab/day06-jev-secret.json(75 筆),模型為 jev-1.13.0。互動頁使用同一組數據;本篇沒有引用外部研究作為結論依據。


 iThome鐵人賽
 看影片追技術