

我們解決了超長文本無法一次塞入模型的問題,透過 Paragraph-aware Chunking 與 n8n 的 Loop 節點,成功將長文切塊並逐一獲得了多份「局部摘要」。但是,當一篇文章被切成 5 塊,我們就會得到 5 份獨立的 JSON 摘要。這些摘要之間可能有重複的概念,也缺乏全域的連貫性。在一個完整的 AI 知識管家中,我們最終需要的是「單一」且「結構化」的完整筆記,以便在 Phase 5 自動寫入 Notion 資料庫。我們該如何將這些破碎的局部知識,重新揉合成一篇完整的總結?
核心概念:Map-Reduce
為了解決這個問題,我們引入了分散式系統中常見的 Map-Reduce 概念:
透過這種「先拆解、再組合」的策略,我們能在不觸發 Token 上限、不發生 Attention 丟失的前提下,完美處理任何長度的輸入。
它在完整架構中的位置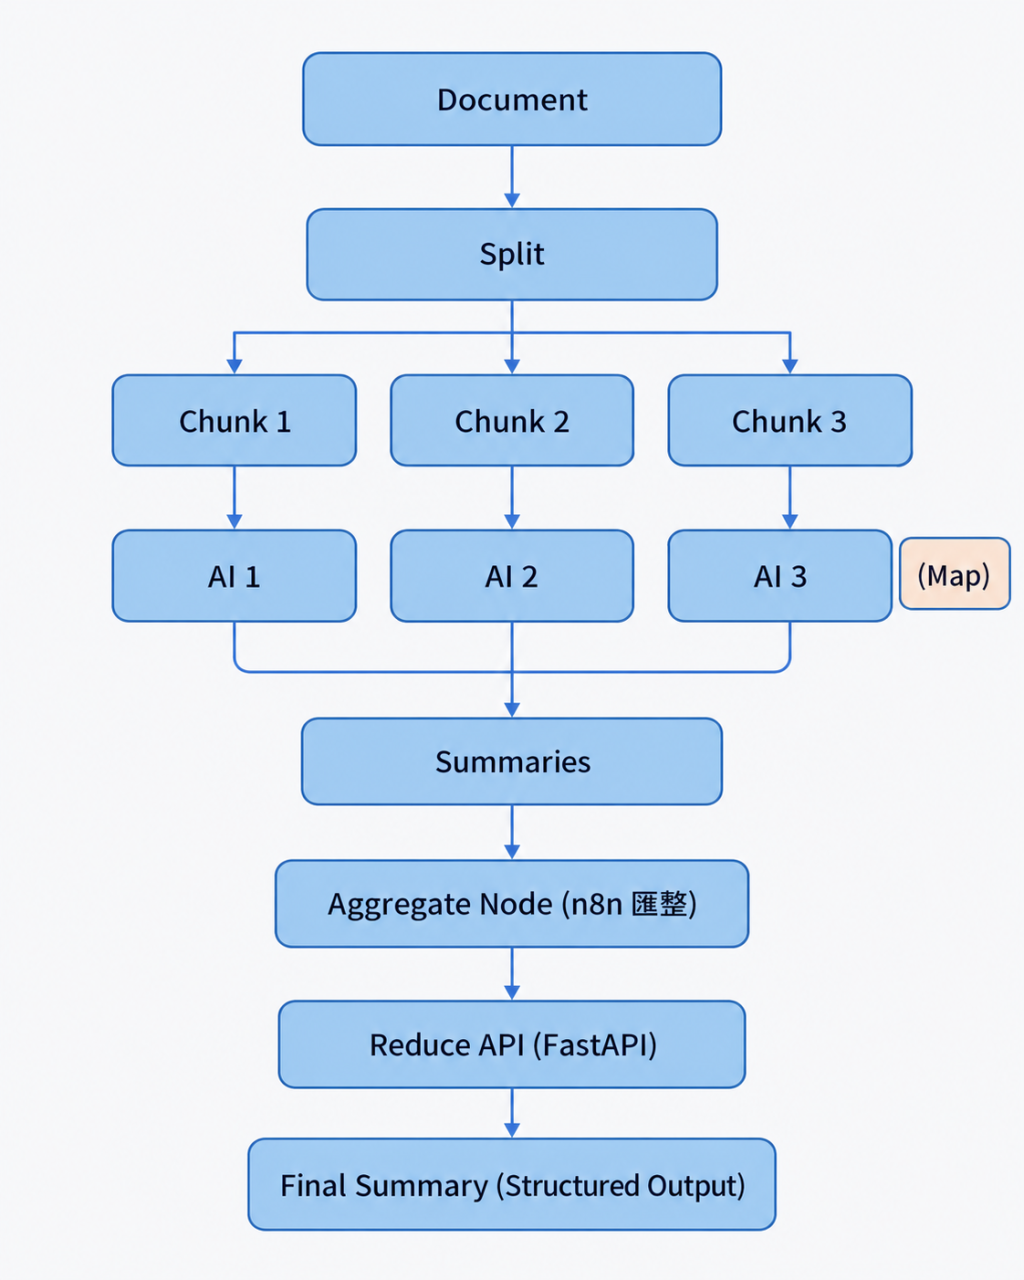
我們需要建立一個 /reduce-summary 的端點。這個端點的任務不再是閱讀原始長文,而是閱讀「多份摘要的集合」,所以我需要在 FastAPI 新增以下內容
class ReduceRequest(BaseModel):
    aggregated_text: str

@app.post("/reduce-summary")
def reduce_summary(data: ReduceRequest):
    try:
        prompt = f\"\"\"
        你是一個專業的知識管家。以下是從一篇長篇文件(如論文或長文)中分段萃取出來的多份局部摘要(以 JSON 陣列形式呈現)。
        請將這些局部摘要重新組織,消除重複提及的概念,並融合成一篇語意連貫的最終總結。

        局部摘要總集:
        {data.aggregated_text}
        \"\"\"

        # 強制套用 Structured Output
        response = model.generate_content(
            prompt,
            generation_config=genai.GenerationConfig(
                response_mime_type="application/json",
                response_schema=ArticleSummary,
            )
        )

        ai_result = json.loads(response.text)

        return {
            "status": "success",
            "data": ai_result
        }
    except Exception as e:
        raise HTTPException(status_code=500, detail=str(e))
n8n 實作:匯整與呼叫
回到 n8n Workflow,我們要處理 Loop 節點跑完後的資料:
1. 聚合資料 (Aggregate Node)
接在 Loop 節點的 Done 分支後方。
Aggregate(或 Combine)。data(這是你上一關 /summarize 回傳摘要所在的欄位名稱)。關閉 Rename Field。data 的大型陣列。2. 呼叫 Reduce API (HTTP Request Node)
接在 Aggregate 節點後方。
POST
http://host.docker.internal:8000/reduce-summary
JSON
aggregated_text
{{ JSON.stringify($json.data) }}
JSON.stringify 將 data 陣列轉換為 JSON 格式的文字字串,這樣 AI 才能正確讀取結構化的內容。技術細節:因為 FastAPI 端點預期接收純字串,所以我們必須使用 JSON.stringify 將 data 陣列轉換為 JSON 格式的文字字串,這樣 AI 才能正確讀取結構化的內容。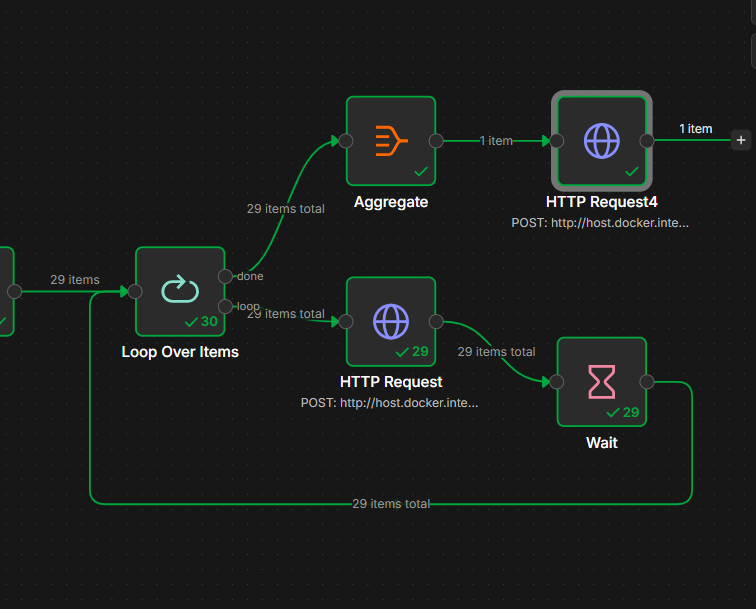
把複雜的問題拆分成獨立的子任務,再將結果匯總,這種運算思維是突破現有模型物理限制(如 Context Window 與 Rate Limit)最有效的方法。這套架構不只適用於摘要,未來若要做整本電子書的分析或超大型 Log 檔的稽核,都能沿用這套 Map-Reduce 管線。


 iThome鐵人賽
 看影片追技術