

隨著各大語言模型的 Context Window 越來越大,很多人會有一個迷思:「既然模型支援 100 萬個 Token,那我把整本電子書、整部一小時的 YouTube 影片字幕,全部塞進同一個 API Request 就好了吧?」
在概念上可行,但在打造穩定運行的 AI Automation 系統時,這絕對是一場災難。把超長文本一次塞給模型,會面臨以下致命問題:
因此,我們需要一套 Chunking 機制。要將長文本切塊,常見的策略有以下幾種:
\n\n)的邊界進行切割。這就像是保有語意完整性的記憶體分頁,確保每一個 Chunk 都有完整的上下文。今天我們將實作最符合人類閱讀邏輯的 Paragraph-aware Chunking + Overlap。
FastAPI 實作:Paragraph-aware Chunking
打開 main.py,加入以下端點:
class ChunkRequest(BaseModel):
    text: str
    max_chars: int = 2000
    overlap_paras: int = 1

def paragraph_aware_chunker(text: str, max_chars: int, overlap_paras: int) -> list[str]:
    text = text.replace('\r\n', '\n')

    raw_paragraphs = [p.strip() for p in text.split('\n\n') if p.strip()]

    paragraphs = []
    for p in raw_paragraphs:
        if len(p) <= max_chars:
            paragraphs.append(p)
            continue

        sub_paragraphs = [sp.strip() for sp in p.split('\n') if sp.strip()]
        for sp in sub_paragraphs:
            if len(sp) <= max_chars:
                paragraphs.append(sp)
            else:
                for i in range(0, len(sp), max_chars):
                    paragraphs.append(sp[i:i+max_chars])

    chunks = []
    current_chunk_paras = []
    current_length = 0

    for p in paragraphs:
        p_len = len(p)

        if current_length + p_len > max_chars and current_chunk_paras:
            chunks.append("\n\n".join(current_chunk_paras))

            current_chunk_paras = current_chunk_paras[-overlap_paras:] if overlap_paras > 0 else []
            current_length = sum(len(para) for para in current_chunk_paras)

        current_chunk_paras.append(p)
        current_length += p_len

    if current_chunk_paras:
        chunks.append("\n\n".join(current_chunk_paras))

    return chunks

@app.post("/chunk-text")
def chunk_text(data: ChunkRequest):
    chunks = paragraph_aware_chunker(data.text, data.max_chars, data.overlap_paras)
    return {
        "status": "success",
        "total_chunks": len(chunks),
        "chunks": chunks
    }
n8n 實作:Workflow 中的排程調度
資料切塊後,FastAPI 回傳的不再是一包單純的文字,而是一個 chunks 陣列。
這時,我們不能把整個陣列平行砸給 Gemini API,否則極易觸發 Rate Limit。在 n8n 中,我們需要引入 Loop 節點:
Done 分支輸出。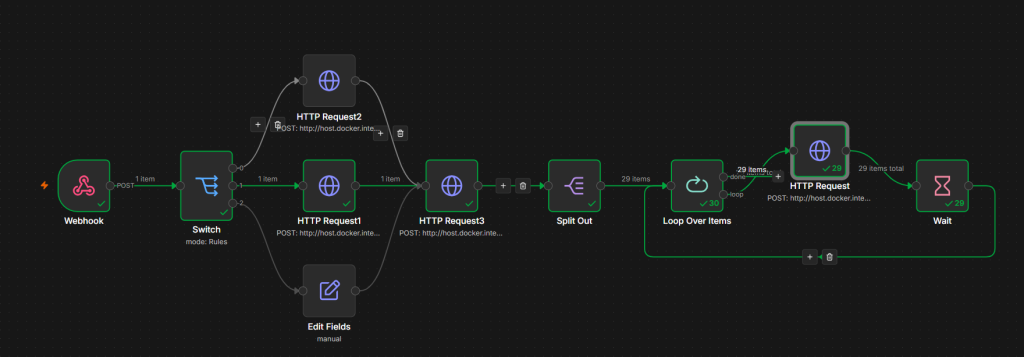


 iThome鐵人賽
 看影片追技術