
Day 5 已經成功把 Process Monitor 與 Detection Engine 接起來。
目前的流程是:
Linux /proc
↓
Process Monitor
↓
Process Event / Command Event
↓
Detection Engine
↓
Detection Rules
↓
Alert
但昨天實作完之後,我發現一個很大的問題:
BehaviorGuard 每執行一次,只會掃描一次 /proc,分析完成之後程式就結束。
這比較像「拍一張照片」,而不是真正的監視器。
因此 Day 6 的目標是:
把 Snapshot Detection 改成 Continuous Monitoring(持續監控)。
原本 BehaviorGuard 的流程:
啟動
↓
掃描 /proc
↓
取得 Process
↓
Detection
↓
結束
如果 Process 存在的時間很長,例如:
nc -l -p 9999
BehaviorGuard 很容易看到它。
但是像 curl 這種可能很快就執行結束的 Process:
Process 出現
↓
執行
↓
Process 結束
↓
BehaviorGuard 才開始掃描
這樣 BehaviorGuard 就完全不知道它曾經出現過。
因此今天開始加入 Continuous Monitoring。
目前 BehaviorGuard 採用的方式是 Polling(輪詢)。
概念很簡單:
掃描 /proc
↓
等待 1 秒
↓
再次掃描 /proc
↓
等待 1 秒
↓
再次掃描
↓
...
直到使用者按下 Ctrl+C 才停止。
因此 BehaviorGuard 啟動後,不會像之前一樣分析一次就結束,而是會顯示:
BehaviorGuard
[INFO] Continuous monitoring started.
[INFO] Press Ctrl+C to stop.
接著持續等待新的 Process 出現。
如果每次掃描都把所有 Process 重新分析,就會產生另一個問題。
例如:
zsh
↓
nc
第一次掃描:
BG-PROC-002 MATCH
↓
Alert
第二次掃描時 nc 還活著:
BG-PROC-002 MATCH
↓
又 Alert
這樣同一個 Process 每秒都可能產生一次警報。
因此今天加入了 seen_pids。
PID 是 Linux 用來識別 Process 的編號。
BehaviorGuard 啟動時,先記錄目前已經存在的 PID。
例如:
100
200
300
下一次掃描發現:
100
200
300
400
其中 PID 400 沒有看過,因此可以判斷:
PID 400 = New Process
只有新的 Process 才送進 Detection Engine。
這次實作還遇到另一個問題。
假設:
zsh(舊 Process)
↓
nc(新 Process)
如果 Detection Engine 只拿到 nc,就不知道它的 Parent 是 zsh。
但是我們的 BG-PROC-002 要判斷的是:
Shell → Network Tool
因此還是需要完整的 Process 資料來尋找 Parent。
最後的設計變成:
所有 Process
↓
建立 Process Map
↓
用來查詢 Parent / Child 關係
New Process
↓
送進 Detection Engine
↓
執行 Detection Rules
簡單來說:
全部 Process 用來了解關係,新的 Process 才需要進行 Detection。
首先啟動 BehaviorGuard:
python3 -m agent.process_monitor
BehaviorGuard 開始持續監控:
[INFO] Continuous monitoring started.
接著在另一個 Terminal 執行:
nc -l -p 9999
這次不需要重新啟動 BehaviorGuard。
下一次 Polling 時,BehaviorGuard 自動發現新的 nc Process,並取得:
Process : nc
Parent : zsh
Command : nc -l -p 9999
接著送進 Detection Engine。
最後成功觸發:
[ALERT] BG-PROC-002
Rule : Shell Spawned Network Tool
Severity : MEDIUM
代表目前的流程已經變成:
Kali
↓
New Process
↓
/proc
↓
Process Monitor
↓
Detection Engine
↓
BG-PROC-002
↓
Alert
↓
繼續監控
產生第一次 BG-PROC-002 Alert 後,我讓 nc 繼續執行。
BehaviorGuard 後續掃描並沒有每秒重新產生 BG-PROC-002。
原因是 nc 的 PID 已經被記錄在 seen_pids。
因此:
nc 第一次出現
↓
New PID
↓
Detection
↓
Alert
↓
記錄 PID
下一次掃描
↓
PID 已經看過
↓
不重新分析
這樣可以避免同一個 Process 不斷產生重複 Alert。
Snapshot 是觀察某一個時間點的狀態。
Continuous Monitoring 則是持續觀察系統變化。
對 Endpoint Detection 來說,只看單一時間點很容易錯過後來才發生的行為,因此持續監控非常重要。
Polling 可以理解成:
「每隔一段時間,主動去問一次有沒有新的東西。」
目前 BehaviorGuard 每隔 1 秒重新讀取 /proc。
這個方式容易理解,也適合目前的 Prototype,但它不是完美的。
今天實作時想到一個問題:
如果每 1 秒掃描一次,但某個 Process 只存在 0.2 秒呢?
例如:
第 0 秒:BehaviorGuard 掃描
第 0.2 秒:Process 出現
第 0.4 秒:Process 結束
第 1 秒:BehaviorGuard 再次掃描
這個 Process 就可能完全沒有被看到。
因此目前的 /proc Polling 仍然有偵測上的限制。
之後可以研究更事件導向的 Endpoint Telemetry 收集方式,改善短生命週期 Process 可能被漏掉的問題。
今天 BehaviorGuard 從:
Snapshot Detection
進化成:
Continuous Monitoring
↓
Polling /proc
↓
New Process Detection
↓
Process Relationship
↓
Detection Engine
↓
Alert
↓
PID 去重
↓
繼續監控
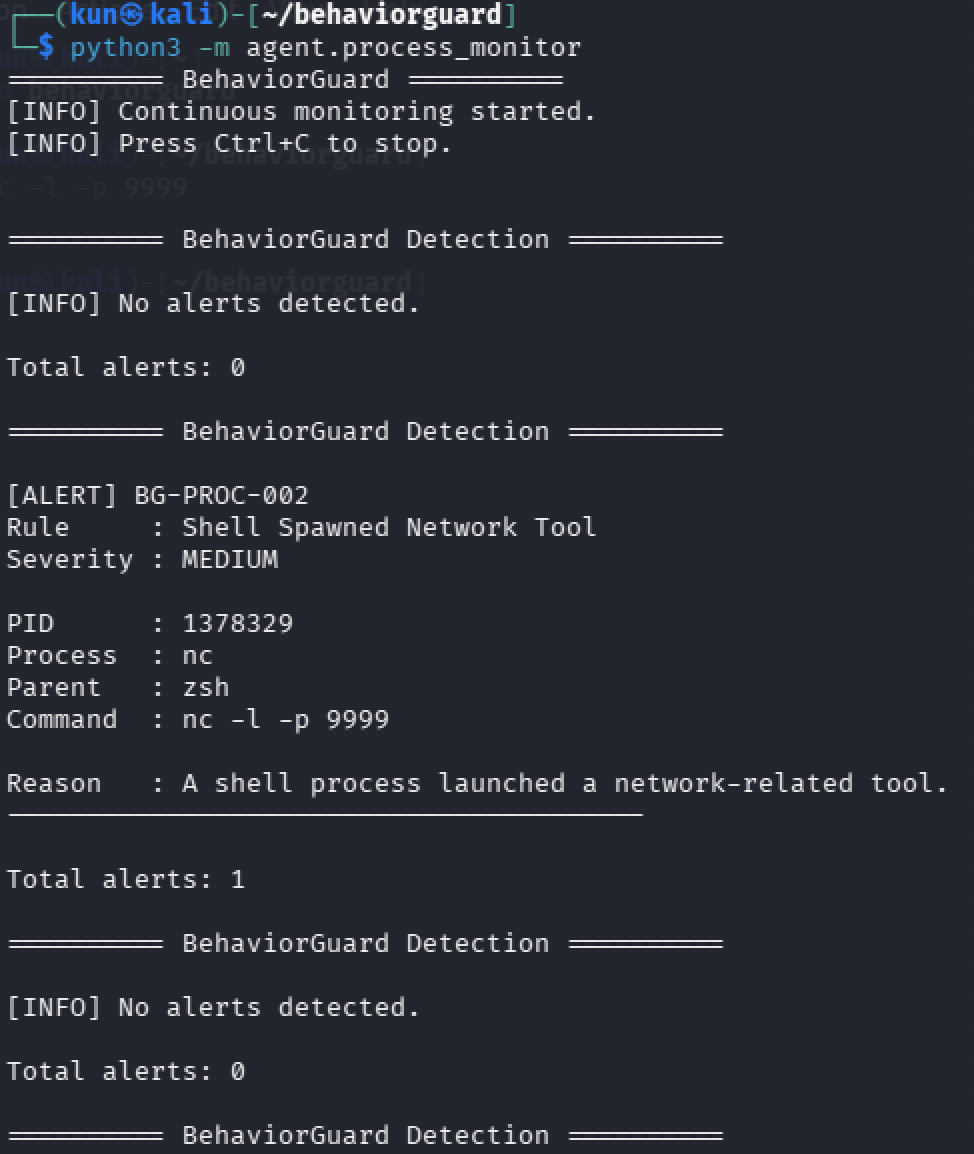
目前 BehaviorGuard 已經可以在啟動後持續等待新的 Process,並在新的行為符合 Detection Rule 時自動產生 Alert。
Day 6 最大的改變,就是 BehaviorGuard 不再只是「拍一張照片」。
而是開始變成一台會持續運作的「監視器」。

 kunyo

 iThome鐵人賽
 看影片追技術