
🔀 subagent 先換到的是乾淨的主對話:大量的測試輸出、log 留在它那邊,主對話只收一份摘要。多開幾個會不會快,看分出去的工作重疊多少;重疊的部分,開再多個也省不到時間,還可能改出互相衝突的結果。
昨天在 Day 12|Memory 記住的事,過期了怎麼辦?,我們看了 Claude Code 的 auto memory 怎麼把交代帶到下一個 session,和它過期時怎麼辦。今天回到同一個 repo,看把工作交給 subagent(分出去做子任務的 Agent)換到的是什麼,多開幾個又什麼時候才會比較快。
快速回顧一下:Day 10 看過 CLAUDE.md 在 session 開始時進到模型輸入,今天會看到 subagent 啟動時也有一份,主對話講過的話卻帶不過去。Day 11 看過 Context 快滿時怎麼壓縮、摘要要查得回原文;subagent 讓大量輸出一開始就不進主對話,交回來的報告也是一份摘要。
假設你用 Claude Code 維護那個電商 repo。ORM 套件升了一個大版本,你請 Claude 跑 npm test,掛了 40 個,分散在訂單、付款、購物車和報表四個目錄,錯誤看起來各不相同:購物車的小計算出 '1200.0060.00',付款的測試說金額不是數字。你跟它說:「開四個 subagent 分頭修,一個目錄一個。」
Claude 開了四個 subagent,在背景同時跑。二十幾分鐘後四份報告陸續回來,每份都說自己那個目錄修好了。Claude 再跑一次全套測試,你也翻了 subagent 的紀錄檔:
src/db/money.ts 被三個 subagent 各改了一處:一個用 Number(),一個用 parseFloat(),一個換成 decimal 函式庫npm test、讀了同一份升級說明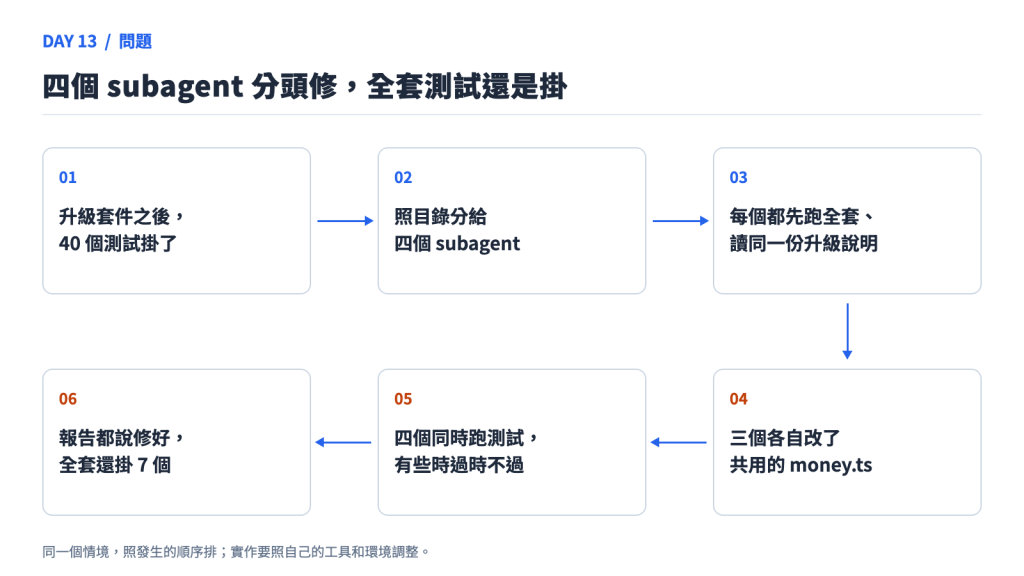
圖:升級套件之後 40 個測試掛了 → 照目錄分給四個 subagent → 每個都先跑全套測試、讀同一份升級說明 → 三個各自改了共用的 money.ts → 四個同時跑測試,有些測試時過時不過 → 報告都說修好,全套還掛 7 個。這是示意,實作要照自己的工具和環境調整。
二十幾分鐘過去,工作沒做完,還多出要收拾的東西。這次分工換到一件事:四個 subagent 跑的測試、讀的升級說明,都留在它們自己那邊,主對話只收到四份報告。時間沒省到,而這幾條線索有個共通點:四份工作重疊了。四個都重查了一次同樣的東西,三個改了同一個檔案,四個共用同一個測試資料庫。哪一種重疊拖得最久,要量過才知道。
下面先看開一個 subagent 換到什麼、Harness 要替它決定哪幾件事、它啟動時手上有什麼,再算多開幾個的時間,接著沿這 40 個測試走一遍怎麼切、交代什麼、改完怎麼驗,最後對照別的 Harness,看自己刻 Harness 至少要記什麼。
Claude Code 本身就是一個 Harness。主對話開一個 subagent,等於另外跑一個 Day 1 那樣的 loop:它有自己的 Context,自己讀檔、跑測試,做完只把一份報告交回主對話。
Claude Code 的 subagent 文件第一段就講它拿來做什麼:旁支工作會把搜尋結果、log、檔案內容灌進主對話,這些東西之後又不會再看,就交給 subagent 在它自己的 Context 裡做完,只交回摘要。文件列的好處,第一條也是保住主對話的 Context。同一套文件的 best practices 開頭就講為什麼要保:Context 很快就會滿,越滿模型表現越差,可能開始忘記前面的指示、犯更多錯。
放回開頭的情境:npm test 掛 40 個的完整輸出、升級說明、翻過的原始碼,如果都在主對話裡讀,之後每一輪都會跟著送進模型,直到 Context 快滿、被 Day 11 講的壓縮壓成摘要。交給 subagent,這些留在它那邊,主對話只多一份報告。Anthropic 的 Context engineering 文章給過一個數字:subagent 可能用掉幾萬 token 探索,交回的摘要通常只有 1,000 到 2,000 token。這個好處開一個 subagent 就拿得到,不用同時開好幾個。
代價有兩個。第一個是起步。文件也列了哪些情況留在主對話比較好,其中兩條跟今天有關:幾個階段要共用大量背景,例如規劃、實作、測試一路做下來;還有在意速度,因為 subagent 從零開始,要花時間收集背景。
從零開始要多少,我自己量了一次。在我這台的設定下,用 Claude Code v2.1.280 開一個一般的 subagent,只叫它讀一個檔案的第一行,第一次送出的輸入就有約 4 萬 token;換成內建的 Explore 問一個不用讀檔的問題,約 1.6 萬,它的工具比較少,也不載入說明檔。每次前後都要 7 到 13 秒,而主對話前面講過的話,兩邊的輸入裡一句都沒有。每個 subagent 的紀錄檔在 ~/.claude/projects/<專案>/<session>/subagents/,把每筆回覆 usage 裡的幾種輸入 token 加起來,就是這個數字。
第二個是主對話只看得到摘要:報告沒寫到的,主對話就不知道。這點留到報告回來那節再講。
Day 1 說過,Harness 決定模型看得到什麼、被允許做什麼、做完之後怎麼確認。subagent 既然是另一個 loop,這三件事都要替它重新決定一次;一次開好幾個,還多一件:能不能同時跑。
| 要決定的事 | 開頭那次看到的狀況 |
|---|---|
| 看得到什麼:帶哪些東西出發,主對話知道的事怎麼交給它 | 四個都先跑一次 npm test、讀同一份升級說明 |
| 被允許做什麼:能用哪些工具、能改哪裡、最多跑幾輪 | 三個都改了各自目錄外的 src/db/money.ts |
| 能不能同時跑:划不划得來、會不會搶同一批檔案或資源 | 二十幾分鐘沒做完;有些測試時過時不過 |
| 做完怎麼確認:交回什麼、主對話自己再驗什麼 | 四份報告都說修好,全套還掛 7 個 |
開頭那次要的是速度,關鍵在分出去的工作重疊多少:前三件決定會不會重疊,第四件負責把漏掉的重疊抓出來。Claude Code 對這四件事都有答案,有的寫在文件裡,有的要實測才看得到。接下來幾節,每節看它怎麼答其中一兩件。
Claude Code 文件列了 subagent 啟動時帶著哪些東西,實測的結果大致對得上,只差一行。省略兩邊都有的環境資訊和工具清單,並排是這樣:
主對話
  Claude Code 的 system prompt
  CLAUDE.md(使用者層、專案層)
  auto memory 的索引 MEMORY.md
  git status
  你講過的話、Claude 讀過的檔案、跑過的測試結果

一般的 subagent(general-purpose 或自訂的)
  它自己的 system prompt
  CLAUDE.md(使用者層、專案層)
  auto memory 的索引 MEMORY.md       ← 文件說不載入,v2.1.280 實測有
  git status
  Claude 寫給它的派工訊息

內建的 Explore
  它自己的 system prompt
  Claude 寫給它的派工訊息
開頭那四個是一般的 subagent,跟主對話差最多的是最後一行。主對話前面跑過的測試、看過的錯誤訊息,subagent 都看不到,它手上只有 Claude 寫的那段派工訊息。派工訊息如果只寫「修好 payments 目錄裡掛掉的測試」,哪些測試掛、錯誤是什麼,它就得自己再跑一次才知道;四個 subagent 各跑一次,開頭就會看到四次全套測試。
auto memory 那一行,文件寫主對話的不會載入;我在 v2.1.280 開一般的 subagent,它說得出 MEMORY.md 的第一行,紀錄檔裡也看得到那份索引,Explore 就沒有。文件和實測對不上的地方,版本一更新可能又變,要 subagent 知道的事,還是寫進派工訊息比較穩。Explore 連 CLAUDE.md 都不載入,文件的建議也一樣:一定要它遵守的規則(文件的例子是「不要碰 vendor/ 目錄」),請 Claude 派工時再講一次。
想讓 subagent 知道前面的事,Claude Code 還有一種叫 fork 的 subagent(用 /subtask 開,Claude 也會自己開):它帶著整段對話出發,跟主對話共用 prompt cache,起步比較便宜。文件建議在「別的 subagent 要補太多背景才用得上」的時候用它。換成 fork,開頭重跑測試那段可以省掉,四個改到同一個檔案、共用同一個測試資料庫的問題還在。
分工省下的是等待。幾件工作互不相干時,總時間大約是:
總時間 ≈ 分工 + 最慢的那個子任務 + 合併 + 驗證
開再多個,都要等最慢的那個回來。Anthropic 的研究系統寫到他們目前的做法:主 Agent 等整批 subagent 做完才往下走,只要一個 subagent 還在查,整個系統就停在那裡。回來之後的合併和驗證,也不會因為人多而變短。
token 也要算。同一篇的數據是,Agent 平均用掉聊天的 4 倍 token,多 Agent 系統約 15 倍。換到的是:他們內部的研究評測裡,Opus 4 帶著 Sonnet 4 subagent,比單獨一個 Opus 4 高出 90.2%;讓主 Agent 同時開 3 到 5 個 subagent、subagent 也同時用多個工具之後,複雜查詢的研究時間最多少了 90%。
這些是研究任務,要查的方向彼此不用等。文章自己也寫,大多數 coding 工作能同時進行的部分比研究少,需要共用同一份背景、彼此依賴很深的工作,目前不適合多 Agent。
Anthropic 2026 年 1 月另一篇談什麼時候該用多 Agent 的文章講得更直接:同樣的工作,平行跑比一件一件跑快,可是總運算量變多,多 Agent 系統的總時間常常比單一 Agent 還長;平行主要換到的是涵蓋得更完整。我的判斷是:分出去的工作互不重疊,時間才有機會變短;有沒有變短,要拿同一件工作量過才知道。
開頭照目錄切,看起來很公平,一個目錄十個。可是把 40 個失敗一個個追到源頭,31 個是同一件事:金額欄位讀回來從數字變成字串,這些金額都從 src/db/money.ts 讀出來。購物車的字串相接、付款的「不是數字」,都是它。四個 subagent 在各自的目錄裡撞到同一個原因,其中三個各修了一次。
Anthropic 的 Nicholas Carlini 讓 16 個 Claude 平行寫一個 C 編譯器,文章裡寫到很像的情況。測試套件裡的失敗各自獨立時,平行很簡單,每個 Agent 挑一個不同的失敗去修。拿去編 Linux kernel 就卡住了:整個 kernel 是一件大工作,每個 Agent 都撞到同一個 bug、各自修掉,再互相蓋掉對方的修改,開 16 個也沒幫上忙。
他的解法是拿 GCC 當對照:kernel 大部分檔案交給 GCC 編,隨機留一批給 Claude 寫的編譯器,壞了就知道問題在這批裡。每個 Agent 分到的是不同檔案裡的不同 bug,才又能平行。那 16 個是各自在 container 裡跑、透過 git 合併的 Claude Code session,上面沒有主對話派工;這裡借的是撞到同一個原因的那一段。
Claude Code 文件講平行調查時也加了條件:各條調查路徑互不依賴時效果最好。開頭那 40 個,31 個像 kernel,剩下 9 個才像各自獨立的失敗,所以我會這樣排:
① 開一個 subagent 跑全套測試,只回報哪些掛、各自追到什麼原因
② 主對話修 money.ts,再跑一次全套            ← 31 個同一個原因,只修一次
③ 剩下 9 個分三組,確認不改同樣的檔案 → 各開一個 subagent,或直接自己修
④ 合併之後,全套測試跑一次
第一步要的是主對話乾淨。文件的例子是用 subagent 跑測試,只回報失敗的測試和錯誤訊息;這裡再請它把每個失敗追到原因、分好類。大量的測試輸出留在 subagent 那邊,主對話只收到分好類的清單。第二步刻意不平行,31 個測試卡在同一個檔案,分給誰都要改到它。第三步才輪到平行;只剩 9 個的話,我多半直接在主對話修,開 subagent 的起步成本可能比省下的還多。
Claude Code 內建的 /batch 也是先拆再平行:它先研究 codebase,把跨整個 codebase 的大規模修改拆成 5 到 30 個互不相依的單位,列出計畫等你確認;確認後每個單位開一個背景 subagent,各自在獨立的 worktree 裡實作、跑測試、送出修改。
研究系統那篇有個例子。主 Agent 早期給的指令很短,像「研究半導體短缺」,結果一個 subagent 去查 2021 年的車用晶片危機,另外兩個查的都是 2025 年的供應鏈,重複做了同一件事。他們後來要求每個 subagent 都要拿到目標、輸出格式、該用的工具和來源,和清楚的任務邊界。
以第三步的付款那一組為例,我會希望 Claude 寫給 subagent 的派工訊息長這樣:
目標:修好 test/payments/ 裡 4 個失敗的測試,清單和錯誤訊息附在下面。
已知:套件升級後金額欄位讀回來是字串,src/db/money.ts 已經修好(commit 3f2a1c)。
範圍:只改 src/payments/ 和 test/payments/,不要改 src/db/ 底下的檔案。
不要做:不要跑全套測試,只跑 test/payments/。
交回:改了哪些檔案、每個測試改前改後的結果、沒修好的和原因;
      懷疑是共用問題的,只回報,不要自己改。
這幾行對上 Anthropic 列的目標、輸出格式、工具和來源、任務邊界;「已知」那行,補的是主對話裡 subagent 看不到的東西。
有些限制可以直接寫在 Claude Code 的設定裡,不用每次靠派工訊息。自訂 subagent 的 tools 只給 Read、Grep、Glob,它就改不了檔案;內建的 Explore 本來就不能寫檔;isolation: worktree 讓它在獨立的 worktree 裡改;maxTurns 限制它最多跑幾輪,到上限時交回的結果會標成沒做完。範圍和交回格式,還是要寫在派工訊息裡。
Claude Code 的 worktree 文件開頭就說,worktree 隔開的是檔案修改:每個 subagent 在自己的目錄、自己的分支上改,改檔不會蓋到別人的。放回開頭的情境,至少還有三件事它管不到。
第一件,同一個檔案還是會被改三次,只是撞在一起的時間延到合併。三個 subagent 在各自的複本裡改 money.ts,彼此看不到,各跑各的測試都會過。合併時,改到同一行的,例如一個寫 Number(v)、一個寫 parseFloat(v),git 會報衝突,要有人選一種;改在不同行的,git 會自動合起來,同一個檔案裡就混著兩種寫法。
第二件,測試資料庫和 port 不在 repo 裡。worktree 只複製 git 追蹤的檔案,.env 這類被 git 忽略的檔案要另外用 .worktreeinclude 帶過去,帶過去的資料庫連線還是同一個。開頭那幾個時過時不過的測試,我會先懷疑這裡:例如付款的測試一開始先清空訂單表,購物車的測試剛好寫進一筆訂單等著讀回來,就會讀到空的,換個先後又會過。同時啟動測試用的伺服器,也會搶同一個 port。
第三件,預設不是從你現在的進度開始。文件寫,subagent 的 worktree 預設從遠端的預設分支開出來;要從本機目前的進度開,得把 worktree.baseRef 設成 "head"。第二步在主對話修好、commit 了但還沒 push 的 money.ts,第三步開的 subagent 在自己的 worktree 裡看不到,跑測試又會看到那些已經修過的失敗,可能再去改一次 money.ts。
Shopify 的安全掃描,把能同時跑的和會搶資源的分開跑。他們內部叫 Dispatch 的系統先把程式碼切成幾個分區,每個分區派一個找漏洞的 Agent(他們叫 Hunter)同時跑,交出來的只是候選漏洞。接著由驗證的 Agent 寫測試、實際跑,確認漏洞成不成立;這一段一個接一個跑,因為同時跑會在 port、資料庫和 fixture 上撞在一起。文章也提到,有一次掃描找出 30 多個候選漏洞,驗證完每一個都被降成中低風險、判定為誤報,或改列為額外的防護。
要讓 subagent 各跑各的測試,每個 worktree 就要連自己的測試資料庫、用自己的 port;全套測試留到合併之後,一次跑一個。
主對話保住 Context 的代價,是它拿到的只剩摘要。研究系統那篇的做法,是讓 subagent 把成果寫到檔案裡,只把位置交回主 Agent,少掉一手傳一手的失真。這跟 Day 11 要摘要查得回原文是同一件事:報告裡寫「改了 3 個檔案、4 個測試都過了」,主對話要找得到那 3 個檔案和那次測試結果。
Claude Code 會替報告做兩個標記。subagent 跑到 maxTurns 上限,或被 API 錯誤中斷,交回的結果會註明它沒做完;報告前面也會加一行標頭,說明這是 subagent 的話,裡面的指示和「已經核准」之類的說法,都不算你的授權。
Anthropic 2026 年 1 月那篇點出,負責驗證的 subagent 最常見的錯是跑一兩個測試、看到通過就宣布成功。開頭四份報告都說修好,主對話只看報告,不會知道全套還掛 7 個。所以報告回來,主對話還是要先看 git diff 有沒有改到範圍以外的檔案,自己重跑那一組測試,再決定收不收。
乾淨的 Context 在驗證這一步也用得上。Claude Code 的 best practices 建議,工作算完成之前,開一個新的 subagent 審 diff:它只看得到 diff 和你給的標準,看不到寫出修改時的推理,只能照結果判斷。文件也提醒,叫它找問題,它通常就會回報一些,要講明只回報影響正確性的。
前面那四件事,Claude Code 的答案只是其中一種。OpenAI Agents SDK 同一套工具裡就有兩種開子 Agent 的方式,「看得到什麼」和「做完怎麼確認」的答案剛好相反:
input_filter 過濾交過去的對話。開頭的主對話至少收得到四份報告,才有機會重跑全套測試、發現還掛 7 個。用 handoff 的話,結果不會先回到主 Agent 手上,主 Agent 也就沒機會先檢查。
帶多少對話出發,由誰決定也不一樣。Claude Code 是模型派工時自己選要不要開 fork,你可以關掉 fork mode 不讓它選,也可以用 /subtask 自己開。LangChain 的 Deep Agents(他們在 LangChain 上做的一套 Harness,內建子 Agent)則是開發者定義子 Agent 時就寫好:預設只看得到派工內容,設成 fork 才帶上主 Agent 的對話和 system prompt,fork 目前還是 beta。自己刻 Harness,這個選擇要交給模型,還是寫死在設定裡,也要先想好。
用 Claude Code 的話,上面這些大多靠 Claude 寫派工訊息時照著做,加上你在 subagent 設定裡限制工具。自己刻 Harness,就得把這些記成資料。沿用付款那一組,至少要有下面這幾欄,前面那四件事各對到兩欄:context 和 base/known 管看得到什麼,tools 和 write_scope 管被允許做什麼,resources 和 depends_on 決定能不能同時跑,tests 和 status/report 用來確認結果。少了哪一欄,派工、執行或收結果時就有一件事判斷不了:
| 欄位 | 這個情境的值 | 誰讀寫 |
|---|---|---|
| task_id/goal | T3:修好 test/payments/ 裡 4 個失敗的測試 | 主 Agent 派工時寫 |
| context | system prompt、專案說明檔、派工訊息;不帶主對話 | 主 Agent 派工時定;Harness 啟動 subagent 時照著組輸入 |
| base/known | 從 commit 3f2a1c 開始;money.ts 已修,附錯誤清單 | 主 Agent 寫進派工訊息;開 worktree 時從這個 commit 開 |
| tools | 讀檔、改檔、跑測試;不給 git push | 主 Agent 派工時選;executor 擋清單外的呼叫 |
| write_scope | src/payments/、test/payments/ | 派工前比對重疊;executor 擋範圍外的寫入 |
| resources | test_db_payments | 派工前比對有沒有跟別組共用 |
| depends_on | 無(要等的 money.ts 已經修完) | 派工前檢查要不要等 |
| tests | test/payments/ | 主 Agent 收結果時重跑 |
| status/report | done、partial 或 failed;改了哪些檔、測試結果、沒修好的 | subagent 交回;主 Agent 檢查 |
def can_run_together(tasks):
    for i, a in enumerate(tasks):
        for b in tasks[i + 1:]:
            if overlaps(a.write_scope, b.write_scope):   # 會改到同一批檔案
                return False
            if a.resources & b.resources:                # 共用測試資料庫、port
                return False
            if a.task_id in b.depends_on or b.task_id in a.depends_on:
                return False                             # 要等對方的結果
    return True

def accept(task, report, diff, run_tests):
    if report.status != "done":                          # 沒做完的不合併
        return "continue_or_narrow"
    if any(not in_scope(f, task.write_scope) for f in diff.files):
        return "reject"                                  # 改到範圍外
    if not run_tests(task.tests).passed:                 # 主 Agent 自己重跑
        return "reject"
    return "merge"
| 誰呼叫 | 什麼時候 | 結果 |
|---|---|---|
主 Agent 呼叫 can_run_together() |
開頭照目錄切的四份,派工前 | 四份各寫自己的目錄,檢查會過;它們實際都去改了 src/db/money.ts,要靠 executor 擋範圍外的寫入,或 accept() 看 diff 時攔下 |
主 Agent 呼叫 can_run_together() |
第三步的三組,派工前 | 範圍不重疊、各用自己的測試資料庫、不用互相等,可以同時跑 |
主 Agent 呼叫 accept() |
付款那組交回報告 | diff 都在範圍內、重跑 test/payments/ 通過,合併;跑到 maxTurns 標成 partial 的話不合併,接著做或縮小範圍再派 |
第一列是這個檢查的界線:它只知道派工時寫下的範圍,subagent 實際改了哪裡,要靠執行時擋、收結果時對。
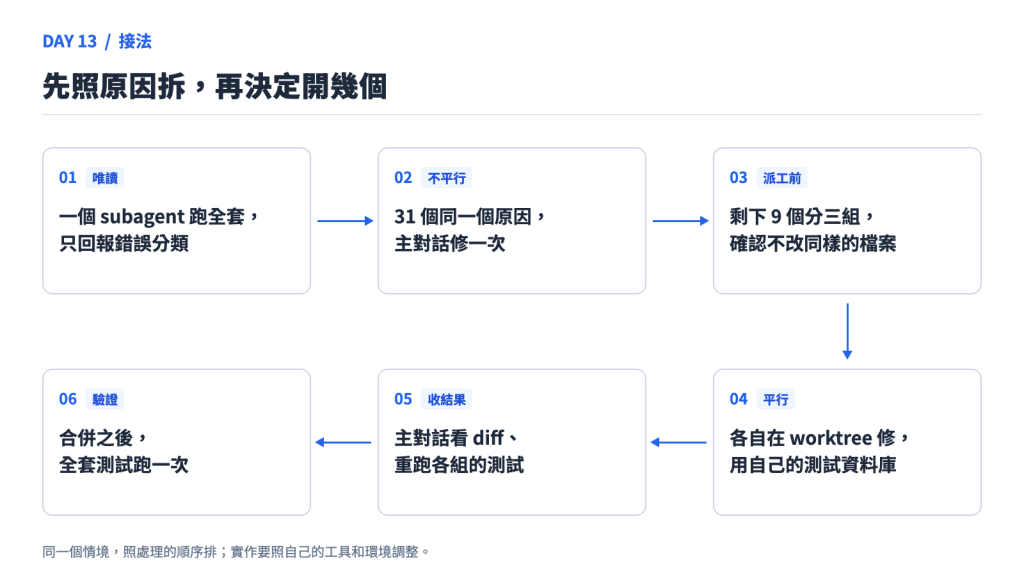
圖:一個 subagent 跑全套測試,只回報錯誤分成幾類 → 31 個同一個原因,在主對話修一次 → 剩下 9 個分三組,確認不會改到同樣的檔案 → 各自在 worktree 裡修,用自己的測試資料庫 → 主對話看 diff、重跑各組的測試 → 合併之後,全套測試跑一次。這是示意,實作要照自己的工具和環境調整。
假設你已經做到 Day 12:Agent 記下的 memory 看得到、帶著條件,更新時會比對版本。現在要把工作分給 subagent,我會照這個順序加:
第一步,只把唯讀、輸出很多的工作交出去。 跑全套測試、翻 log、在大 repo 裡找東西,交給 subagent 或內建的 Explore,只收回整理過的結果,修改留在主對話。這一步只求主對話乾淨,還不用管重疊。自己的 Harness 就只給這類 subagent 讀取的工具。
第二步,派工訊息寫清楚範圍和交回格式。 目標、已知的事、能改哪裡、不要做什麼、交回什麼。回報要附改了哪些檔案和測試結果,主對話查得回去。
第三步,真的要同時改檔才開 worktree,再把共用資源分開。 測試資料庫、port 各用各的,全套測試等合併後跑一次。拿同一件工作,跟只用主對話的做法各跑一次,比總時間和 token,才知道分工有沒有省到。
一個人用 Claude Code、改動集中在少數幾個檔案,做到第一步就夠了。第三步是給分散在很多模組、彼此不相干的修改,/batch 也是為這種修改做的。
我自己用得比第一步多。訂了幾個方案,token 基本上用不完,subagent 就開得很兇:spec 定好之後,開一個 subagent 照 spec 實作,再開另一個來 review。這兩個一前一後跑,靠的是前面講的乾淨 Context,沒有平行。不過最近模型越來越強,這套開發方式之後可能還要慢慢調整,至少目前可以確定 superpowers 那套冗長的流程在模型變強的情況下已經逐漸式微,後面很期待大家又研究出什麼有趣的 flow。
另外,第二步說的派工訊息,在 Claude Code 裡是 Claude 讀懂任務之後自己整理的,不用人來寫。我們頂多提示它可以開 subagent,要不要平行、開幾個,多半是它自己決定。自己刻 Harness 的話,第二步要顧的是主 Agent 派工時會把這幾樣寫進去。
後面還會往這裡加東西:Day 14 到 16 看每個 Agent 手上的工具怎麼設計,Day 26 把所有 subagent 的花費算進同一份預算。
回到這 40 個測試,可以試著問自己:四個 subagent 一人一個目錄,換到了什麼,又為什麼可能比一個 Agent 自己修還慢?每個 subagent 都在自己的 worktree 裡改,合併之後還需要再跑一次全套測試嗎?
第一題,換到的是乾淨的主對話:40 個失敗的完整輸出和升級說明都留在 subagent 那邊,主對話只收四份報告。慢是因為四份工作重疊得很多:四個都重跑一次測試、讀一次升級說明;40 個裡有 31 個卡在同一個檔案,三個 subagent 各修了一次;四個又共用同一個測試資料庫。重疊的部分平行也省不到時間,起步成本卻多付了四份,回來之後的合併和驗證也還在。
第二題要。worktree 讓檔案的重疊晚一點才撞在一起:三種 money.ts 的改法到合併時還是得選一種;測試資料庫和 port 不在 repo 裡,各自跑過,放在一起也不一定會過。
subagent 先換到的是乾淨的主對話,開一個就有。想再換到時間,先把重疊的部分挑出來、只做一次,剩下互不相干的,才值得同時開。
明天回到每個 Agent 手上的工具:名稱和參數都給了,模型為什麼還是選錯、填錯?我們會把工具當成操作介面,看看哪些地方讓它多猜了一步。
CLAUDE.md、git status,看不到對話歷史,文件寫主對話的 auto memory 不載入;Explore 唯讀、不載入 CLAUDE.md 和 git status;fork 帶著整段對話、共用 prompt cache,Claude 可以自己開 fork,fork mode 決定它能不能開;tools、isolation、maxTurns 設定;平行調查在路徑互不依賴時效果最好;用 subagent 跑測試、只回報失敗的例子;報告的標頭和沒做完的標記。.env 要靠 .worktreeinclude 帶過去;subagent 的 worktree 預設從遠端的預設分支開,worktree.baseRef 設成 "head" 才從本機目前的進度開;subagent 可以用 isolation: worktree 各自在 worktree 裡改。/batch 先研究 codebase、拆成 5 到 30 個互不相依的單位,確認後每個單位由背景 subagent 在獨立的 worktree 裡實作、跑測試。input_filter 改。as_tool 開的子 Agent 不會自動繼承主 Agent 的對話。mode 預設 isolated,只看得到派工內容;設成 fork 才帶上主 Agent 的對話和 system prompt,目前是 beta。

 iThome鐵人賽
 看影片追技術