
Day 17:狀態管理,讓寫作代理人記得前幾天寫過什麼 結尾留下一句明確的懸念,架構、查證、正確性、狀態記憶到今天都已經各自有了具體的機制,但篇幅較長或邏輯層次較深的段落,寫作代理人要如何維持論證的緊密度不鬆散,這個問題今天還沒有答案。今天要正面回答這個問題。
先把 Day 17 留下的問題完整覆述一次。架構有了、查證有了、程式碼正確性有了、跨篇狀態記憶也有了,這幾件事到 Day 17 結束時都已經各自到位。但篇幅較長或邏輯層次較深的段落,寫作代理人要如何維持論證的緊密度不鬆散,這個問題到目前為止還沒有答案。
今天要正面回答這個問題。答案的方向是,長篇論證與公式推導這類內容,不能沿用一般段落展開的節奏一次寫完,需要更細的展開單位。
在往下走之前,先把今天的任務範圍畫清楚。今天只定義長篇論證與公式推導本身的撰寫策略原則,不涉及審查代理人的角色,也不做完整跑一次流程的實戰示範,這些都留給後面的天數處理。今天要交出的,是長篇論證或公式推導這類內容,究竟該用什麼樣的工作模式展開,才不會在通順的文字底下藏著站不住腳的邏輯。
先回答一個更根本的問題,為什麼長篇論證或公式推導的緊密度,值得單獨拿出來討論。
回顧 Day 01:為什麼傳統的「一鍵生成」寫不出好的長篇技術文章? 定案的注意力稀釋病灶。長篇技術文章需要同時處理兩種性質完全不同的認知任務,第一種是宏觀邏輯推理,處理整篇文章的論述順序是否合理,前後段落是否呼應,讀者的認知負擔是否被妥善鋪陳。第二種是微觀細節查證,處理某個函式的參數名稱是否正確,某段程式碼是否真的可執行,某個版本號對應的語法是否已經過時。這個病灶從一開始定義的時候,就涵蓋這兩側。
Day 16:程式碼生成的正確性保證機制 處理的是微觀細節查證這一側,聚焦在程式碼範例是否真的可執行、版本是否正確,這一側的判準明確,讀者只要把範例貼進開發環境跑一次,對或錯立刻現形,是這個病灶最容易被讀者親手驗證出來的受害戰場。
今天要處理的,是宏觀邏輯推理這一側。聚焦在整篇文章或整段論證的論述順序是否合理,前後推論是否呼應。這一側原本就是 Day 01 定義裡的另一半,只是在 Day 16 把焦點收斂到程式碼範例之後,這一側一直還沒有被任何一天正面處理過。
為什麼長篇論證或公式推導特別容易在這一側出問題。這類內容的宏觀邏輯推理密度遠高於一般敘述性段落,一般段落即使論述順序稍有鬆動,讀者往往還是能跟上大意,但長篇論證或公式推導的每一步都建立在前一步之上,一旦模型的注意力被迫在顧全局與摳細節之間做取捨,這類內容首當其衝,因為它對「前後推論是否真的呼應」的要求,比一般段落嚴苛得多。
Day 16 補上的是微觀細節查證那一側,今天要補上的,是 Day 01 定義裡尚未被填滿的另一側。
具體描繪一個畫面。一段較長的論證或一段公式推導,如果要求模型一次完整生成,讀起來往往非常通順,用詞流暢、銜接自然,讀者第一次讀過去不會察覺任何異狀。
但通順的文字表面,不代表底下的邏輯鏈條真的是完整的。
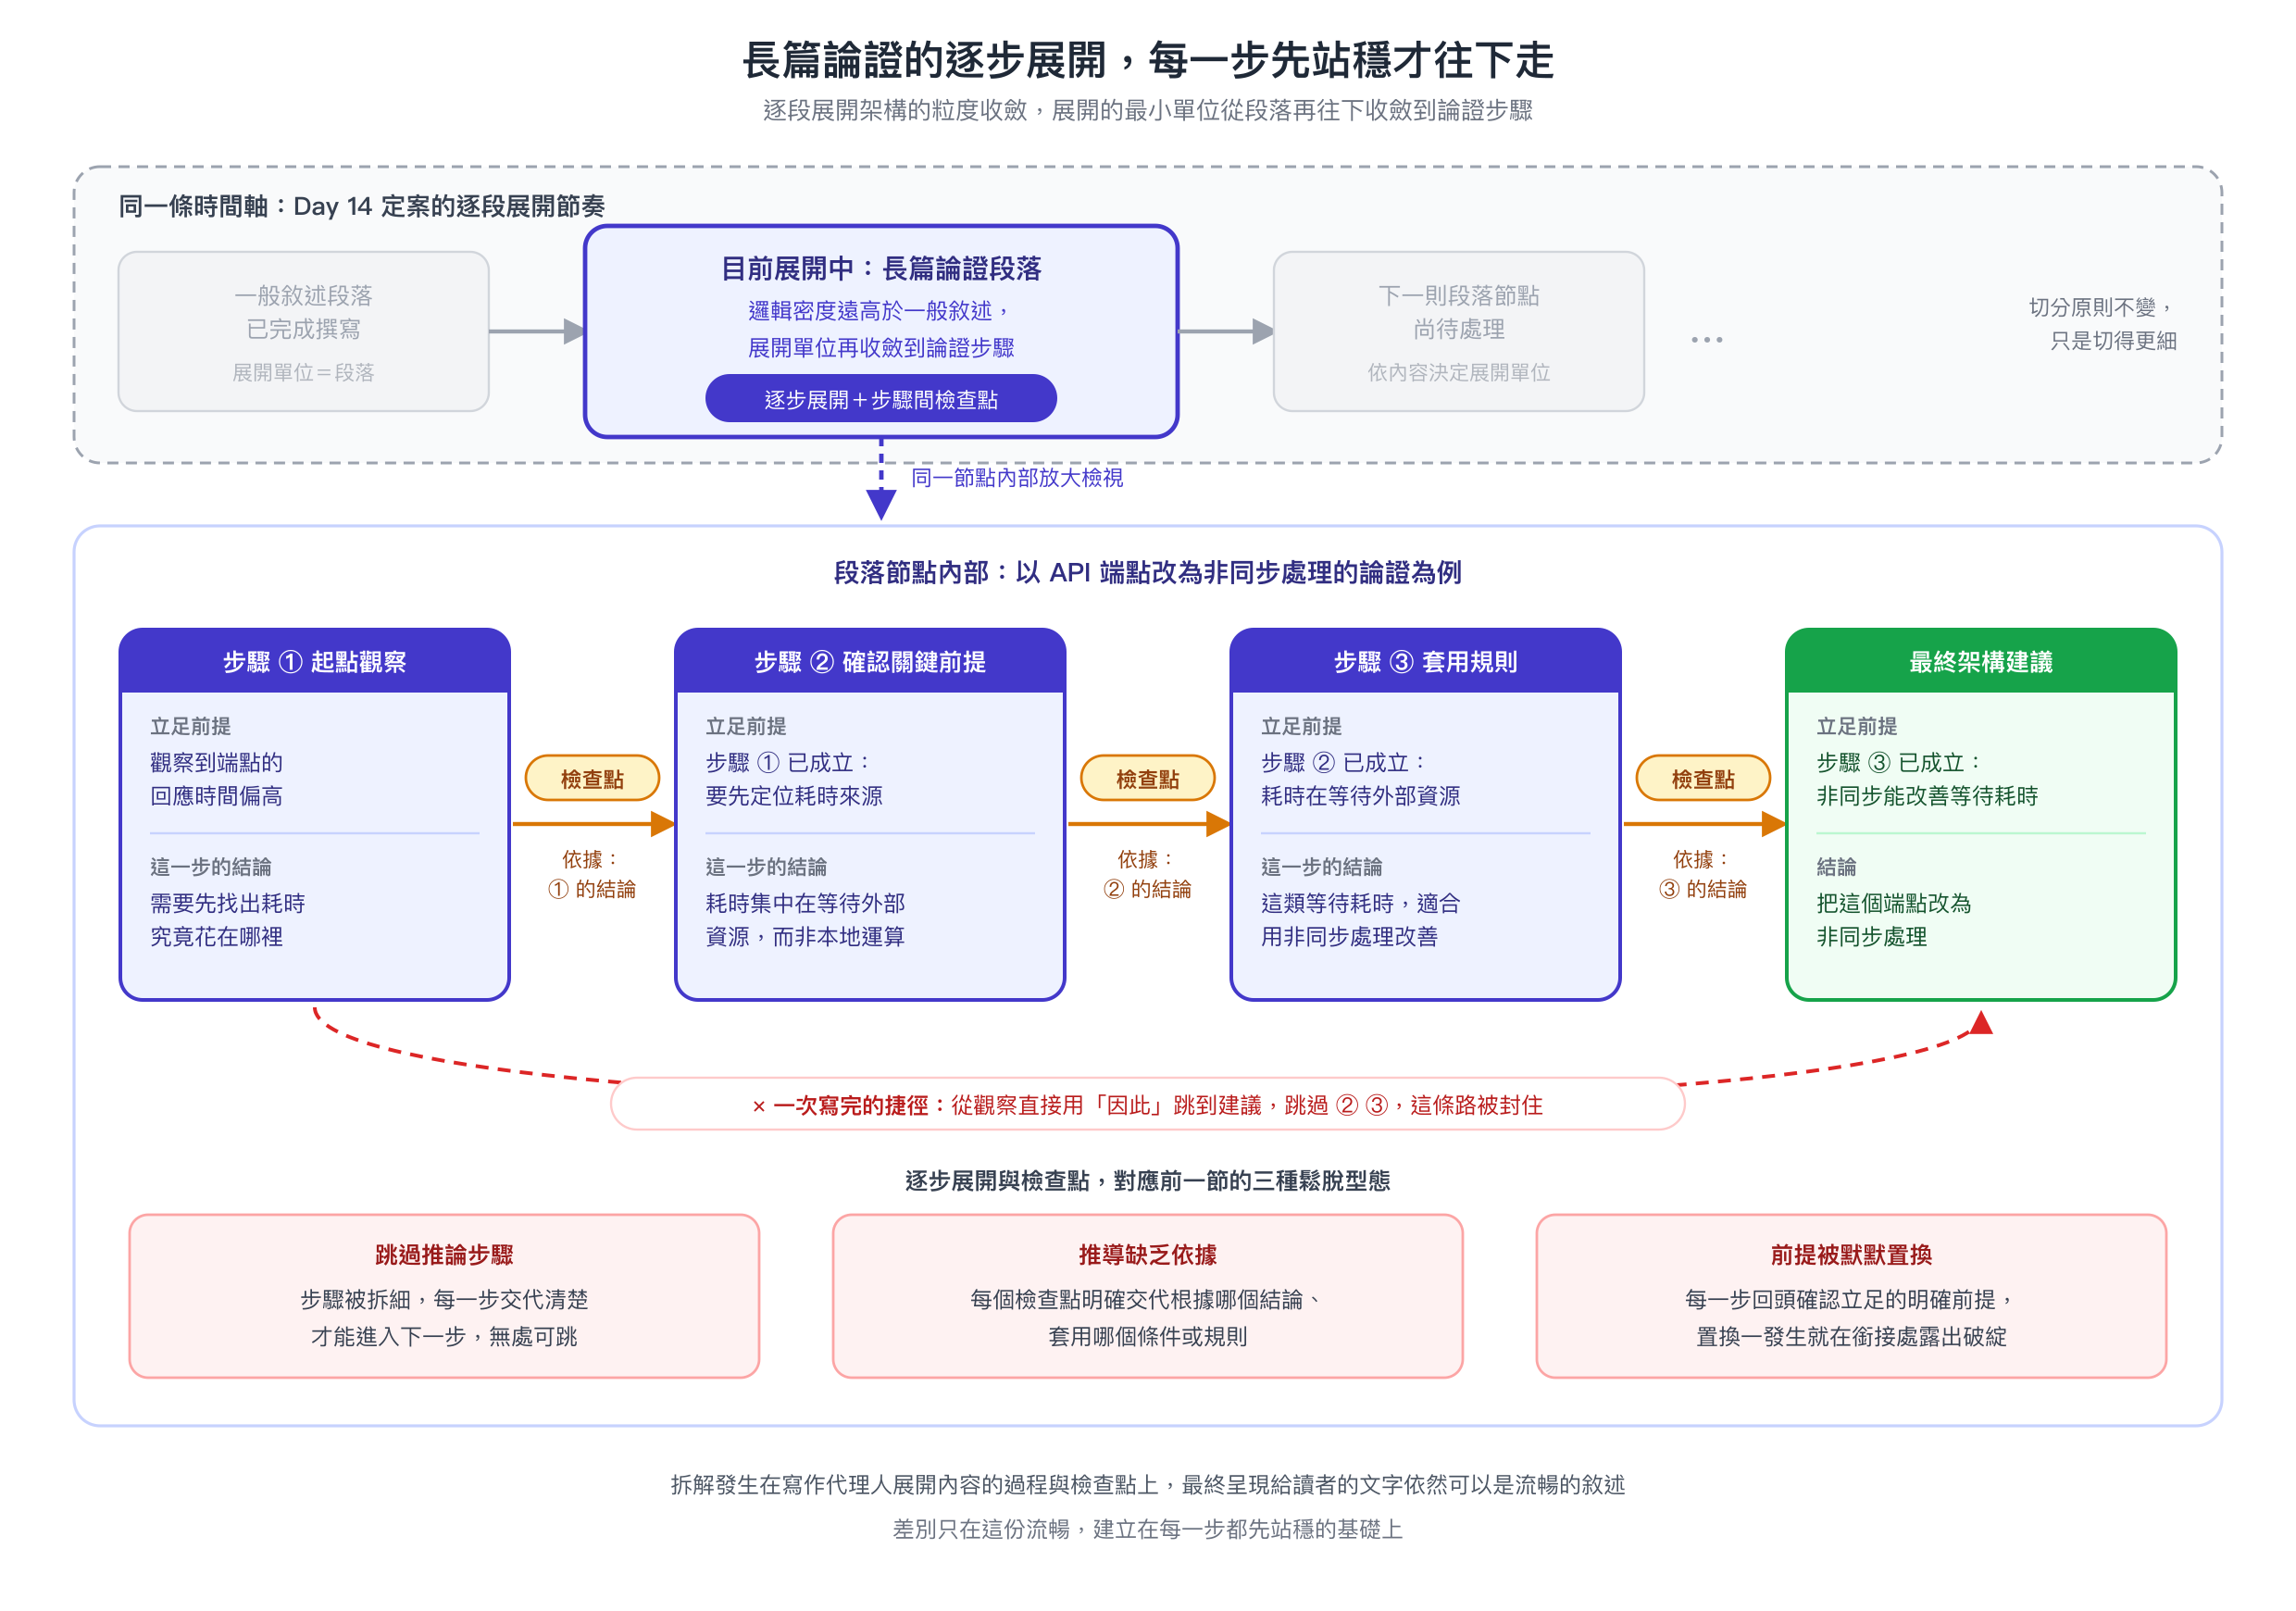
舉一個技術情境。假設一段論證的目標,是從某個 API 端點回應時間偏高的觀察出發,逐步推導到「應該把這個端點改為非同步處理」這個架構建議。這類推導在技術寫作裡很常見,也正是長篇論證緊密度最容易鬆脫的地方。
第一種具體鬆脫型態,論證中段悄悄跳過一個推論步驟。前一句觀察到回應時間偏高,下一句直接跳到「因此應該改為非同步處理」,中間看似有個「因此」銜接,但真正該交代的中間環節,例如先確認耗時是花在等待外部資源、還是花在本地運算,這個決定改為非同步是否真的有效的關鍵前提,卻被跳過了。讀者若不逐步驗證,很容易被文字的順暢感帶過去,直到自己動手實作才發現這個結論其實還缺一個環節。
第二種具體鬆脫型態,公式推導某一行的變化沒有交代依據。假設推導的是某段程式碼的時間複雜度估算,從一個迴圈的執行次數推進到整體複雜度的結論,中間某一行把兩個原本各自獨立的迴圈次數直接相乘,看起來像是合理的化簡,但實際上少了一個關鍵前提,例如這兩個迴圈是否真的是巢狀關係而非各自獨立執行。讀者若不動手驗算,不會發現這一步其實不成立。
第三種具體鬆脫型態,前面立下的前提到後段被默默置換。論證一開始設定的條件,例如「假設這個端點的流量在尖峰時段是平常的十倍」,推進到後段時,用的還是相似的措辭,卻悄悄變成「假設流量穩定成長」這樣一組不同的條件,讀者若沒有回頭比對前提,很難察覺這個置換已經發生。
這三種型態的共同點是,文字表面的通順與邏輯鏈條的緊密,是兩件不同的事。前者是語言模型最擅長的能力,後者才是長篇論證真正的挑戰所在。
今天的解方方向是,長篇論證或公式推導需要先拆解成更細的論證步驟或推導步驟,再逐步展開。
這個拆解的核心原則是,每一個步驟只允許立足在前一個步驟已經成立的結論之上,不允許跳過中間應該存在的推論環節。
步驟與步驟之間的交接方式也需要明確定義。每往下一步,都需要明確交代這一步是根據前一步的哪個結論、套用了哪個條件或規則才得出。回到前面那個非同步處理的案例,展開這段論證時,第一步先確認並寫下「耗時集中在等待外部資源」這個前提是否成立,這一步的結論確立之後,才允許進入第二步,去論證「等待外部資源的耗時適合用非同步處理改善」,第二步必須明確交代它是根據第一步的哪個結論展開的,最終建議要等這兩步都站穩之後才出現。
這個做法直接對應前一節描述的三種鬆脫型態。跳過推論步驟的問題,因為步驟被拆細而無處可跳,每一步都必須先被交代清楚才能進入下一步。推導缺乏依據的問題,因為每一步都要求明確交代依據,公式推導的每一行變化都必須說明是套用了哪個前提或規則。前提被默默置換的問題,因為每一步都要求回頭確認立足的是哪一個明確的前提,置換一旦發生就會在銜接處露出破綻。
需要特別強調的是,最終呈現給讀者的文字,不需要跟著切成生硬的條列步驟。拆解只發生在寫作代理人展開內容的過程與檢查點上,最終文字依然可以是流暢的敘述,只是這份流暢建立在每一步都先站穩的基礎上。
讀到這裡,一個疑惑可能會冒出來,今天要講的論證步驟拆解,聽起來像是要再引入一套全新的機制,是不是又要多學一套東西。答案是否定的。
先回顧 Day 14:寫作代理人的架構設計,從規格到草稿 已定案的逐段展開架構,寫作代理人依序讀取每一則段落規格,只針對這一段要求的重點與前提展開內容,這一段寫完之後才進入下一段。
這個原則本身沒有規定「一段」的粒度必須固定不變。一般敘述性內容裡,一個段落可以是展開的最小單位,寫作代理人只針對這一段要求的重點與前提展開,寫完就進入下一段。但長篇論證或公式推導的邏輯密度遠高於一般敘述,若依然把整段論證當作一個不可再分的展開單位一次寫完,段落內部依然可能重演 Day 01 描述的注意力被迫在宏觀與微觀之間切換的問題,只是這次切換發生在段落內部的每一個推論步驟之間。
今天正式定案的判斷是,論證步驟或推導步驟的拆解,是逐段展開架構套用在長篇論證與公式推導這類內容時,展開的最小單位進一步收斂到步驟層級的具體體現,和逐段展開架構屬於同一套機制。兩者服務的是同一個原則,只針對眼前這個最小單位要求的重點與前提展開內容。差別只在於,一般內容的最小單位是段落,長篇論證與公式推導的最小單位是論證步驟或推導步驟。
可以把逐段展開架構想成依單位切分任務的節奏,一般內容的單位是段落,任務切到這個粒度就足以讓寫作代理人的注意力維持集中。長篇論證與公式推導的邏輯密度太高,同樣的粒度已經不夠用,於是切分的單位再往下收斂一層,切到論證步驟。切分的原則沒有變,變的只是這一次切得更細。
收束今天最重要的這一層定案,若依然把整段論證當作一個不可再分的展開單位一次寫完,段落內部依然可能重演注意力被迫在宏觀與微觀之間切換的問題,只是這次切換發生在無人看管的段落內部。收斂展開單位,就是讓每一個切換點都成為一個明確的檢查點。
今天正式回答了 Day 17 留下的懸念。長篇論證或公式推導緊密度鬆散,是 Day 01 定案的注意力稀釋病灶裡宏觀邏輯推理側的具體型態,Day 16 處理的是微觀細節查證側在程式碼範例上的型態,今天補上的是另一側。
今天最核心的判斷是,模型一次通順地寫完,並不代表論證站得住腳。長篇論證與公式推導的緊密度,來自把檢查點下放到每一個論證步驟或推導步驟,每一步驟只立足在前一步驟已經成立的結論之上,步驟與步驟之間明確交代依據。這個做法是 Day 14 逐段展開架構在論證密度更高內容上的粒度收斂,兩者屬於同一套機制。
架構、查證、程式碼正確性、跨篇狀態記憶、長篇論證的緊密度,這幾件事到今天都已經各自有了具體的機制。但這些機制到目前為止,都是寫作代理人自己一手執行、自己一手把關的。寫作代理人的查證工作,與另一個角色的查核工作之間,邊界究竟畫在哪裡,這個問題今天還沒有答案,將在下一篇正式揭曉。


 iThome鐵人賽
 看影片追技術