
Day22 把資料蒐集回來了,這篇要回答:這份 Food DB 要放在哪裡?最後決定要放在S3。
S3 是什麼
S3 全名是 Simple Storage Service,是 AWS 最早推出的服務之一,正式分類是「物件式儲存空間(Object Storage)」。
它不是資料庫,也不是電腦裡那種有資料夾層層相套的檔案系統,可以想成一個放在雲端、容量幾乎無限的大置物櫃:你丟一個檔案進去,它幫你保管,要用的時候再用名字取回來。
三個核心概念
foods.json 就是一個 Objectfoods.json。看起來像路徑(data/foods.json),但其實只是名字的一部分,S3 內部沒有真正的資料夾它擅長什麼、不擅長什麼
為什麼放前端靜態檔案跟 Food DB 的 JSON 都很放心
因為這兩種東西的共通點是「整份讀、不常改」,剛好落在 S3 最擅長的範圍。這次只用到最基礎的存取(上傳與讀取整個檔案),但它還有幾個資料量變大之後值得考慮的機制:
其實關於儲存資料,有三種常見的存法
| 存法 | 做法 | 適合 | 代價 |
|---|---|---|---|
| 綁進 Lambda 部署包 | JSON 檔跟著程式碼一起打包 | 資料很少、幾乎不會改 | 每次改資料都要重新部署 Lambda |
| S3 存 JSON | 檔案放在 S3,Lambda 執行時去讀 | 資料量中小、只讀不常寫 | 沒有查詢引擎,要整份讀進記憶體 |
| DynamoDB | 用專門的資料庫服務存放 | 資料量大、常寫入、要查詢 | 要多學一套服務與查詢方式 |
到底該怎麼選擇呢 ? 思考點:這份資料會不會變、多常變、變了以後代價是什麼
選型不是選「哪個服務比較潮」,而是回頭問這三個問題。
| 問題 | 綁進 Lambda 部署包 | S3 存 JSON | DynamoDB |
|---|---|---|---|
| 會不會變? | 只適合「不會變」。資料寫死在程式碼旁邊,是程式的一部分 | 可以變。資料是獨立的檔案,跟程式碼分開 | 可以變,而且是設計給會變的資料用的 |
| 多常變? | 幾個月才動一次還能忍受;每週都在加資料就很痛 | 幾天到幾週批次更新一次剛好;每秒都在寫入就不適合 | 隨時都在新增、修改也沒問題,可以只改單一筆 |
| 變了以後代價是什麼? | 最高:改一筆資料就要 sam build && sam deploy 整個重新部署,Lambda 一起被牽動 |
中等:重新上傳一次檔案即可,不碰 Lambda。代價是要整份覆蓋,且程式要自己處理快取 | 最低:單筆寫入、立即生效。代價在別處,要學新服務與查詢方式,資料結構(主鍵設計)也要先想好 |
| 讀取方式 | 隨程式載入,最快,但資料有多大就吃多少部署包空間 | 第一次要去 S3 讀、整份載入記憶體,之後靠暖啟動的快取 | 可以依條件只查需要的幾筆,不用整包載入 |
| 額外學習成本 | 幾乎沒有 | 低,只要會 GetObject 與 PutObject |
高,要懂資料表、主鍵、查詢與計費模式 |
所以為什麼還是選 S3?
逐題對照之後,結論不是「S3 最強」,而是「S3 最貼合這份資料現在的樣子」:
DynamoDB 沒有被否定,只是這份資料還沒大到、也沒頻繁到需要它。當資料量大到不想整包載入記憶體,或是要讓使用者即時寫入時,才是換的時機。
冷啟動與暖啟動
Lambda 沒有請求時不會佔著機器,有請求進來才啟動一個執行環境,這叫冷啟動;之後短時間內的下一個請求,會重複使用同一個環境,叫暖啟動。放在環境裡的變數,暖啟動時還在,這點後面會用到。
S3 存 JSON
這個資料庫會持續增加內容。如果 JSON 綁在部署包裡,每新增一筆食物就要重新 sam build && sam deploy。這個專案後來衝到 1915 筆,過程中反覆擴充了 MOS、Subway、全家三個品牌,每次都重新部署整個 Lambda,負擔會很大。
改成 S3 之後,資料跟程式碼完全分開:新增資料只要重新上傳 S3 的檔案,完全不用碰 Lambda 部署。後來全家一次擴充 1750 筆,就證明這個決定是對的。
實際的讀取程式
專案裡讀取的程式在 backend/hello-world/foodSearch.ts,重點只有幾行:
let cachedFoodItems: FoodItem[] | null = null;

async function loadFoodItems(): Promise<FoodItem[]> {
  if (cachedFoodItems) return cachedFoodItems;

  const response = await s3Client.send(new GetObjectCommand({ Bucket: FOOD_DATA_BUCKET, Key: FOOD_DATA_KEY }));
  const body = await response.Body?.transformToString();
  cachedFoodItems = JSON.parse(body ?? '[]') as FoodItem[];
  return cachedFoodItems;
}
意思是:第一次(冷啟動)去 S3 讀一次 foods.json,存進模組層級的變數 cachedFoodItems;之後暖啟動時變數還在,就直接用,不用每次請求都再打一次 S3。
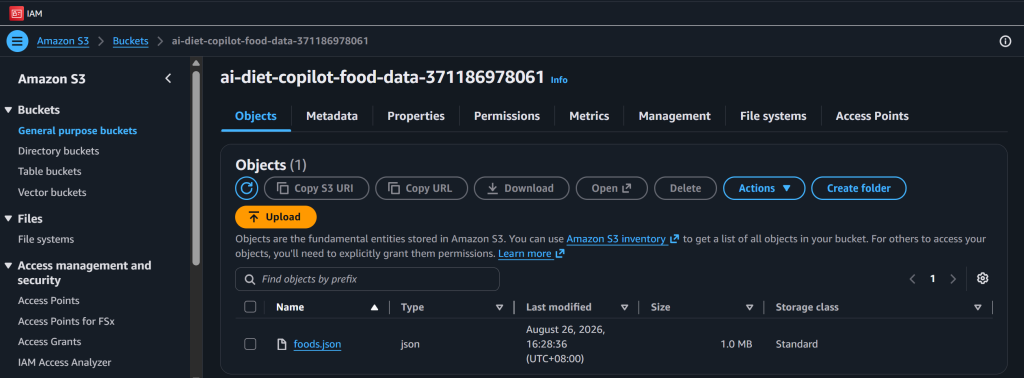
另一頭:資料是怎麼「放進」 S3 的?
上面是讀的那一頭,寫入的那一頭也要講清楚,不然容易誤解成「把某個 JSON 檔手動丟上去」。實際上沒有任何「打包」的動作,是用「匯入腳本」自動上傳的(位於 backend/scripts/,手動執行,不是 Lambda 的一部分):
FoodItem 格式並做合理性驗證。foods-checkpoint.json、familymart-checkpoint.json)。這只是抓取過程中的中途存檔,避免跑到一半中斷、整批白抓,不是正式資料。PutObject 把整批資料上傳到 S3 的 foods.json。那多個品牌怎麼辨?以全家的腳本為例,它上傳前會先把 S3 上現有的資料讀回來,澾掉舊的全家資料、再和新抓的合併:
const existing = await fetchExistingFoods();
const merged = [...existing.filter((item) => item.brand !== '全家'), ...items];
// 再用 PutObject 把 merged 整個寫回 s3 的 foods.json
這樣做有兩個好處:不會把 MOS、Subway 的資料蓋掉;重跑腳本時也不會把全家的資料重複疊加。
所以 S3 上的 foods.json 是多個腳本合併的結果,不是任何一個檢查點檔的複製。可以想成:檢查點是「抄寫過程中的草稿」,S3 的 foods.json 是「整理好的正式版」,Lambda 需要時才去 S3 借來看。
這篇最大的心得: 「用 DynamoDB 才夠 Serverless」是那時候的第一直覺,但回頭問「這份資料會不會變、多常變」之後,答案變成了 S3。DynamoDB 不是被否定,是被留在「資料量大到不想整包載入記憶體」的下一步。不過,把資料庫放在 S3 到底算不算合理?下一篇 Day24 要談這個決定的代價。


 iThome鐵人賽
 看影片追技術