
上一篇完成了資料庫版的 CRUD,API 已經可以正常新增、查詢、修改、刪除了。
今天要處理一個實際開發一定會遇到的問題:
寫到一半,發現資料表少了一個欄位,怎麼辦?
假設我們現在想幫作業加上「截止日期」。
在 Model 裡多加一個欄位:
class Task(db.Model):
    id = db.Column(db.Integer, primary_key=True)
    name = db.Column(db.String(100), nullable=False)
    completed = db.Column(db.Boolean, nullable=False, default=False)
    due_date = db.Column(db.String(20))   # 新增這一行
存檔後重新啟動:
python app.py
然後打開 GET /tasks,Execute。
畫面上不會是資料,而是錯誤。
終端機也會看到類似這樣的訊息:
sqlalchemy.exc.OperationalError: (sqlite3.OperationalError) no such column: task.due_date
加了欄位之後,GET /tasks 出現 500,終端機顯示 no such column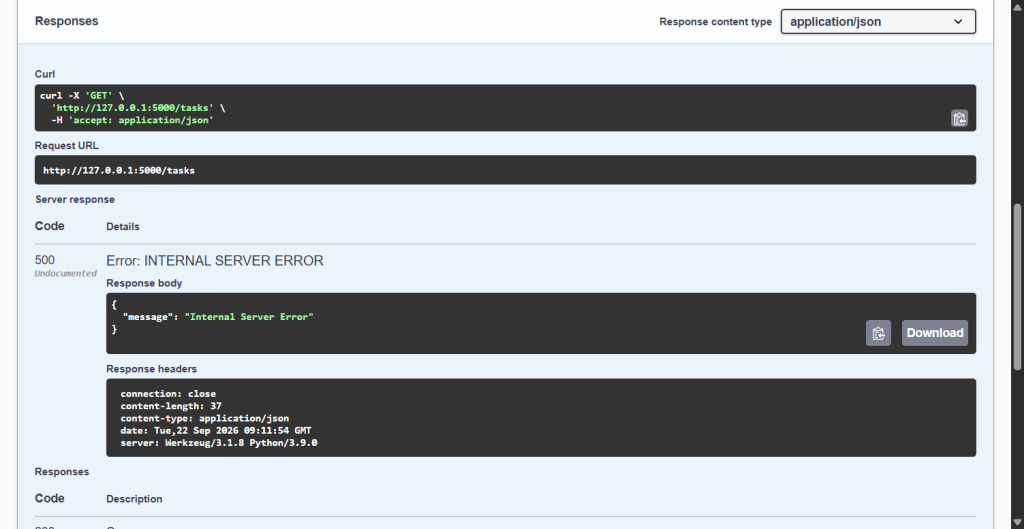
意思是:
程式裡的 Task 已經有 due_date 了,但資料庫裡的 task 表沒有這個欄位。
兩邊對不起來。
Day 20 有提過:
db.create_all() 只會建立「還不存在」的資料表。
因為 task 這張表已經存在了,所以它就直接跳過,不會去檢查我們是不是多加了欄位。
它不是壞掉,是它本來就只負責「建立」,不負責「修改」。
在現在這種練習階段,確實可以:
把 instance/tasks.db 刪掉
重新執行程式,create_all() 會依照新的 Model 建一張新的表
但這個做法有一個很大的問題:
資料全部都會不見。
如果是已經上線的服務,裡面有使用者真實的資料,當然不可能「加個欄位就把資料庫砍掉重建」。
所以我們需要另一種方式:
在不刪資料的情況下,修改資料表的結構。
這就是 Migration。
Migration(資料庫遷移)可以理解成:
把資料庫結構的每一次改變,記錄成一份一份可以執行的檔案。
有點像資料庫的版本控制。
例如:
第 1 版:建立 task 表(id、name、completed)
第 2 版:task 表新增 due_date 欄位
每一版都是一個檔案,裡面會寫兩件事:
upgrade():要怎麼從上一版變成這一版
downgrade():如果要退回上一版,要怎麼做
這樣做的好處是:
資料不會不見,只是改結構
每一次改了什麼都有紀錄,可以往前也可以往回
團隊其他人或正式環境,只要執行同一份 migration,資料庫結構就會一致
(不然就會變成「我電腦上可以跑,你那邊說找不到欄位」。)
一樣先分清楚名字:
Alembic
SQLAlchemy 官方的資料庫 migration 工具,真正在做事的是它。
Flask-Migrate
把 Alembic 包進 Flask,讓我們可以用 flask db … 這種指令操作。
跟前面的 Flask-SQLAlchemy 一樣,是「讓它在 Flask 裡好用」的角色。
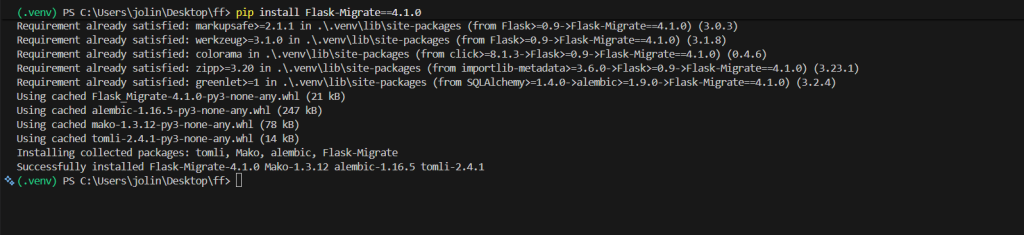
pip install Flask-Migrate==4.1.0
在 app.py 加入 Flask-Migrate:
from flask_migrate import Migrate

app = Flask(__name__)
app.config['SQLALCHEMY_DATABASE_URI'] = 'sqlite:///tasks.db'

db = SQLAlchemy(app)
migrate = Migrate(app, db, render_as_batch=True)
Migrate(app, db) 就是把 Flask app 和 db 交給 Flask-Migrate。
那個 render_as_batch=True 要特別說一下。
SQLite 的 ALTER TABLE 功能比較陽春,像是「修改欄位型別」、「刪除欄位」這些操作,它本來是做不到的。
加上 render_as_batch=True 之後,Alembic 會改用「建一張新表 → 把資料搬過去 → 換掉舊表」的方式來完成,這樣在 SQLite 上也能正常修改。
用 SQLite 的話建議一開始就加上去,不然之後改欄位的時候會卡住。
另外,既然要交給 Migration 管理了,就可以把這兩行拿掉:
with app.app_context():
    db.create_all()
因為之後資料表的建立和修改,都會由 migration 負責。
兩邊同時管理反而會亂掉。
因為我們前面是用 create_all() 建表的,資料庫裡已經有一張 task 表,
但 migration 這邊完全不知道這件事,直接執行會撞在一起。
練習階段最單純的做法,就是重新開始:
先把 instance/tasks.db 刪掉(裡面只是測試資料)
然後在終端機依序執行:
步驟 1:建立 migration 環境
flask db init
執行完之後,專案裡會多出一個 migrations 資料夾。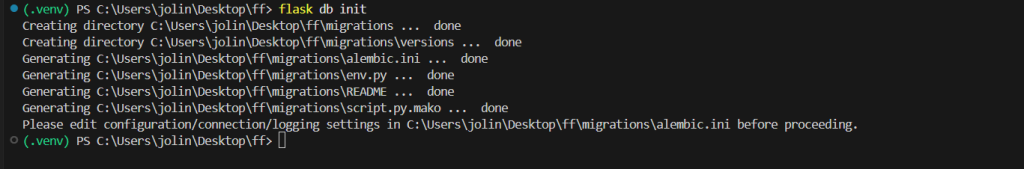
專案裡多出 migrations 資料夾
步驟 2:產生 migration 檔
flask db migrate -m "create task table"
它會去比對「Model 的樣子」和「資料庫目前的樣子」,然後產生一份 migration 檔,放在:
migrations/versions/xxxxxxxx_create_task_table.py
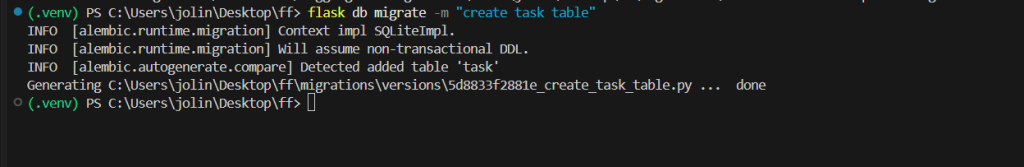
終端機顯示偵測到 task 表,並產生 migration 檔
打開那個檔案,會看到類似:
def upgrade():
    op.create_table(
        'task',
        sa.Column('id', sa.Integer(), nullable=False),
        sa.Column('name', sa.String(length=100), nullable=False),
        sa.Column('completed', sa.Boolean(), nullable=False),
        sa.Column('due_date', sa.String(length=20), nullable=True),
        sa.PrimaryKeyConstraint('id')
    )

def downgrade():
    op.drop_table('task')
這就是「這一版要做什麼」和「要退回去的話怎麼做」。
步驟 3:真的執行
flask db migrate 只是產生檔案,資料庫其實還沒有變。
要執行這一版:
flask db upgrade
執行 flask db upgrade 的結果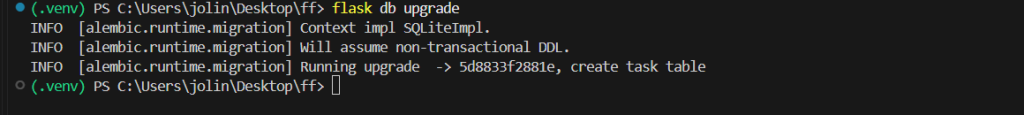
這時候 task 表才真的被建立出來。
(instance/tasks.db 這個檔案在上一步 flask db migrate 的時候就已經產生了,Alembic 要連資料庫做比對,所以會先把檔案建出來—— 只是裡面是空的,還沒有 task 表。)
可以用 check_db.py 確認:
python check_db.py
會看到 task 表,而且欄位多了 due_date。
另外還會看到一張沒印象的表:
alembic_version
那是 Alembic 用來記錄「目前資料庫在第幾版」的表,不用去動它。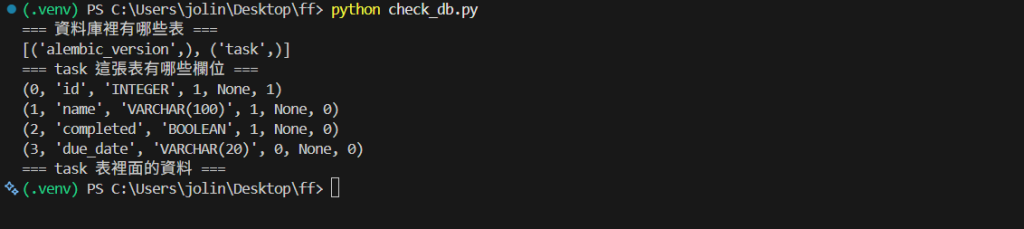
check_db.py 顯示 task 表有 due_date,以及多了 alembic_version 表
剛剛是第一次建立,比較看不出 migration 的好處。
現在我們模擬「已經有資料之後才要改結構」。
先用 API 新增幾筆資料: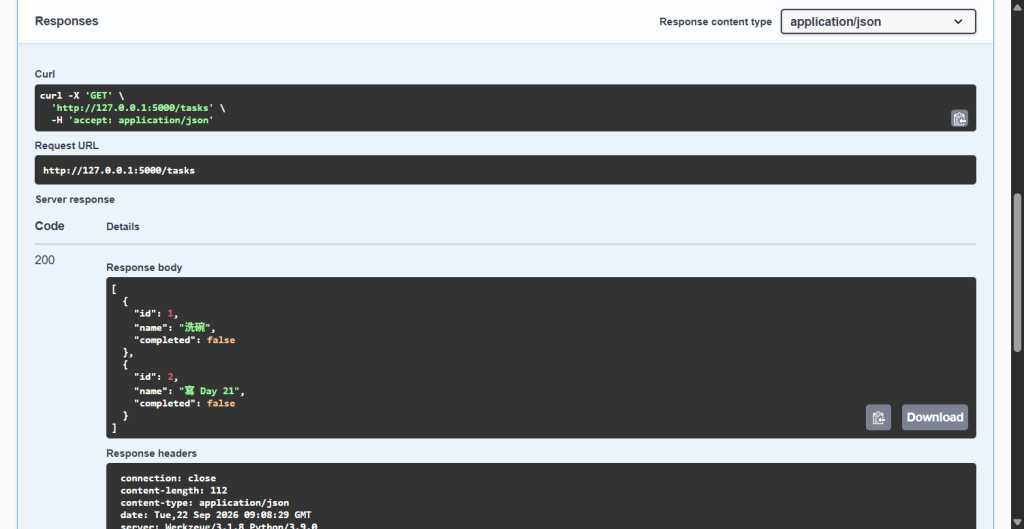
新增兩筆資料
接著在 Model 再加一個欄位,例如優先度:
class Task(db.Model):
    id = db.Column(db.Integer, primary_key=True)
    name = db.Column(db.String(100), nullable=False)
    completed = db.Column(db.Boolean, nullable=False, default=False)
    due_date = db.Column(db.String(20))
    priority = db.Column(db.Integer, nullable=False, default=0)   # 新增
然後先產生 migration:
flask db migrate -m "add priority to task"
終端機會顯示:
INFO [alembic.autogenerate.compare] Detected added column 'task.priority'
這次產生的 migration 檔跟第一次不一樣:
def upgrade():
    with op.batch_alter_table('task', schema=None) as batch_op:
        batch_op.add_column(sa.Column('priority', sa.Integer(), nullable=False))
可以看到它是 add_column(新增欄位),而不是 create_table。
而且因為我們有設定 render_as_batch=True,所以是用 batch_alter_table 的方式做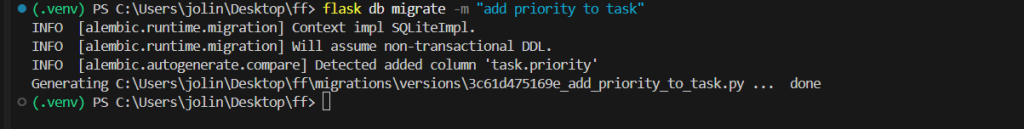
接著執行:
flask db upgrade
結果沒有成功,而是跳出一整串錯誤,最後一行是:
sqlite3.OperationalError: Cannot add a NOT NULL column with default value NULL

[SQL: ALTER TABLE task ADD COLUMN priority INTEGER NOT NULL]
flask db upgrade 失敗,顯示 Cannot add a NOT NULL column
為什麼會這樣?
因為 task 表裡面已經有兩筆資料了。
現在要加一個「不可以是空的」欄位,資料庫就會問:那舊的那兩筆資料,priority 要填什麼?
我們在 Model 裡寫的 default=0 幫不上忙,因為那是「SQLAlchemy 在新增資料時」才會用的預設值,
它是程式這一層的東西,資料庫本身並不知道。
資料庫要的是 server_default,也就是「寫在資料表定義裡」的預設值。
而 Alembic 自動產生的時候,並不會幫我們補這一段。
解法:自己打開 migration 檔改一行
把剛剛產生的那個檔案打開,在 add_column 裡加上 server_default:
def upgrade():
    with op.batch_alter_table('task', schema=None) as batch_op:
        batch_op.add_column(sa.Column('priority', sa.Integer(), nullable=False, server_default='0'))
意思是:舊資料的 priority 就先當作 0。
改完之後再執行一次:
flask db upgrade
這次就成功了:
INFO [alembic.runtime.migration] Running upgrade 61bfc09212dd -> 2cc6f7318be2, add priority to task
這也剛好印證了下面「產生的 migration 要自己看一下」那一點。
flask db migrate 是自動偵測,它知道「多了一個欄位」,但它不知道「舊資料該填什麼」,那是我們要自己決定的。
資料表已經有 due_date 和 priority 了,但如果現在打開 GET /tasks,會發現回傳的還是只有 id、name、completed。
因為 Day 16 加的 @api.marshal_with(task_response) 會照著 task_response 把回傳的資料過濾一次,沒有寫在裡面的欄位就不會被傳出去。
所以 api.model 也要跟著補上:
task_response = api.model('TaskResponse', {
    'id': fields.Integer(readonly=True, description='作業編號'),
    'name': fields.String(description='作業名稱'),
    'completed': fields.Boolean(description='是否完成'),
    'due_date': fields.String(description='截止日期'),
    'priority': fields.Integer(description='優先度'),
})
這也呼應 Day 20 說的:資料表的 Model 和 API 的 model 是兩件不同的東西,改了資料庫不代表 API 的輸出就會跟著變。
執行成功之後,再打開 GET /tasks:
資料還在,而且每一筆都多了 due_date 和 priority 欄位。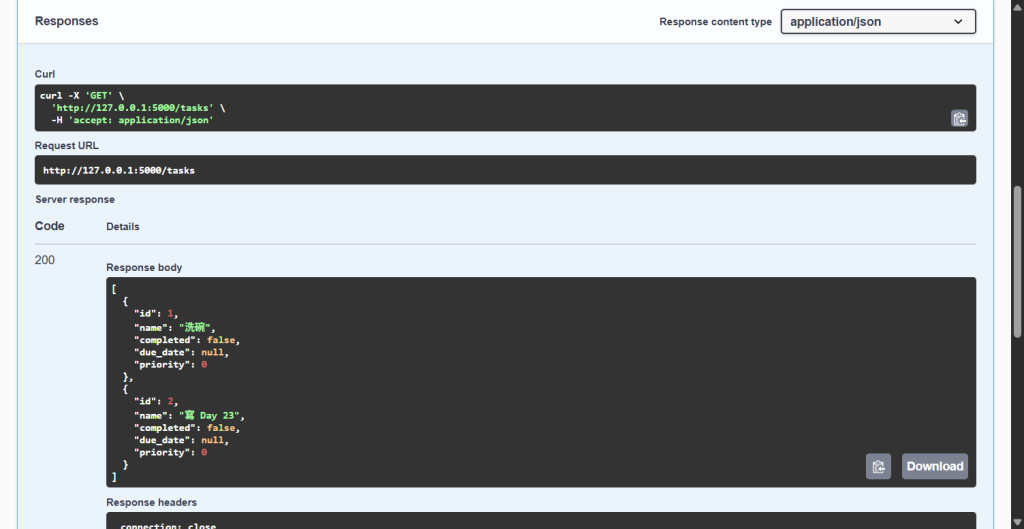
加完欄位後,原本的資料還在,也多了新欄位
這就是 migration 和「砍掉重建」最大的差別。
flask db init → 建立 migrations 資料夾(只要做一次)
flask db migrate → 比對 Model 和資料庫,產生 migration 檔
flask db upgrade → 執行 migration,真的去改資料庫
flask db downgrade → 退回上一版
flask db current → 看目前在第幾版
flask db history → 看所有版本紀錄
容易搞混的是 migrate 和 upgrade:
migrate 是「寫好要做什麼」
upgrade 才是「真的去做」
flask db migrate 是「自動偵測」,不是每次都 100% 正確。
例如改欄位名稱,它常常會判斷成「刪掉舊的、新增一個新的」,這樣資料就會不見。
所以產生之後養成打開來看一眼的習慣,這也是為什麼 migration 檔要進版控。
就是今天踩到的那個。
如果表裡面已經有資料,卻新增一個 nullable=False 的欄位,
資料庫會不知道舊資料這個欄位要填什麼,upgrade 就會失敗。
解法有兩個:
在 migration 檔裡補上 server_default(今天用的方法)
或是讓這個欄位可以是空的(不要寫 nullable=False)
要特別注意 Model 裡的 default=0 不等於 server_default。
default 是 SQLAlchemy 新增資料時用的,資料庫本身不知道有這回事。
只跑 migrate 就以為改好了,是很常見的狀況。
如果執行 flask db 指令出現找不到 app,可以先指定:
PowerShell:
$env:FLASK_APP = "app.py"
db.create_all() 不會修改既有的資料表
Migration 是把資料庫結構的改變記錄成一份一份的檔案
Flask-Migrate 讓我們用 flask db 指令操作
init / migrate / upgrade 的差別
SQLite 記得加 render_as_batch=True
到這裡,Flask + Flask-RESTX + Flask-SQLAlchemy + Flask-Migrate 都湊齊了,
這次 30 天要學的四個主要套件也都用過一輪了。
功能是做完了,但現在的 API 其實還很脆弱:
使用者亂傳資料會怎麼樣?查不到資料的時候回什麼?程式出錯的時候會不會把錯誤訊息整包丟給使用者?
接下來幾天就來處理這些事情,下一篇先從錯誤處理開始。


 iThome鐵人賽
 看影片追技術