
上一篇我們建立了 Task 這個 Model,也讓 Flask-SQLAlchemy 幫我們把資料表建出來了:
class Task(db.Model):
    id = db.Column(db.Integer, primary_key=True)
    name = db.Column(db.String(100), nullable=False)
    completed = db.Column(db.Boolean, nullable=False, default=False)
不過資料表雖然有了,API 還是跟它沒有關係。
今天要做的事情很明確:
讓 POST /tasks 真的把資料寫進資料庫
讓 GET /tasks 真的從資料庫把資料查出來
最後驗證一件事:重新啟動 Server 之後,資料還在不在。
db.session 是什麼?
要操作資料庫之前,先認識一個一直會看到的東西:
db.session
session 可以先理解成:
一個暫時的工作區,我們先把要做的事情放進去,最後再一次送進資料庫。
常用的有三個:
db.session.add(task)
把「要新增這筆資料」這件事放進工作區(還沒真的寫進資料庫)
db.session.commit()
把工作區裡的事情真的送進資料庫
db.session.rollback()
取消工作區裡還沒送出的事情
這裡的 commit 跟 Day 18 用 sqlite3 時寫的 conn.commit() 是同一個概念。
最常見的錯誤就是:add 了但忘記 commit,結果重開之後發現資料根本沒存進去。
Day 16 的 post() 是這樣:
data = api.payload
task = {
    "id": next_id,
    "name": data.get("name"),
    "completed": data.get("completed", False),
}
tasks.append(task)
next_id += 1
改成資料庫版本:
data = api.payload
task = Task(
    name=data.get("name"),
    completed=data.get("completed", False),
)

db.session.add(task)
db.session.commit()

return task, 201
差別在哪裡?
原本是「建立一個字典,append 進 List」
現在是「建立一個 Task 物件,add 進 session 再 commit」
另外 id 也不用自己算了。
因為 id 是資料庫的主鍵,commit 之後資料庫會自動給編號,SQLAlchemy 也會把這個 id 填回我們的 task 物件裡。
所以 commit 之後就可以直接拿到 task.id。
global next_id 這一行也可以刪掉了。
原本是:
return tasks
現在改成:
return db.session.scalars(db.select(Task)).all()
這一串拆開來看:
db.select(Task) → 我要查 Task 這張表(相當於 SELECT * FROM task)
db.session.scalars(…) → 執行查詢,並取出一個一個的 Task 物件
.all() → 全部拿出來變成 List
查出來的會是一個 List,裡面每個元素都是 Task 物件。
(如果有看別的教學,可能會看到 Task.query.all() 這種寫法。
那是 SQLAlchemy 比較舊的風格,現在還可以用,但官方建議改用 db.select 這種新寫法,所以我們就直接用新的。)
這裡有一個我原本很擔心的地方。
Day 16 我們加了:
@api.marshal_list_with(task_response)
那時候回傳的是「字典」:
{"id": 1, "name": "洗碗", "completed": False}
但現在回傳的是「Task 物件」。
結果實際跑起來是可以的。
因為 Flask-RESTX 的 fields 在取值的時候,字典和物件都支援:
是字典就取 key,是物件就取屬性(task.name)。
所以 Model 的欄位名稱(name、completed)剛好跟 task_response 的欄位名稱一樣,就可以直接用。
這也是為什麼前面要先把 task_response 寫出來,換成資料庫之後回傳的部分幾乎不用改。
app.py
from flask import Flask
from flask_restx import Api, Resource, fields
from flask_sqlalchemy import SQLAlchemy

app = Flask(__name__)
app.config['SQLALCHEMY_DATABASE_URI'] = 'sqlite:///tasks.db'

db = SQLAlchemy(app)
api = Api(app, title='Task API', version='1.0', description='30 天鐵人賽練習用的作業管理 API')

class Task(db.Model):
    id = db.Column(db.Integer, primary_key=True)
    name = db.Column(db.String(100), nullable=False)
    completed = db.Column(db.Boolean, nullable=False, default=False)

task_input = api.model('TaskInput', {
    'name': fields.String(required=True, description='作業名稱', example='洗碗'),
    'completed': fields.Boolean(required=True, description='是否完成', example=False),
})

task_response = api.model('TaskResponse', {
    'id': fields.Integer(readonly=True, description='作業編號'),
    'name': fields.String(description='作業名稱'),
    'completed': fields.Boolean(description='是否完成'),
})

@api.route('/tasks')
class TaskList(Resource):
    @api.marshal_list_with(task_response)
    def get(self):
        """取得所有作業"""
        return db.session.scalars(db.select(Task)).all()

    @api.expect(task_input)
    @api.marshal_with(task_response, code=201)
    def post(self):
        """新增一筆作業"""
        data = api.payload

        task = Task(
            name=data.get("name"),
            completed=data.get("completed", False),
        )

        db.session.add(task)
        db.session.commit()

        return task, 201

with app.app_context():
    db.create_all()

if __name__ == '__main__':
    app.run(debug=True)
跟 Day 16 比起來,API 的結構其實沒變,變的只有「資料放在哪裡」。
啟動:
python app.py
步驟 1:先用 GET /tasks 看看
應該會是空的:
[]
一開始 GET /tasks 回傳空陣列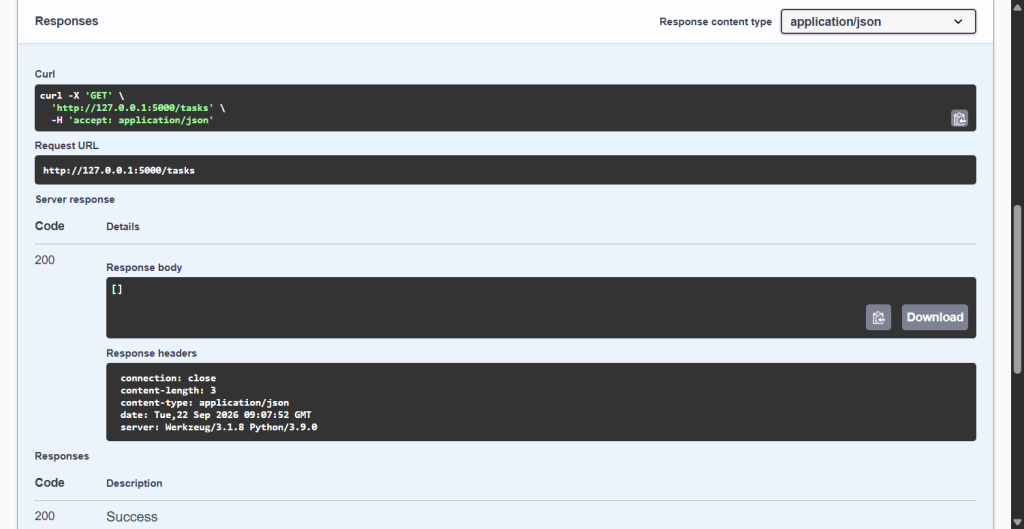
步驟 2:用 POST /tasks 新增
{
  "name": "洗碗",
  "completed": false
}
Execute 之後會回傳:
{
  "id": 1,
  "name": "洗碗",
  "completed": false
}
這個 id 是資料庫給的,不是我們自己算的。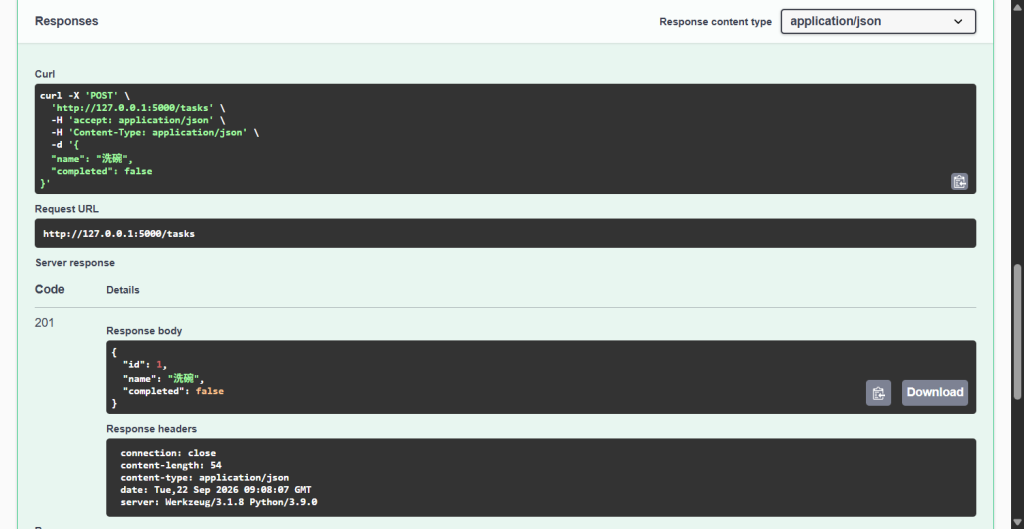
POST /tasks 新增成功,回傳 201 和資料庫給的 id
再新增一筆「寫 Day 21」。
步驟 3:GET /tasks 確認
[
  {"id": 1, "name": "洗碗", "completed": false},
  {"id": 2, "name": "寫 Day 21", "completed": false}
]
GET /tasks 查到兩筆資料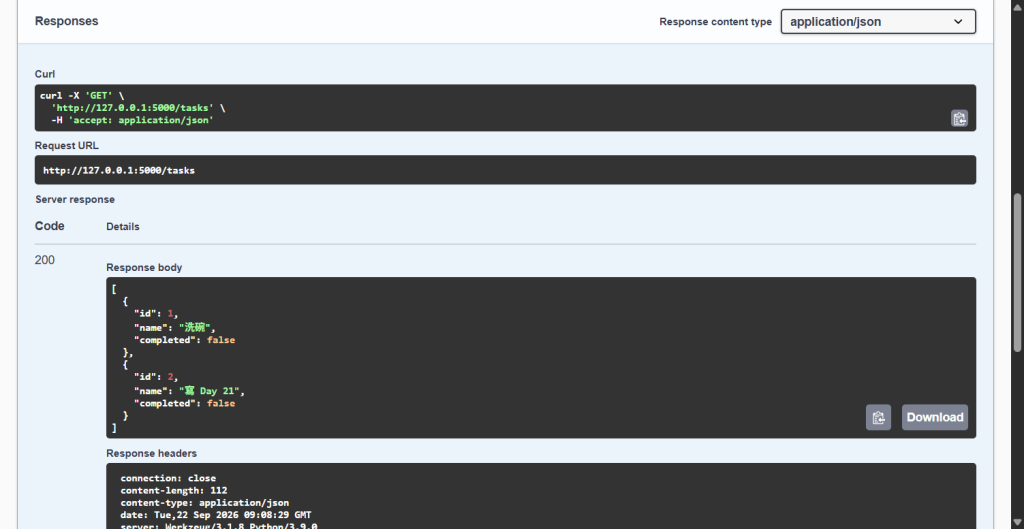
光看 API 的回應,其實看不出來資料是存在記憶體還是資料庫。
所以在 Day 20 寫的 check_db.py 最後面「再加一段」,直接去資料庫裡面看。
注意是「加上去」,不要把原本的蓋掉,後面幾天都還會用到前面那兩段:
print("=== task 表裡面的資料 ===")
rows = conn.execute("SELECT id, name, completed FROM task").fetchall()
for row in rows:
    print(row)
加完之後完整的 check_db.py 會長這樣:
import sqlite3

conn = sqlite3.connect('instance/tasks.db')

print("=== 資料庫裡有哪些表 ===")
tables = conn.execute("SELECT name FROM sqlite_master WHERE type='table'").fetchall()
print(tables)

print("=== task 這張表有哪些欄位 ===")
columns = conn.execute("PRAGMA table_info(task)").fetchall()
for column in columns:
    print(column)

print("=== task 表裡面的資料 ===")
rows = conn.execute("SELECT id, name, completed FROM task").fetchall()
for row in rows:
    print(row)

conn.close()
執行:
python check_db.py
會看到:
=== 資料庫裡有哪些表 ===
[('task',)]
=== task 這張表有哪些欄位 ===
(0, 'id', 'INTEGER', 1, None, 1)
(1, 'name', 'VARCHAR(100)', 1, None, 0)
(2, 'completed', 'BOOLEAN', 1, None, 0)
=== task 表裡面的資料 ===
(1, '洗碗', 0)
(2, '寫 Day 21', 0)
重點是最後那兩行,API 新增的資料真的在資料庫裡面。
這裡也可以順便看到 Day 18 講的:
API 傳的是 false,存到 SQLite 裡面是 0。
回到終端機按 Ctrl + C 把 Server 關掉,再執行:
python app.py
然後打開 GET /tasks。
這次會看到:
[
  {"id": 1, "name": "洗碗", "completed": false},
  {"id": 2, "name": "寫 Day 21", "completed": false}
]
重新啟動 Server 之後,GET /tasks 的資料還在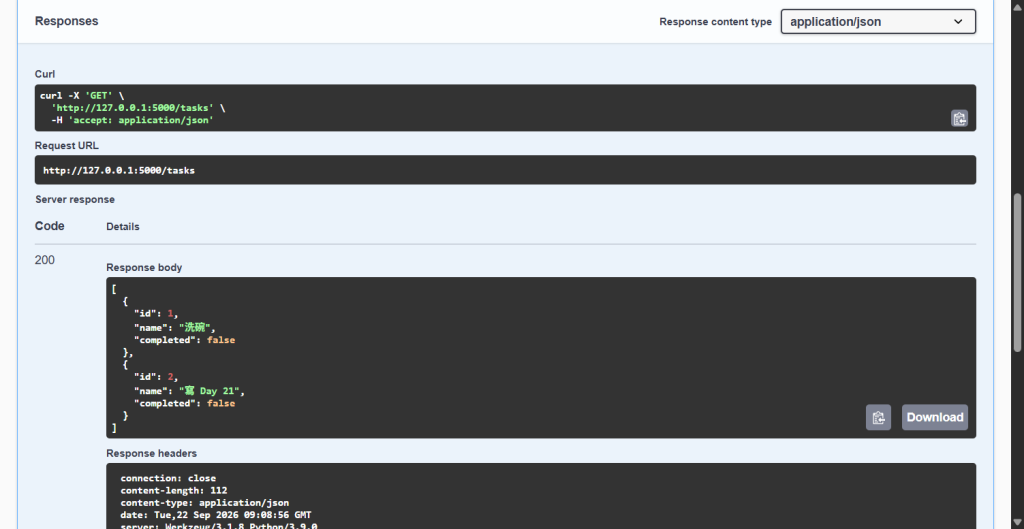
資料留下來了。
這就是 Day 17 說的問題被解決了:
資料不再是存在程式的記憶體裡,而是存在硬碟上的資料庫檔案。
現在的 commit 是直接寫的:
db.session.add(task)
db.session.commit()
但如果 commit 失敗(例如違反了 NOT NULL 這類規則),session 會停在一個不乾淨的狀態,後面的請求可能會跟著出問題。
比較完整的寫法會像這樣:
try:
    db.session.add(task)
    db.session.commit()
except Exception:
    db.session.rollback()
    raise
現在先知道有 rollback 這件事就好,Day 24 講錯誤處理的時候會再把它補上。
認識 db.session 的 add / commit
POST /tasks 真的把資料寫進資料庫
GET /tasks 用 db.select 從資料庫查資料
id 交給資料庫自動產生
最後驗證重開 Server 資料還在
不過現在只有 POST 和 GET 接上資料庫,PUT 和 DELETE 還沒改。
下一篇就把剩下的 CRUD 也都接到資料庫上,完成完整的資料庫版 API。


 iThome鐵人賽
 看影片追技術