
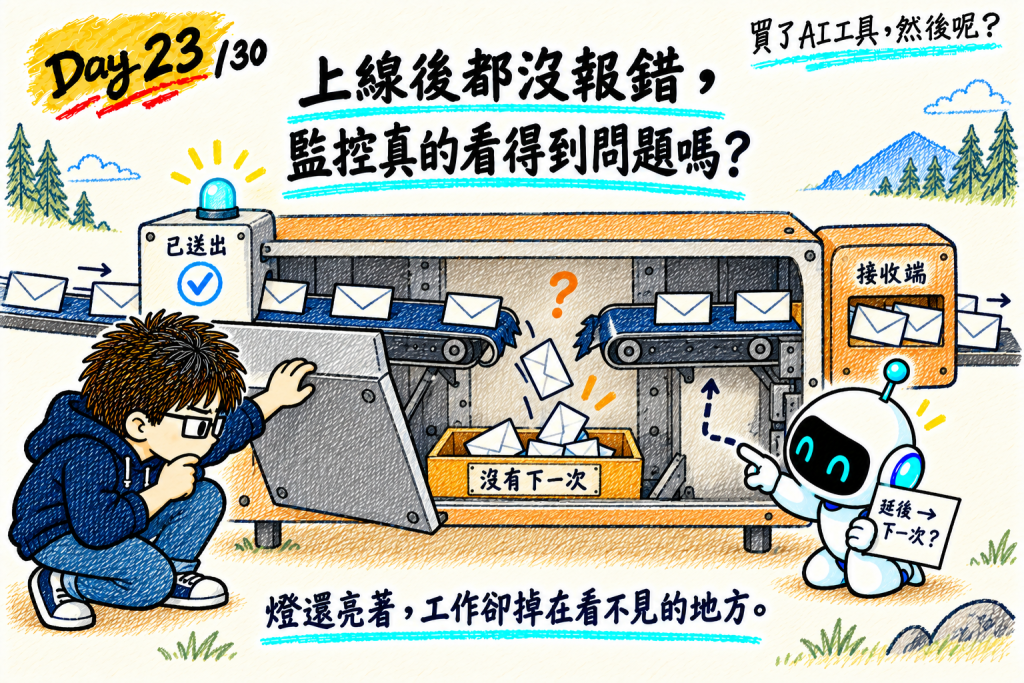
前面把功能做完、測試跑過、交付流程也接起來了。到了上線後,我會想看:服務還活著嗎?有沒有錯誤?背景工作有沒有塞住?
但這幾個問題都有答案,就表示使用者要的事有完成嗎?
Google 的 SRE 書提醒,即使 HTTP 回傳 200,內容錯了,仍然是失敗。這讓我想多問一句:我們現在看的成功,到底是程式執行成功,還是使用者要的事情真的完成?官方說明
昨天 Day 22 整理的是「查完之後,誰接下一步」。第四幕(Day 23~28)談服務上線之後怎麼維運,先往前追一件事:監控沒有把問題照出來,團隊連要接什麼都不知道。
今天沿用訂單取消,用本機 .NET 觀測演練來看這個盲點。故障是刻意注入的,不是公司線上事故。要追的問題很具體:服務說通知送出了,接收端卻沒收到。Claude Code 能否幫忙對照紀錄與程式,查清楚:我們的監控看見了工作完成,還是只看見程式跑過?
取消訂單之後,API 先改狀態,再把通知放進佇列,交給背景工作者送出。這是有後續工作的功能:使用者拿到成功回應時,通知不一定已經完成。
這輪有九筆訂單真正變成已取消。依照範例的通知約定,每筆都應該送出一則通知,所以等背景工作處理完,預期會有九筆對應的接收紀錄。
先看發送端。演練結束時,服務留下的數字是:
| 服務記錄的事 | 結果 |
|---|---|
| 訂單真正從未取消變成已取消 | 9 |
| 放進通知佇列 | 9 |
| 記為已送出 | 9 |
| 佇列裡還剩多少工作 | 0 |
送出數對了,佇列也空了。這條通知路徑沒有留下 ERROR 或送出失敗紀錄。如果監控只看這些訊號,很容易判成正常。
不過,上面四個數字都是發送端自己記的。它說「送出了」,另一端真的收到了嗎?
這個範例另外用一個獨立程序 FakeSink 扮演接收端。它每收到一則通知,就把通知 ID、訂單 ID、請求 ID 與時間寫進 receipts.jsonl。不用先懂這個檔名,把它當成接收端自己的收件簿就好:收到哪一筆,就記下哪一筆。
核對時,就拿前面那九筆真正取消的訂單,逐一找對應的通知紀錄。
但這輪等到結束,收件簿只留下三筆不同的通知紀錄,另外六筆找不到。
到這裡,才出現真正的矛盾:發送端記著九筆送出,接收端卻只記著三筆收到。光看這個落差,還不能直接說另外六筆丟了;也可能尚未送達,或紀錄不完整。接下來要沿著同一筆通知查,確認它到底停在哪裡。
九筆與三筆不相等,對帳程式就能指出來。接下來需要理解的是:少掉的六筆經過哪個分支?服務為什麼還把它們算成成功?這才是要請 Claude 對照程式與運行紀錄的地方。
這次備稿,我把通知契約、v1.0.0 程式副本與同一輪兩端紀錄交給 Claude,限定唯讀。我請它沿通知 ID 查去向,確認延後後是否真的會再執行,再核對成功計數在哪裡增加。同一份資料跑了 3 次,結果表放在這段追查之後。
第一輪回答以訂單 o-01 為例。下面依它附的來源重建查證過程,Log 保留歷史原件的 ID:
{"event":"cancel","order_id":"o-01","request_id":"missing-notification-r001","result":"ok","transitioned":true}
{"level":"INFO","event":"notify_deferred","order_id":"o-01","request_id":"missing-notification-r001","queue_depth":7}
第一筆說訂單取消成功。第二筆寫 notify_deferred,意思是「通知延後處理」。
看到這個名字,下一步應該是查:什麼時候再處理?重新排到哪裡?有沒有重試紀錄?
保存的逐筆追蹤找不到這筆通知後續的送出與接收紀錄。再對照當時的 NotificationWorker,問題出現了:
// v1.0.0 的關鍵片段,省略完整 Log 欄位
if (_f.DropOverQueue is int q && _ch.Reader.Count > q)
{
    _m.Inc("notify_sent_total");
    _log.Write(/* notify_deferred */);
    continue;
}
這是閱讀用節錄,看 continue 前那兩行。佇列太深時,程式先把「已送出」加一,記下「延後處理」,然後直接讀下一筆。中間沒有呼叫接收端,也沒有重新排隊。
Log 說晚一點做,程式卻沒有安排下一次。
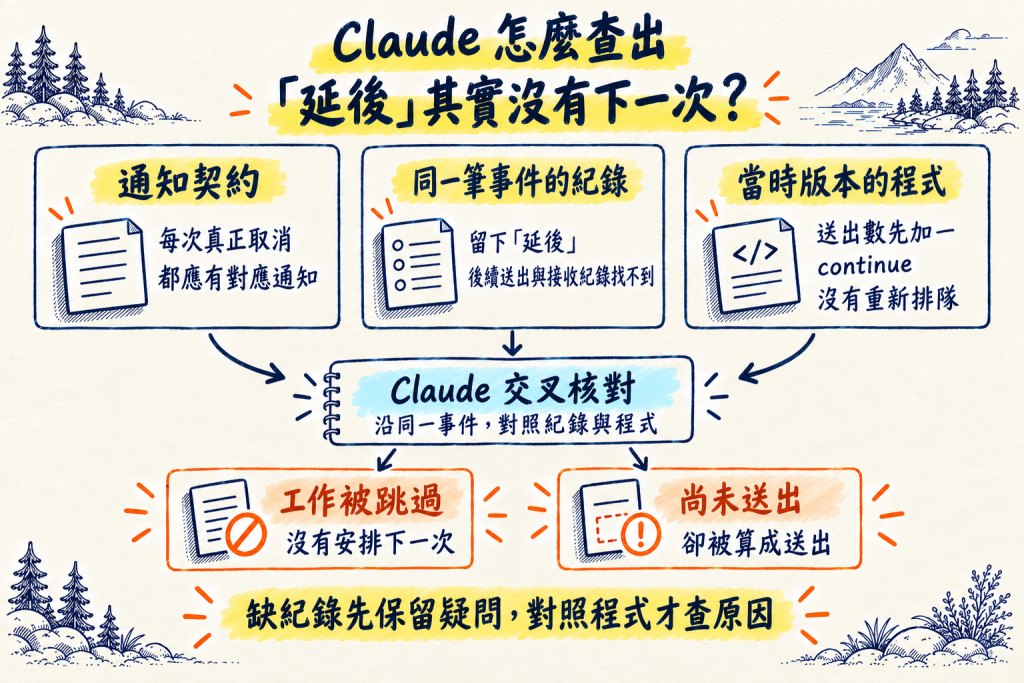
缺紀錄先留下疑問,再對照當時的程式,確認工作是否還有下一步。三份依據一起核對,才看出「延後」與「已送出」的矛盾。
佇列歸零是真的,只是有六筆工作被跳過。通知沒有送出,送出計數卻繼續增加;若只盯著錯誤紀錄,這六筆又都是 INFO。
數字和 Log 都有留下來,但它們描述的事情,跟程式真正做的事情不同。
3 次的結果如下。給它的副本已拿掉說明故障的註解,故障開關與紀錄裡的情境名稱也改成中性名稱,免得它讀名稱猜答案;扣掉這些,副本與 v1.0.0 原碼逐行一致。
| 第 1 次 | 第 2 次 | 第 3 次 | |
|---|---|---|---|
| 回合/秒數/費用 | 14/54.5/US$0.29 | 13/47.8/US$0.28 | 14/62.5/US$0.30 |
指出延後分支直接 continue,沒有下一次 |
是 | 是 | 是 |
指出 sent 在延後分支就加一(9=6 延後+3 實送) |
是 | 是 | 是 |
| 指出「佇列為零」的完成判定也被騙過 | 是 | 是 | 只提到預期筆數對不上 |
HTTP 重試寫在 continue 後面,這六筆走不到;成功計數則把六筆延後與三筆實際送出加在一起。它解釋了失敗為什麼被記成成功。 第 3 次還多看了一層:遺失的六則裡有退款通知,付了錢的人沒被告知退款;另外兩次沒提到這點。我對照原始 Log 確認:o-02、o-04、o-07 三筆取消都帶退款旗標,通知都沒有收據。
修法當時也由 Claude Code 提出並實作(見變更紀錄):延後的工作要有下一次,sent 也不能在尚未送出時增加。具體修法與重跑結果放在後面核對。
如果只把 notify_deferred 改成 ERROR,下次可能看得見紅字,通知仍然不會送到。要補的是處理方式,以及能核對處理結果的訊號。
回到這份演練的通知契約:每次真正取消,應有一則通知;重複取消不能多產生一則。這裡因此看九次狀態轉換,不看十五次 HTTP 200,另外六次是重複取消。
接著,把一筆通知的去向問清楚:
接下來看 Claude 留下的 v1.1.0 修改。它改的是背景工作的處理方式與計數位置,兩者都能從版本差異核對。
第一,延後要真的還有下一步。 需要延後時,通知重新排到隊尾,記錄已延後幾次;每則最多五次,到上限就進入實際送出流程。送出失敗另有有限次重試,仍失敗則進 dead_letter,也就是待處理的失敗工作。
第二,沒有送出,就不能算送出。 拿掉延後分支的 sent 累加,改成收到接收端成功回應後才增加。延後次數另外記在 notify_deferred_total。
五次延後是這版實作的設定,與送出失敗後的三次重試不同,也不是已獲 Owner 核准的服務承諾。
改完之後,不能只問「數字有沒有對上」。假設通知一筆都沒完成,送出零、接收零,也會相等。
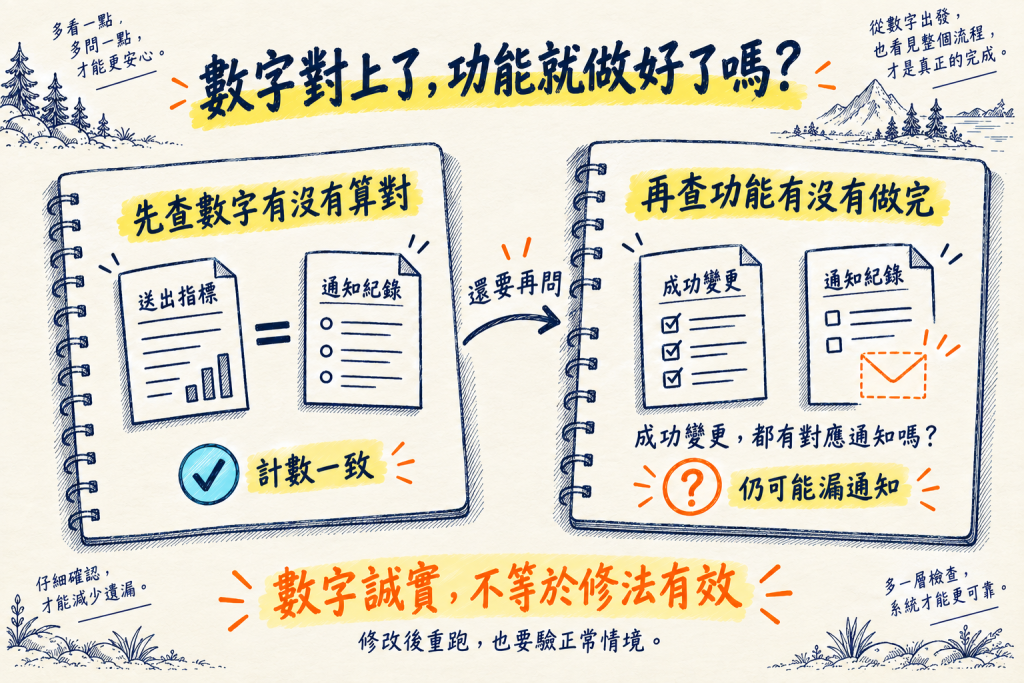
看右半:每次成功取消都要找得到對應通知,這一欄才決定修法能不能接受。
既有的 tools/check.py 會把請求、服務 Log、指標與接收紀錄放在一起,檢查成功取消數、唯一通知數、重複通知 ID,以及接收紀錄是否對得回請求。它是固定對帳程式,不由模型決定這次算不算過。
背景工作也要等到可判斷的時點。這批演練最多等三十秒,以佇列為零、接收紀錄連續三次輪詢未變作為結束條件,再做對帳。等完仍缺通知就失敗;逾時則留下未完成,不能都當正常。
修正版用同一份情境與故障設定重跑,結果如下。九筆取消不是新訂的低標,是修改前後都要守住的預期。
| 情境 | 版本 | 成功取消 | 自報送出 | 接收端唯一通知 | 對帳 |
|---|---|---|---|---|---|
| 正常對照 | v1.0.0 | 9 | 9 | 9 | PASS |
| 故障演練 | v1.0.0 | 9 | 9 | 3 | FAIL |
| 相同故障設定,修改後 | v1.1.0 | 9 | 9 | 9 | PASS |
| 正常情境回歸 | v1.1.0 | 9 | 9 | 9 | PASS |
這次九筆通知都收到,沒有重複通知 ID,正常情境也通過。
但紀錄裡多了一個值得看的數字:四十五次延後重排。
它不是四十五筆通知,是九筆工作在這輪壓力設定下,反覆延後的處理動作。過去這條路徑把跳過的工作算成成功;現在延後與送出分開,才有辦法繼續問:通知雖然到了,中間等了多久?這種負載下的等待能不能接受?
四十五次本身不能證明瓶頸,也不代表已達效能目標。九筆都收到,證明這次通知修好了;延後與送出分開記,則讓我們看見工作完成之前經過了什麼。 這是功能修復與觀測改善各自增加的一步。
這次修復同時改了通知行為與計數,不能把結果全算成「加了監控」。它支持的是這組故障下的修復與正常回歸,尚未驗到持續超載、重啟恢復,也沒有補送原先遺失的六筆。契約及修法目前仍是 proposed,通過演練後還有接受決策要做。
這次修復提醒我,完成條件也應該決定我們留下什麼訊號。 Day 6 問怎樣算完成,Day 10 畫出工作經過哪些地方;到了運行時,每一步也需要能核對的結果。
要把這種查法帶回自己的專案,可以先替 Claude 準備三組輸入。只有「九筆少了六筆」,它還不知道我們承諾了什麼,也不知道工作在哪裡消失。
| 給 Claude 看什麼 | 請它查什麼 | 本例要對回的地方 |
|---|---|---|
| 通知契約與流程圖 | 什麼才算完成?哪一步需要獨立來源? | 真正取消才產生通知,送達要看接收端紀錄 |
| 同一輪請求、Log、指標與接收紀錄 | 同一個 ID 走到哪裡,從哪一步失去紀錄? | o-01 留下「延後」,卻沒有後續送出與接收 |
| 該輪版本的 API、背景工作與接收端程式 | Log 的說法與實際分支一致嗎?計數何時增加? | 延後分支直接 continue,而且先把 sent 加一 |
Anthropic 的 AI-native SDLC Playbook 在 Maintain 階段,也把異常的證據與診斷交給 Claude 整理,由服務 Owner 決定如何處理,修復後再加入回歸案例。放回這次演練,就是讓 Claude 協助找原因,再用實際通知結果核對修法;是否接受,仍留給有權決定的人。官方 Playbook
可以從「API 回成功後,還有什麼沒做完」開始。挑一條通知、報表或背景同步流程,先照上表準備三組資料。記得用同一輪的版本:拿修正版程式解釋舊版紀錄,會查到不存在的原因。
沒報錯、佇列清空、送出數也對,都不等於工作完成。監控要能核對最終結果,修法要用同樣的故障重跑來驗。
這次是我把整理好的紀錄交給 Claude。下次只給它症狀,它能不能自己透過工具找到這些線索?明天 Day 24 從這裡接著查。
參考資料:
監控要看實際結果: Google SRE:Monitoring Distributed Systems,說明 HTTP 200 仍可能失敗,以及內部訊號與外部行為的核對。
Claude 在維運中的分工: Anthropic AI-native SDLC Playbook 的 Maintain 階段,說明證據、診斷、人工決策與修復後回歸。
案例與實跑結果: 教學包 days/day23/lab-notify:修正前後程式(v1.0.0/、v1.1.0/)、四次對帳結果(runs/)、固定對帳程式 tools/check.py 與重算步驟(README)。
Claude 如何查證: claude-run/(2026-10-07,Sonnet,只開 Read/Grep/Glob):提示、去洩漏步驟、工作目錄與 3 次完整輸出。第一版副本刪註解時誤刪一個左大括號,那 3 次另存於 first-copy-missing-brace/,不作為本文證據。
資料界線: 本機 .NET 教學演練,非正式環境事故;結果支持本次故障修復與正常回歸,不代表 Owner 已接受,也未證明人工省時。


 iThome鐵人賽
 看影片追技術